

Designing Data-Intensive Applications, глава 12: Потоковая обработка
Главная мысль: данные обычно не кончаются: пользователи создают новые события каждый день. Потоковая обработка (stream processing) разбирает каждое событие вскоре после того, как оно случилось, а не раз в сутки. Основа подхода — лог событий: его можно перечитать, а состояние любой системы можно вывести из этого лога.
О чём глава
Заголовок раздела «О чём глава»В главе 11 вход пакетной задачи был ограниченным (bounded): задача знает, когда дочитала его до конца. Например, сортировка в MapReduce не выдаст первую запись, пока не прочтёт весь вход. Но большинство данных неограниченные (unbounded): они приходят постепенно, и набор никогда не бывает «полным». Поэтому пакетная обработка режет данные на куски за сутки или за час, и результат появляется с опозданием. Если обрабатывать каждое событие сразу, получится потоковая обработка.
Поток (stream) — это данные, которые становятся доступны постепенно, со временем: stdin в Unix, TCP-соединение, видео в интернете. В главе речь идёт о потоках событий (event stream) как о способе управлять данными.
Темы главы:
- как передавать события: напрямую, через
message brokerв стиле AMQP/JMS и через брокер на основе лога; - как связаны базы данных и потоки:
CDC,event sourcing, неизменяемые события; - зачем обрабатывать потоки:
CEP, аналитика,materialized view, поиск; - как работать со временем:
event time, опоздавшие события, окна; - три вида
joinв потоках и отказоустойчивость.
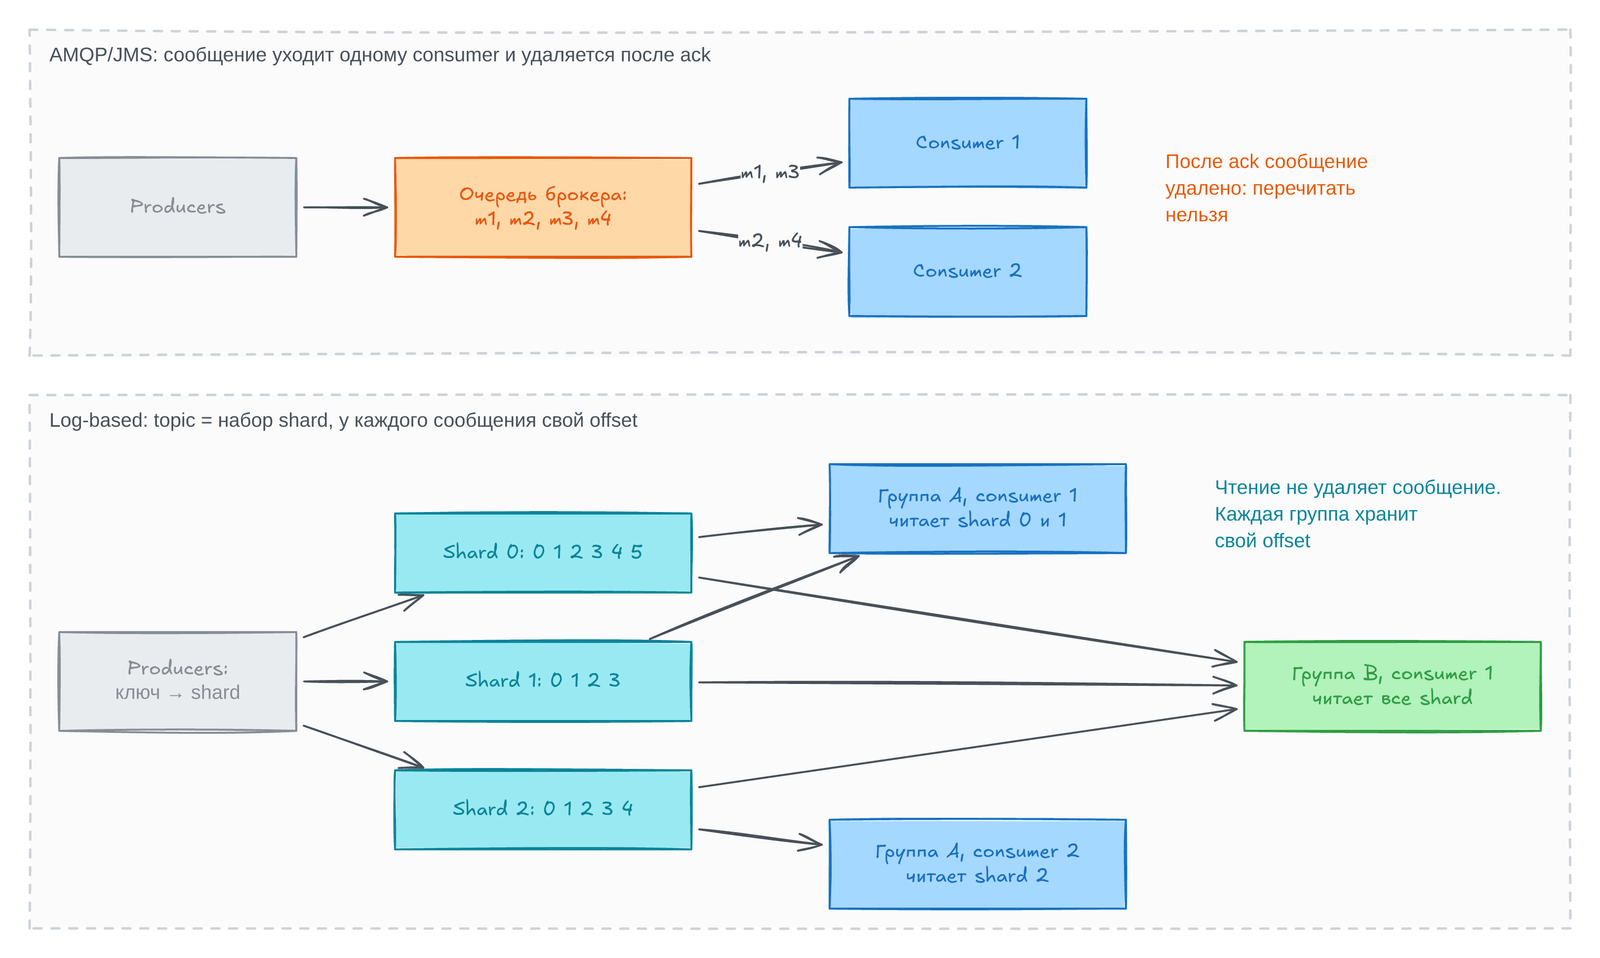
Сверху показан классический брокер: очередь раздаёт сообщения consumer по одному и удаляет их после подтверждения. Снизу — брокер на основе лога: topic делится на shard, а каждая группа consumer читает лог со своей позиции.
Передача потоков событий
Заголовок раздела «Передача потоков событий»В потоке запись обычно называют событием (event). Событие — это небольшой неизменяемый объект о том, что произошло в какой-то момент, обычно с меткой времени. Это может быть действие пользователя (просмотр страницы, покупка) или замер машины (температура, загрузка CPU). Событие кодируют в JSON или двоичный формат (глава 5), поэтому его можно сохранить или отправить по сети.
Событие создаёт один producer, а обрабатывать его могут несколько consumer. Связанные события объединяет topic — именованный поток, как имя файла объединяет записи в файловой системе.
Связать producer и consumer можно и обычной базой: consumer время от времени опрашивает её (polling) и ищет новые события. Но если нужна низкая задержка, частый опрос дорог: чем он чаще, тем меньше запросов находят что-то новое. Лучше, когда consumer получает уведомление. Базы умеют это плохо: триггеры очень ограничены, поэтому для уведомлений появились отдельные инструменты.
Системы сообщений
Заголовок раздела «Системы сообщений»Система сообщений (messaging system) доставляет сообщения от producer к consumer. В отличие от Unix pipe или TCP, она связывает нескольких отправителей и нескольких получателей одного topic (модель publish/subscribe). Чтобы сравнивать такие системы, авторы советуют задать два вопроса.
1. Что будет, если producer пишут быстрее, чем consumer читают? Можно отбросить сообщения, накопить их в очереди или включить backpressure, то есть заблокировать отправителя, как это делают pipe и TCP. Если очередь растёт, важно знать, что будет, когда она не влезет в память или заполнит диск.
2. Теряются ли сообщения, если узлы падают? Долговечность требует записи на диск или репликации, а это стоит денег. Для замеров датчиков одна потерянная точка не страшна. Но если вы считаете события, каждая потеря искажает счётчик. Авторы предупреждают, что массовые потери в метриках можно заметить не сразу.
Пакетная обработка из главы 11 даёт сильную гарантию: результат такой же, как если бы сбоев не было. Позже в главе мы увидим, как получить похожую гарантию в потоке.
Прямая передача сообщений
Заголовок раздела «Прямая передача сообщений»Некоторые системы передают сообщения напрямую, без промежуточных узлов. Биржевые котировки шлют по UDP multicast ради низкой задержки, а потерянные пакеты producer повторяет по запросу. ZeroMQ и nanomsg делают publish/subscribe без брокера. StatsD шлёт метрики по UDP, поэтому его счётчики в лучшем случае приблизительные. Webhook — это HTTP-вызов: один сервис регистрирует у другого свой URL, и тот вызывает его при каждом событии.
Такие системы требуют, чтобы приложение было готово к потере сообщений. Они предполагают, что producer и consumer всегда в сети. Если consumer отключён, он пропустит сообщения, а если упадёт producer, пропадёт его буфер для повторов.
Message broker
Заголовок раздела «Message broker»Чаще сообщения отправляют через message broker (его ещё называют message queue). По сути это база данных, оптимизированная под потоки сообщений. Producer и consumer подключаются к брокеру как клиенты. Данные хранятся в брокере, поэтому клиенты могут подключаться, отключаться и падать без потерь, а вопрос долговечности переходит к нему: одни брокеры держат сообщения в памяти, другие пишут на диск. С медленными consumer брокеры обычно копят очередь без ограничений.
Поэтому consumer работают асинхронно. Producer ждёт только подтверждения, что брокер принял сообщение, и не ждёт обработки. Доставка обычно занимает доли секунды, но при длинной очереди может занять намного больше.
Чем брокер отличается от базы данных
Заголовок раздела «Чем брокер отличается от базы данных»Некоторые брокеры даже участвуют в two-phase commit (глава 8), но от баз они всё же отличаются:
- Многие брокеры удаляют сообщение сразу после доставки, поэтому для долгого хранения не подходят.
- Брокеры рассчитаны на короткие очереди. Если сообщений накопилось много,
throughputпадает. - База умеет вторичные индексы и запросы, а брокер — только подписку на
topicпо шаблону имени. - Запрос к базе даёт снимок данных, и клиент не узнает, если потом данные изменятся. Брокер не умеет произвольных запросов, зато сам уведомляет о новых данных.
Это традиционный взгляд, закреплённый в стандартах JMS и AMQP. Так работают RabbitMQ, ActiveMQ, IBM MQ, Azure Service Bus, Google Cloud Pub/Sub и другие.
Несколько consumer
Заголовок раздела «Несколько consumer»Когда один topic читают несколько consumer, применяют два шаблона:
- Балансировка нагрузки (
load balancing). Каждое сообщение получает одинconsumer, и они делят работу. Это полезно, когда обработка дорогая и её нужно распараллелить. Fan-out. Каждое сообщение получают всеconsumer. Это аналог нескольких пакетных задач, которые читают один входной файл.
Шаблоны совмещает consumer group в Kafka. Внутри группы каждое сообщение получает один consumer, а две группы на одном topic получают каждая свою копию.
Подтверждения и повторная доставка
Заголовок раздела «Подтверждения и повторная доставка»Consumer может упасть посреди обработки. Поэтому брокер ждёт подтверждения (acknowledgment, ack) и только потом удаляет сообщение. Если подтверждения нет, брокер отдаёт сообщение другому consumer. Бывает, что сообщение обработано, а подтверждение потерялось; корректно разобрать этот случай поможет атомарный commit или идемпотентная операция.
Вместе с балансировкой повторная доставка меняет порядок. Пример из книги: consumer 2 падает на сообщении m3, брокер отдаёт его consumer 1, и тот обрабатывает m4, m3, m5. Чтобы порядок не нарушался, каждому consumer дают отдельную очередь. Для независимых сообщений порядок не важен, но для причинно связанных он важен.
Повторная доставка может и заблокировать поток. Если producer прислал битое сообщение, например JSON без обязательного ключа, consumer падает на нём снова и снова. Для этого есть dead letter queue (DLQ): брокер переносит такое сообщение в отдельную очередь, и работа идёт дальше. На DLQ ставят мониторинг, ведь любое сообщение в ней — ошибка. Оператор удаляет сообщение, исправляет его вручную или чинит код consumer. DLQ теперь есть и в Apache Pulsar, и в Kafka Streams.
Брокеры на основе лога
Заголовок раздела «Брокеры на основе лога»Брокеры AMQP/JMS унаследовали «временный» взгляд на сообщения: после доставки сообщение удаляется. Базы данных и файлы, наоборот, хранят записанное, пока его явно не удалят.
Эта разница важна для производных данных (derived data). Пакетную задачу можно запускать снова и снова, потому что вход не портится. С брокером AMQP/JMS так не выйдет: чтение разрушительно, и новый consumer получит только сообщения, отправленные после его подключения. Брокер на основе лога (log-based message broker) совмещает долговременное хранение базы и быстрые уведомления брокера.
Лог как хранилище сообщений
Заголовок раздела «Лог как хранилище сообщений»Лог — это последовательность записей на диске, в которую можно только дописывать. Он уже встречался в главах 4, 6 и 10. Producer дописывает сообщение в конец лога, а consumer читает лог по порядку и, дойдя до конца, ждёт новых сообщений, как tail -f.
Чтобы получить больший throughput, лог делят на shard (глава 7) на разных машинах. Topic — это группа shard с сообщениями одного типа. В каждом shard (в Kafka он называется partition) сообщение получает возрастающий номер — offset. Внутри shard сообщения полностью упорядочены, а между разными shard порядок не гарантирован. Так работают Apache Kafka и Amazon Kinesis Streams. Они пишут всё на диск, но обрабатывают миллионы сообщений в секунду за счёт sharding и репликации.
Лог и традиционные очереди
Заголовок раздела «Лог и традиционные очереди»Лог легко даёт fan-out, ведь чтение не удаляет сообщение. Для балансировки брокер назначает узлам группы целые shard, и каждый узел читает свои shard по порядку в одном потоке. У этого два минуса:
- Узлов в группе не может быть больше, чем
shard. - Медленное сообщение задерживает все следующие в своём
shard(head-of-line blocking).
Поэтому брокер AMQP/JMS лучше, когда обработка дорогая и порядок не важен. Лог лучше, когда поток большой, сообщения обрабатываются быстро и порядок важен. Правда, граница размывается: Kafka теперь умеет группы, где несколько consumer читают один partition.
Порядок сохраняется только внутри shard. Поэтому события, которым нужен общий порядок, например события одного пользователя, отправляют с одним ключом shard, скажем с ID пользователя.
Offset consumer
Заголовок раздела «Offset consumer»Раз shard читают по порядку, брокеру не нужно хранить подтверждение каждого сообщения. Всё, что левее offset consumer, уже обработано, поэтому достаточно время от времени записывать offset. Это снижает накладные расходы и повышает throughput. Но после падения consumer продолжит с последнего записанного offset, и часть сообщений обработается дважды.
Offset похож на номер позиции в логе репликации (глава 6): по нему follower продолжает репликацию после разрыва связи. Брокер здесь ведёт себя как leader, а consumer — как follower.
Место на диске
Заголовок раздела «Место на диске»Чтобы диск не кончился, лог делят на сегменты, а старые сегменты удаляют или переносят в архив. Если consumer отстанет так, что его offset укажет на удалённый сегмент, он пропустит сообщения. По сути лог — это очень большой кольцевой буфер (ring buffer) на диске.
Авторы дают прикидку. Диск на 20 TB при последовательной записи 250 MB/s заполнится примерно за 22 часа. Значит, лог хранит минимум 22 часа сообщений, а на практике, при неполной загрузке диска, — дни и недели.
Многие брокеры теперь хранят сообщения в объектном хранилище (object storage). Kafka и Redpanda отдают оттуда старые сообщения (tiered storage), а WarpStream, Confluent Freight и Bufstream хранят там всё. Это дешевле и упрощает интеграцию: сообщения лежат как таблицы Iceberg, и хранилище данных читает их без копирования.
Когда consumer не успевают за producer
Заголовок раздела «Когда consumer не успевают за producer»Лог — это большой буфер, но фиксированного размера. Если consumer отстал дальше этого буфера, старые сообщения для него потеряны. Отставание можно мониторить и поднимать тревогу, и у оператора обычно есть время починить медленный consumer. Даже если consumer отстал слишком сильно, страдает только он. Поэтому боевой лог можно спокойно читать для отладки и тестов, а остановленный consumer ничего не тратит: от него остаётся только offset. В традиционном брокере очереди остановленных consumer приходится удалять, иначе они отнимают память.
Повторное чтение старых сообщений
Заголовок раздела «Повторное чтение старых сообщений»В логе чтение не меняет данные: единственный побочный эффект — сдвиг offset, а им управляет сам consumer. Можно запустить копию consumer со вчерашнего offset, писать вывод в другое место и так заново обработать последние сутки, сколько угодно раз меняя код. Здесь лог похож на вход пакетной задачи: его можно обрабатывать заново без потерь, поэтому проще экспериментировать и восстанавливаться после багов.
Базы данных и потоки
Заголовок раздела «Базы данных и потоки»Брокеры на основе лога взяли идеи у баз данных. Можно и наоборот: перенести идеи сообщений и потоков в базы данных. Один способ — event sourcing (глава 3): каждое изменение состояния записывают как неизменяемое событие в лог, а все materialized view выводят из лога. Для этого хорошо подходит брокер на основе лога, который никогда не удаляет события.
Но потоки полезны базам и без event sourcing, ведь каждая запись в базу — событие. Лог репликации (глава 6) — это поток записей от leader, который follower применяют к своей копии. Принцип репликации конечного автомата (state machine replication, глава 10) говорит то же: реплики, которые детерминированно обрабатывают одни события в одном порядке, приходят в одно состояние.
Синхронизация систем
Заголовок раздела «Синхронизация систем»Реальные приложения сочетают несколько систем: OLTP-базу, кэш, полнотекстовый индекс и хранилище данных (data warehouse). У каждой своя копия данных, и их нужно синхронизировать. В хранилище данные обычно приносит ETL пакетом. Если это слишком медленно, иногда применяют dual writes: приложение само пишет в базу, потом в поисковый индекс, потом сбрасывает кэш.
У dual writes две серьёзные проблемы. Первая — гонка (race condition). Два клиента одновременно записывают значение X: один — A, другой — B. База получает A, потом B, а индекс из-за неудачного совпадения — B, потом A. Системы навсегда разошлись, хотя ошибок не было, и без механизма вроде version vector этого никто не заметит. Вторая проблема: одна запись может пройти, а другая упасть, и для защиты нужен дорогой атомарный commit.
Корень проблемы в том, что у базы и индекса свои leader, и ни одна система не следует за другой. Было бы лучше, если бы leader был один, а индекс стал follower базы.
Change data capture
Заголовок раздела «Change data capture»Долгое время лог репликации считался внутренней деталью базы, а не публичным API, и документированного способа получить изменения у многих баз не было. Теперь растёт интерес к change data capture (CDC). CDC — это процесс, который наблюдает за всеми изменениями данных в базе и отдаёт их в форме, удобной для репликации в другие системы, лучше всего потоком сразу после записи. Если применять изменения к поисковому индексу в том же порядке, индекс совпадёт с базой. Индекс и другие производные системы становятся просто consumer потока изменений.
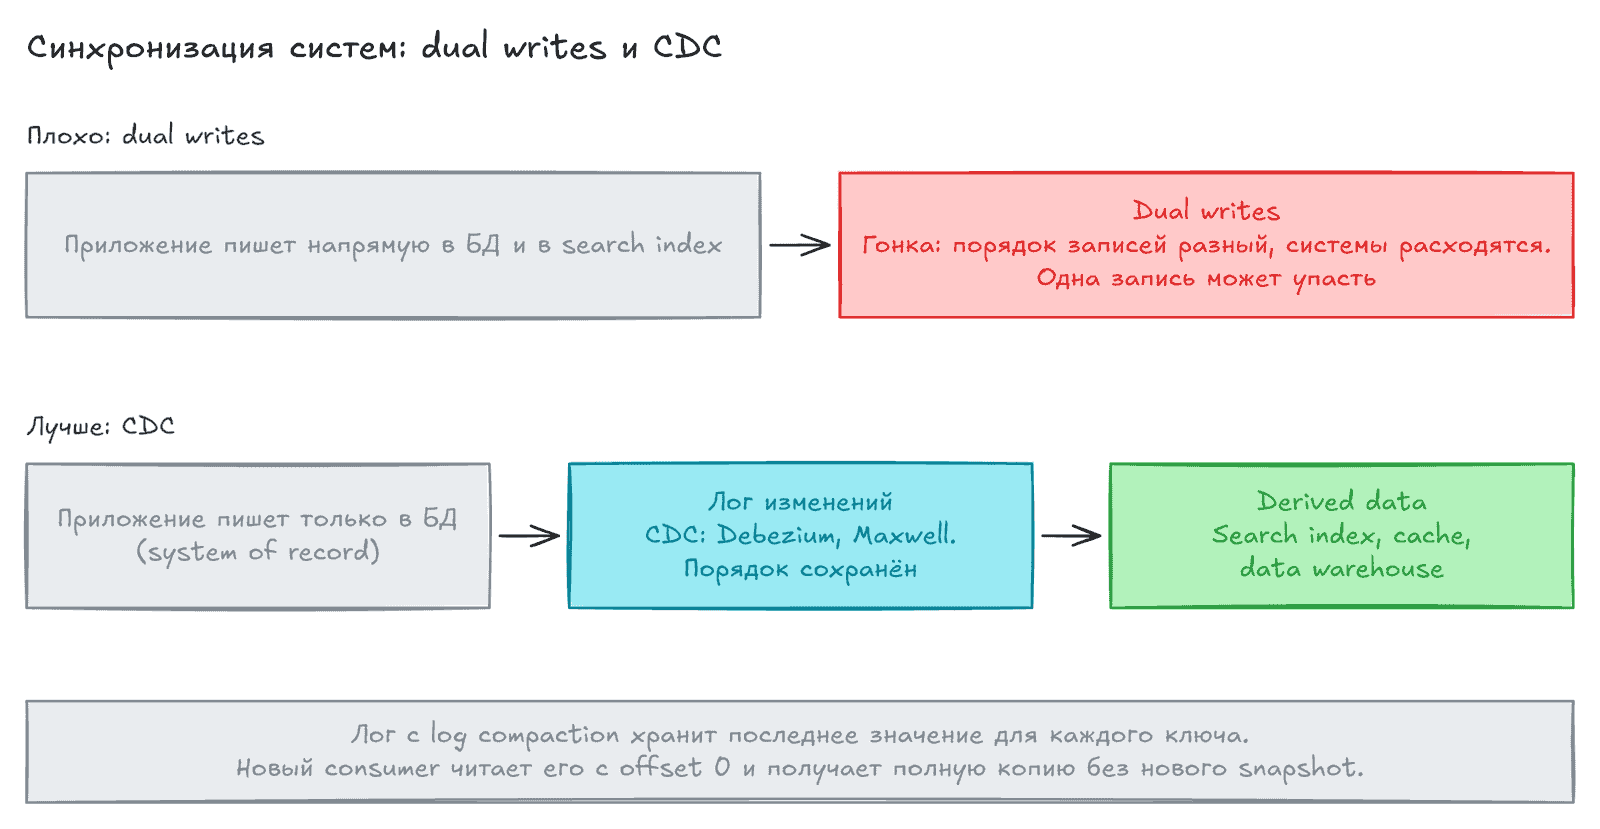
Схема показывает, как CDC убирает гонку. Даже если записи A и B пришли одновременно, база сама выбирает их порядок и в этом порядке пишет их в лог. Индекс применяет их в том же порядке, а новую систему, например хранилище данных, можно добавить ещё одним consumer.
Как реализуют CDC
Заголовок раздела «Как реализуют CDC»По сути CDC делает базу-источник (system of record) единственным leader, а производные системы — её follower. Для доставки изменений хорошо подходит брокер на основе лога, потому что он сохраняет порядок.
CDC строят на логическом логе репликации (глава 6), но приходится решать трудности: как обработать изменение схемы и как правильно описать обновление записи. Это делает открытый Debezium с коннекторами для MySQL, PostgreSQL, Oracle, SQL Server, Db2, Cassandra и других баз: он читает лог репликации и выдаёт изменения в стандартной схеме событий. Есть и другие инструменты: коннекторы Kafka Connect, Maxwell для binlog MySQL, GoldenGate для Oracle, pgcapture для PostgreSQL.
CDC обычно асинхронный: база не ждёт consumer. Поэтому медленный consumer не тормозит источник, но появляются все проблемы лага репликации (replication lag).
Начальный snapshot
Заголовок раздела «Начальный snapshot»Хранить все изменения вечно слишком дорого, поэтому лог обрезают. Но новому полнотекстовому индексу нужна полная копия базы, а не только недавние изменения. Значит, нужно начать с согласованного снимка (snapshot), который привязан к известной позиции в логе, и применять изменения с этой позиции. Одни инструменты делают снимок сами, в других это ручная работа. Debezium делает инкрементальные снимки по алгоритму DBLog от Netflix, основанному на watermark.
Log compaction
Заголовок раздела «Log compaction»Альтернатива повторным снимкам — log compaction, уже знакомый по движкам хранения (глава 4). Движок в фоне находит записи с одним ключом и оставляет только последнее значение каждого ключа.
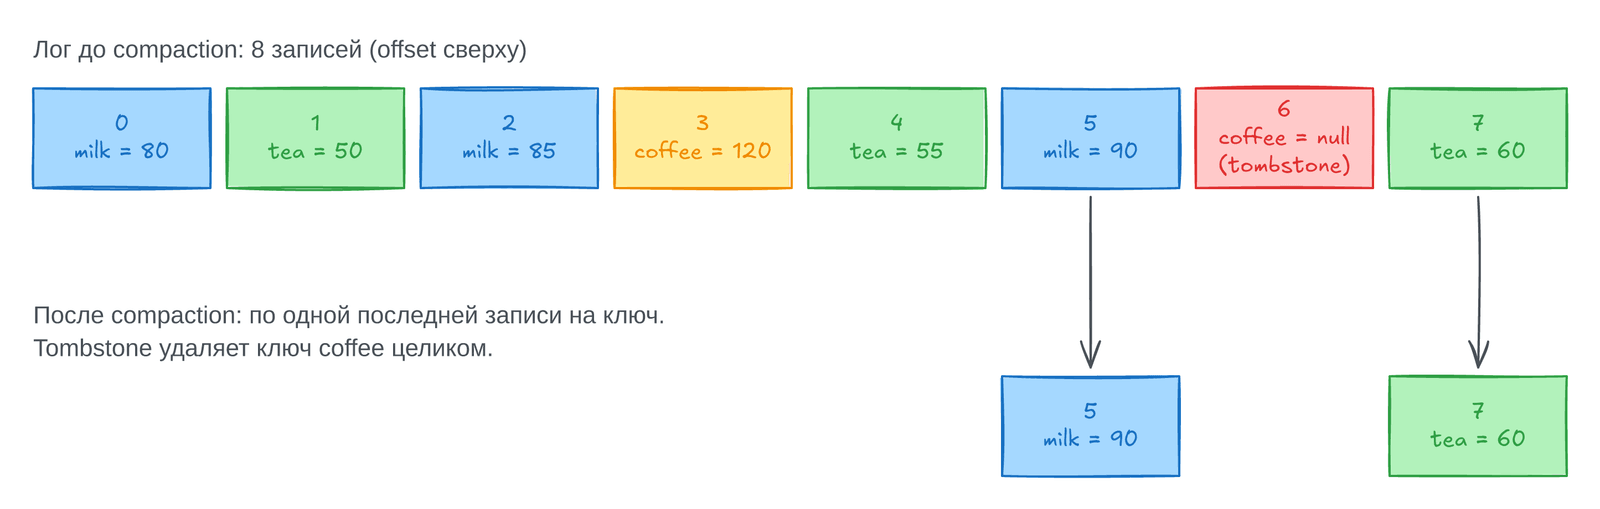
Сверху лог до compaction, снизу — после. Запись со значением null (tombstone) означает удаление ключа, и при compaction ключ исчезает совсем. Поэтому размер лога зависит только от текущего содержимого базы, а не от числа всех записей за историю.
С CDC это работает так же, если у каждого изменения есть первичный ключ и новая запись заменяет старую. Чтобы перестроить поисковый индекс, достаточно запустить новый consumer с offset 0 и прочитать весь topic: там есть последнее значение каждого ключа. Новый снимок исходной базы не нужен. Kafka поддерживает log compaction, и поэтому её можно использовать как долговременное хранилище.
API для потоков изменений
Заголовок раздела «API для потоков изменений»Сейчас большинство популярных баз дают поток изменений как полноценный интерфейс. MySQL и PostgreSQL отдают изменения через свой лог репликации, а облака предлагают свои сервисы, например Datastream в Google Cloud.
CDC поддерживает даже Cassandra, хотя для кворумной базы это трудно: нет единого источника правды, ведь видимость записи зависит от настроек читателя. Поэтому Cassandra отдаёт сырые сегменты лога каждого узла, а consumer сам сливает их в один поток, как кворумный читатель. Kafka Connect собирает инструменты CDC для многих баз в Kafka, откуда изменения идут в индексы и потоковую обработку.
CDC и event sourcing
Заголовок раздела «CDC и event sourcing»Event sourcing тоже хранит все изменения как лог событий, но на другом уровне абстракции:
- При
CDCприложение свободно обновляет и удаляет записи в базе, а изменения достают из лога базы на низком уровне. Порядок в логе совпадает с реальным, и гонки нет. - При
event sourcingприложение явно построено на неизменяемых событиях, которые описывают действия на уровне приложения, а не изменения строк.
Переход на event sourcing — большая перемена (глава 3), а CDC можно добавить к существующей базе почти незаметно для приложения.
Log compaction в этих подходах тоже работает по-разному. Событие CDC содержит всю новую версию записи, поэтому старые события по тому же ключу можно выбросить. Событие event sourcing выражает намерение пользователя, поздние события не заменяют ранние, и для восстановления нужна вся история. Снимки состояния в event sourcing — лишь оптимизация: задумано, что система хранит все сырые события вечно.
CDC и схемы баз данных
Заголовок раздела «CDC и схемы баз данных»У CDC есть своя трудность. В микросервисах базу видит только её сервис, а другие ходят через его API, поэтому схему базы можно менять свободно. Но CDC переносит данные в схеме исходной базы, и схема превращается в публичный API. Удалили столбец — и сломались consumer. Раньше это задевало в основном ETL хранилища, а теперь consumer могут быть боевыми сервисами, и сбой увидят клиенты. Чтобы этого избежать, вводят data contract — договор о схеме между источником и consumer.
Обычный способ отделить внутреннюю схему от внешней — паттерн outbox. Outbox — это отдельная таблица со своей схемой, которую видит CDC. Внутренние таблицы можно менять, а outbox остаётся прежней. Это тоже dual writes, но обе записи идут в одну базу и попадают в одну транзакцию. Минусы такие: преобразование в схему outbox нужно поддерживать, а база пишет больше данных.
Пояснение: в коде это выглядит так: в одной транзакции сервис делает
UPDATE orders ...иINSERT INTO orders_outbox .... Debezium читает толькоorders_outbox, поэтому внутреннюю таблицуordersможно менять свободно.
Состояние, потоки и неизменяемость
Заголовок раздела «Состояние, потоки и неизменяемость»Пакетная обработка выигрывала от неизменяемого входа, и тот же принцип делает сильными event sourcing и CDC. Но база хранит текущее состояние, а состояние меняется. Как это сочетается с неизменяемостью?
Любое состояние — результат событий, которые его меняли. Баланс счёта — результат поступлений и списаний, список свободных мест — результат бронирований. Даже если действие отменили, факт остаётся: событие было. Поэтому изменяемое состояние и лог неизменяемых событий не противоречат друг другу, а дополняют друг друга. Лог всех изменений (changelog) показывает, как состояние менялось со временем. Авторы сравнивают это с математикой: состояние — интеграл потока событий по времени, а поток — производная состояния.
Если считать лог system of record, а состояние производным от него, проще понять, как данные текут через систему. Джим Грей и Андреас Ройтер ещё в 1992 году писали, что базу можно вообще не хранить: в логе есть вся информация, а база нужна только ради скорости чтения.
Плюсы неизменяемых событий
Заголовок раздела «Плюсы неизменяемых событий»Бухгалтеры веками ведут главную книгу (ledger), куда можно только дописывать, а баланс выводят из её записей. Ошибку не стирают, а исправляют компенсирующей записью, и неверная запись остаётся для аудита.
Это полезно не только в финансах. Если баг записал в базу плохие данные, с логом неизменяемых событий проще понять, что случилось, и всё восстановить. К тому же события хранят больше информации, чем состояние. Например, покупатель положил товар в корзину и убрал его: для заказа это ничего не меняет, но аналитику важно, что покупатель думал о товаре.
Несколько представлений из одного лога
Заголовок раздела «Несколько представлений из одного лога»Из одного лога можно вывести несколько представлений для чтения, как несколько consumer одного потока. Например, Druid читает данные прямо из Kafka, а Kafka Connect выгружает их в разные базы. Для новой функции можно построить новое представление рядом со старыми и не делать сложную миграцию схемы, а когда все перешли на новое, старое выключить. Для этого не нужен event sourcing: несколько materialized view можно построить и из потока CDC.
Авторы считают заблуждением идею, что данные нужно писать в той же форме, в которой их читают. Если есть шаг перевода из лога в представление для чтения, споры о нормализации теряют остроту: денормализовать представления можно смело, ведь лог держит их в согласии. Пример — лента соцсети из главы 2: пост копируется в ленты всех подписчиков, но сервис fan-out поддерживает эти копии в актуальном виде.
Управление конкурентностью
Заголовок раздела «Управление конкурентностью»Такое разделение формы для записи и формы для чтения называют CQRS. Главный минус CQRS — асинхронность: пользователь записал событие, а в представлении его ещё нет (это проблема чтения своих записей из главы 6). Синхронное обновление требует распределённой транзакции, и на практике его обычно не делают.
Зато лог упрощает конкурентность. В event sourcing одно действие пользователя можно описать одним событием, и тогда нужна одна атомарная запись в лог вместо транзакции по нескольким объектам. Если лог и состояние разбиты на shard одинаково, однопоточный consumer обрабатывает события shard по очереди и обходится без блокировок. Случай, когда событие затрагивает несколько shard, разбирает глава 13. Неизменяемость для конкурентности используют и в других местах: многоверсионные данные для snapshot isolation (глава 8) и история в Git.
Пределы неизменяемости
Заголовок раздела «Пределы неизменяемости»Хранить всю историю вечно легко, когда данные в основном добавляют. Если же небольшой набор часто меняют, история становится огромной, и от compaction и сборки мусора начинает зависеть стабильная работа системы.
Бывают и юридические причины удалять данные: GDPR требует по запросу удалить личные данные. Тогда мало дописать событие об удалении, нужно переписать историю. В Datomic это называется excision, в Fossil — shunning. Удалить данные по-настоящему трудно: SSD и файловые системы пишут на новое место, а резервные копии часто специально неизменяемы.
Один приём — crypto-shredding: данные хранят зашифрованными, а для удаления уничтожают ключ. Но проблема просто переезжает в хранилище ключей. Кроме того, заранее нужно решить, какие данные шифровать одним ключом, ведь уничтожить можно только все данные ключа сразу. В итоге удаление скорее затрудняет доступ к данным, чем делает их недоступными совсем. И всё же иногда удалять приходится (глава 14).
Обработка потоков
Заголовок раздела «Обработка потоков»С потоком можно сделать три вещи:
- Записать события в базу, кэш или поисковый индекс, где их прочитают другие клиенты.
- Показать события людям: письмо, push-уведомление, дашборд в реальном времени.
- Обработать входные потоки и получить новые выходные. Поток может пройти цепочку таких шагов, прежде чем дойдёт до варианта 1 или 2.
Дальше речь идёт о варианте 3. Код, который так обрабатывает потоки, называют оператором (operator) или задачей (job). Обработчик потока (stream processor) только читает вход и только дописывает вывод, как задачи MapReduce. Sharding, распараллеливание и простые преобразования устроены так же, как в главе 11.
Главное отличие в том, что поток никогда не кончается. Поэтому сортировка бесполезна и sort-merge join использовать нельзя. Отказоустойчивость тоже другая: задачу, которая работает годами, после сбоя с начала не перезапустишь.
Зачем нужна потоковая обработка
Заголовок раздела «Зачем нужна потоковая обработка»Давно потоковую обработку используют для мониторинга. Антифрод блокирует карту, если характер трат резко изменился. Биржевые системы совершают сделки по правилам. Заводские системы находят поломку станка, а военные поднимают тревогу при признаках атаки. Всем им нужен сложный поиск шаблонов, но со временем появились и другие применения.
Complex event processing
Заголовок раздела «Complex event processing»Complex event processing (CEP) — подход 1990-х годов: он ищет в потоке шаблоны событий, как регулярное выражение ищет шаблон в строке. Шаблоны пишут на языке, похожем на SQL, а движок держит конечный автомат и при совпадении выдаёт сложное событие (complex event).
В CEP роли данных и запросов перевёрнуты. Обычная база хранит данные, а запрос забывает после ответа. CEP хранит запросы долго и проверяет против них каждое новое событие. Примеры движков — Esper, Apama, TIBCO StreamBase, а Flink и Spark Streaming тоже поддерживают SQL для потоков.
Потоковая аналитика
Заголовок раздела «Потоковая аналитика»Аналитику меньше интересуют конкретные последовательности и больше — агрегаты: частота событий за интервал, скользящее среднее, сравнение с прошлой неделей. Обычно их считают за фиксированный интервал, например среднее число запросов в секунду и p99 времени ответа за последние 5 минут. Такой интервал называют окном (window).
Иногда аналитика использует вероятностные алгоритмы: Bloom filter, HyperLogLog, оценки перцентилей. Они экономят память, но дают приблизительный ответ. Авторы подчёркивают, что потоковая обработка сама по себе не обязана быть неточной: вероятностные алгоритмы — лишь оптимизация. Для аналитики создавались Apache Storm, Spark Streaming, Flink, Samza, Apache Beam, Kafka Streams и облачные Google Cloud Dataflow и Azure Stream Analytics.
Поддержка materialized view
Заголовок раздела «Поддержка materialized view»Поток изменений может держать актуальными кэши, индексы и хранилища. Это поддержка materialized view — представления данных для быстрых запросов, которое обновляется при каждом изменении источника. Состояние в event sourcing — тоже materialized view. Здесь короткого окна мало: нужны все события с начала времён, кроме выброшенных log compaction. Аналитические фреймворки на это не рассчитаны, а Kafka Streams и ksqlDB поддерживают такой режим через log compaction в Kafka.
Инкрементальная поддержка представлений
Заголовок раздела «Инкрементальная поддержка представлений»Базы умеют materialized view, но обычно обновляют их пакетом по расписанию или по команде, как REFRESH MATERIALIZED VIEW в PostgreSQL. Это плохо по двум причинам: каждый раз пересчитываются все данные, хотя изменилась малая часть, и до следующего запуска данные несвежие. Триггер может, например, обновлять только строку выручки за нужный день, но многие SQL-запросы так по частям не пересчитать.
Общее решение — инкрементальная поддержка представлений (incremental view maintenance, IVM). IVM превращает SQL-запрос в операторы, которые пересчитывают только изменившиеся данные. Поэтому представление можно обновлять намного чаще. Так работают Materialize, RisingWave, ClickHouse и Feldera: новые события копятся в памяти и периодически применяются к представлениям на диске. При чтении система объединяет свежие события из памяти и представление с диска. Представления хранятся в формате в стиле OLAP, поэтому такие системы выполняют и крупные аналитические запросы.
Поиск по потоку
Заголовок раздела «Поиск по потоку»Иногда нужно искать отдельные события по сложным условиям. Сервис мониторинга СМИ заранее сохраняет запросы о компаниях и сверяет с ними поток новостей. Сайт недвижимости присылает уведомление о новом объекте под ваш поиск. Для этого есть, например, percolator в Elasticsearch. Здесь, как в CEP, хранятся запросы, а документы проверяют против них. Если запросов много, индексируют и сами запросы, чтобы быстро сузить круг совпадений.
Событийная архитектура и RPC
Заголовок раздела «Событийная архитектура и RPC»Модель акторов (actor model) тоже передаёт сообщения (глава 5), но потоковой обработкой её не считают. Акторы прежде всего управляют конкурентностью, а потоковая обработка — данными. Общение акторов обычно временное и один на один, а лог долговечен и у него много подписчиков. Кроме того, акторы могут общаться циклами «запрос — ответ», а обработчики потоков собирают в ациклический pipeline. Пересечения есть: в Apache Storm запросы пользователей можно обрабатывать вместе с потоками событий (distributed RPC). Обрабатывать потоки акторами тоже можно, но многие такие фреймворки не гарантируют доставку при сбоях.
Работа со временем
Заголовок раздела «Работа со временем»Окно «за последние пять минут» кажется ясным, но работать со временем в потоках сложно. Пакетная задача берёт время из метки внутри события, ведь часы машины, на которой она идёт, не связаны со временем событий. Поэтому пакет детерминирован: повторный запуск даёт тот же результат. А многие потоковые фреймворки строят окна по локальным часам обработчика, то есть по времени обработки (processing time). Это просто и работает, пока задержка мала, но ломается при заметном отставании.
Event time и processing time
Заголовок раздела «Event time и processing time»Обработка задерживается из-за очередей, сбоев сети, перезапуска consumer или повторной обработки после бага. Задержки ещё и путают порядок: событие второго запроса пользователя может прийти в брокер раньше события первого.
Авторы приводят аналогию со «Звёздными войнами». Эпизоды IV–VI вышли в 1977–1983 годах, эпизоды I–III — в 1999–2005, а VII–IX — в 2015–2019. Номер эпизода — это время события (event time), а дата просмотра в кино — время обработки. Люди легко справляются с таким разрывом, а потоковые алгоритмы нужно писать с учётом этого специально.
Если путать два вида времени, данные получатся неверными. Пусть обработчик считает запросы в секунду и после деплоя минуту не работал. По processing time будет виден резкий всплеск запросов, хотя на деле поток был ровным. Этот эффект можно увидеть в задании 1 практики ниже.
Опоздавшие события
Заголовок раздела «Опоздавшие события»Окно по event time нельзя закрыть с полной уверенностью: событие могло застрять в буфере другой машины. Пусть вы считаете запросы по минутам, а новые события уже относятся к 38-й и 39-й минутам. Когда выдать итог 37-й минуты? Можно закрыть окно по тайм-ауту, но тогда нужно решить, что делать с опоздавшими событиями (straggler events):
- игнорировать их, но считать метрику отброшенных и поднимать тревогу, если их много;
- опубликовать поправку с новым значением окна и, возможно, отозвать старое.
Иногда producer шлёт особую отметку «событий раньше t больше не будет», и по ней закрывают окна (это watermark). Но если producer много, за каждым приходится следить отдельно.
Чьи это часы?
Заголовок раздела «Чьи это часы?»Мобильное приложение может копить события без сети и отправить их через часы или дни. Метка события должна отражать время действия пользователя, но часам телефона нельзя доверять (глава 9). Часы сервера надёжнее, но говорят только о времени получения. Поэтому записывают три метки: время события по часам устройства, время отправки по часам устройства и время получения по часам сервера. Разница двух последних даёт сдвиг часов устройства, если сетевая задержка мала, и этим сдвигом поправляют время события.
Пояснение: пример. Событие по часам телефона произошло в 12:00 и было отправлено в 12:30, а сервер получил его в 12:45. Сдвиг равен 15 минутам, поэтому настоящее время события — около 12:15.
Пакетная обработка страдает от тех же проблем, просто в потоке ход времени заметнее.
Типы окон
Заголовок раздела «Типы окон»Окно используют для агрегации: посчитать события или найти среднее. Распространены четыре типа:
Tumbling window— окна фиксированной длины без перекрытия: каждое событие попадает ровно в одно окно, например с 10:03:00 по 10:03:59. Номер окна получают, округляя метку вниз до минуты.Hopping window— окна фиксированной длины с перекрытием, например пять минут с шагом в минуту. Их собирают из соседних минутныхtumbling-окон.Sliding window— все события в пределах интервала друг от друга. События в 10:03:39 и 10:08:12 попадут в одно пятиминутное скользящее окно, хотя окна с фиксированными границами их разделят. Для него держат буфер событий по времени.Session window— события одного пользователя без долгих пауз. Окно закрывается, например, после 30 минут без активности. Это частая задача веб-аналитики.
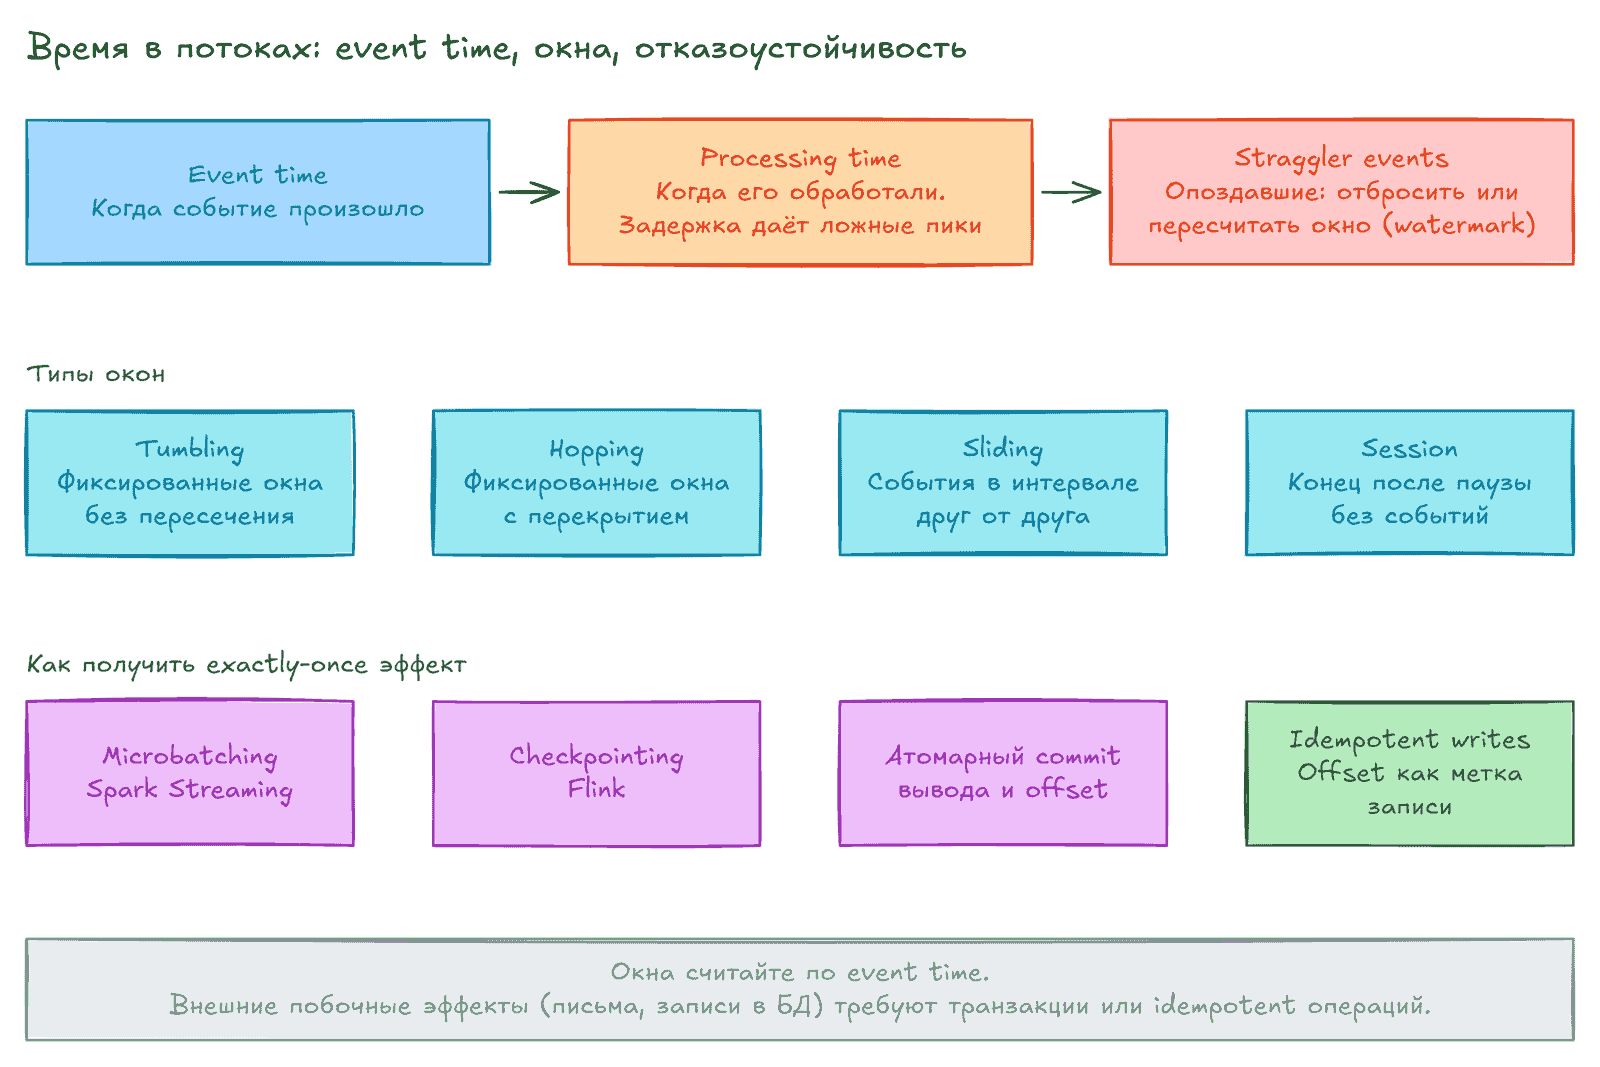
Схема собирает вместе темы второй половины главы: два вида времени, четыре типа окон и способы получить exactly-once, о которых речь пойдёт ниже.
Окнам нужно временное состояние. Для счётчика хватит одного числа, но скользящие окна и join держат в буфере все события окна. Поэтому большие окна и высокий throughput требуют много памяти или диска.
Join в потоках
Заголовок раздела «Join в потоках»Join — важная часть pipeline в пакетной обработке, и в потоках он нужен так же. Но события приходят в любой момент, поэтому join сложнее. Авторы различают три вида: поток с потоком, поток с таблицей и таблица с таблицей.
Stream–stream join (оконный join)
Заголовок раздела «Stream–stream join (оконный join)»Пусть вы хотите знать CTR (долю кликов) по результатам поиска на сайте. Событие поиска и событие клика пишутся отдельно, а связывает их ID сессии. Клик может не случиться вовсе, прийти через секунды или через неделю и даже раньше события поиска. Поэтому выбирают окно, например соединять клик с поиском не дальше часа. Встроить данные поиска в клик нельзя: так потеряются поиски без кликов, а без них долю кликов не посчитать.
Обработчик держит состояние: события за последний час в двух индексах по ID сессии, для поисков и для кликов. Новое событие он кладёт в свой индекс, ищет пару в другом индексе и выдаёт результат «кликнули» при совпадении или «не кликнули», когда поиск устарел без клика.
Stream–table join (обогащение потока)
Заголовок раздела «Stream–table join (обогащение потока)»К потоку действий пользователей часто добавляют данные профиля из базы. Это обогащение (enrichment) событий. Запрос к удалённой базе на каждое событие медленный и может её перегрузить. Поэтому копию базы держат в обработчике и ищут локально (hash join). Пакетная задача взяла бы снимок базы, а обработчик потока работает долго, и копию нужно обновлять. Это делает CDC: обработчик читает changelog профилей вместе с потоком действий. Для changelog окно бесконечное, и новые версии записей заменяют старые.
Table–table join (поддержка materialized view)
Заголовок раздела «Table–table join (поддержка materialized view)»Вернёмся к ленте соцсети. Вместо сборки ленты при каждом чтении держат кэш — «почтовый ящик» пользователя. Новый пост добавляют в ленты всех подписчиков, удалённый — убирают. При подписке в ленту попадают недавние посты автора, при отписке — исчезают. Для этого нужны потоки постов и подписок, а обработчик хранит списки подписчиков.
По сути это materialized view для запроса, который соединяет таблицы постов и подписок. В книге запрос написан для PostgreSQL. Вот наш вариант на DuckDB с маленькими данными:
CREATE TABLE posts AS SELECT * FROM (VALUES    (1, 'olga', 'Запустили Kafka', TIMESTAMP '2026-11-15 09:00:00'),    (2, 'ivan', 'CDC работает', TIMESTAMP '2026-11-15 09:30:00'),    (3, 'olga', 'Перешли на Flink', TIMESTAMP '2026-11-15 10:00:00')) AS t(post_id, sender_id, body, ts);
CREATE TABLE follows AS SELECT * FROM (VALUES    ('anna', 'olga'), ('anna', 'ivan'), ('boris', 'olga')) AS t(follower_id, followee_id);
-- Timeline каждого пользователя: посты тех, на кого он подписан, новые сверхуSELECT follows.follower_id AS timeline_id, list(posts.body ORDER BY posts.ts DESC) AS timelineFROM postsJOIN follows ON follows.followee_id = posts.sender_idGROUP BY follows.follower_idORDER BY timeline_id;┌─────────────┬───────────────────────────────────────────────────┐│ timeline_id │ timeline ││ varchar │ varchar[] │├─────────────┼───────────────────────────────────────────────────┤│ anna │ [Перешли на Flink, CDC работает, Запустили Kafka] ││ boris │ [Перешли на Flink, Запустили Kafka] │└─────────────┴───────────────────────────────────────────────────┘Ленты — это кэш результата такого запроса, который обновляется при каждом изменении таблиц. Авторы снова вспоминают аналогию с производной: поток — производная таблицы, а join — произведение u·v. Тогда изменения результата следуют правилу (u·v)′ = u′v + uv′: новый пост соединяется с текущими подписками, а новая подписка — с текущими постами.
Зависимость join от времени
Заголовок раздела «Зависимость join от времени»Все три вида join держат состояние из одного входа и обращаются к нему при обработке другого. Порядок событий здесь важен: подписаться и отписаться — не то же самое, что наоборот. Но Kafka гарантирует порядок только внутри shard, а между потоками — нет. Если пользователь обновил профиль, какие действия соединятся со старым профилем, а какие с новым?
Так бывает часто. Например, ставка налога зависит от страны, товара и даты продажи. При повторной обработке старых продаж нужна ставка на момент продажи, а не текущая. Если порядок событий между потоками не определён, join недетерминирован: повторный запуск может дать другой результат.
В хранилищах данных это называют медленно меняющимся измерением (slowly changing dimension, SCD). Каждая версия ставки получает свой ID, и продажа ссылается на ID ставки на момент продажи. Тогда join детерминирован, но log compaction невозможен, ведь нужны все версии. Другой путь — сразу записать ставку в событие продажи.
Отказоустойчивость
Заголовок раздела «Отказоустойчивость»Пакетная задача при сбое просто перезапускается, а вывод упавшей попытки выбрасывается. Это возможно, потому что вход неизменяем, а вывод виден только после успеха. В итоге результат такой, будто каждая запись обработана ровно один раз. Это называют семантикой exactly-once, хотя авторы считают, что точнее было бы effectively-once. В потоке так не выйдет: поток бесконечен, и ждать конца задачи, чтобы показать вывод, нельзя.
Microbatching и checkpoint
Заголовок раздела «Microbatching и checkpoint»Microbatching режет поток на маленькие пакеты, обычно около секунды, и обрабатывает каждый как пакетную задачу. Так делает Spark Streaming. Меньшие пакеты дают больше накладных расходов, а большие увеличивают задержку. При этом пакет неявно задаёт tumbling window по processing time, а для больших окон состояние приходится переносить между пакетами.
Apache Flink вместо этого периодически сохраняет контрольные точки (checkpoint) состояния в долговечное хранилище. Сохранение запускают барьеры — особые метки в потоке, похожие на границы микропакетов. Но, в отличие от микропакетов, барьеры не задают размер окна. После сбоя оператор начинает с последнего checkpoint и выбрасывает вывод, сделанный после него.
Оба подхода дают exactly-once внутри фреймворка. Но если вывод ушёл наружу (запись в базу, сообщение во внешний брокер, письмо), выбросить его нельзя, и при повторе побочный эффект случится дважды.
Снова атомарный commit
Заголовок раздела «Снова атомарный commit»Чтобы exactly-once работал и снаружи, все результаты обработки события должны сохраниться атомарно: сообщения дальше, записи в базу, изменения состояния и сдвиг offset. Это задача атомарного commit из главы 8. Традиционные транзакции вроде XA для этого плохи, но в узкой среде атомарный commit можно сделать эффективно. Так делают Google Cloud Dataflow, VoltDB и Apache Kafka: транзакции не выходят за пределы одной технологии, а несколько сообщений обрабатывают в одной транзакции, чтобы снизить накладные расходы.
Идемпотентность
Заголовок раздела «Идемпотентность»Другой путь — идемпотентность (о ней шла речь в разделе о durable execution, глава 5). Идемпотентная операция — это операция, которую можно выполнить несколько раз с тем же эффектом, что и один раз. Удаление ключа идемпотентно, а увеличение счётчика — нет.
Операцию часто можно сделать идемпотентной небольшими метаданными. Например, при записи во внешнюю базу рядом сохраняют offset сообщения Kafka, которое вызвало запись. Тогда повтор видно, и его можно пропустить. Но есть допущения: повтор проигрывает те же сообщения в том же порядке, обработка детерминирована, и никто другой не пишет то же значение. При переходе на другой узел может понадобиться fencing (глава 9). С этими оговорками идемпотентность даёт exactly-once с небольшими накладными расходами.
Восстановление состояния после сбоя
Заголовок раздела «Восстановление состояния после сбоя»Оконные агрегаты и таблицы для join — это состояние, и его нужно восстанавливать после сбоя. Его можно держать в удалённой базе, но запрос на каждое сообщение медленный. Чаще состояние держат локально и периодически реплицируют. Flink пишет снимки состояния в распределённую файловую систему, Kafka Streams отправляет изменения состояния в topic с log compaction, а VoltDB обрабатывает каждое сообщение на нескольких узлах.
Иногда состояние проще перестроить из входа: проиграть события короткого окна или прочитать changelog после log compaction. Что выгоднее, зависит от инфраструктуры: где-то сеть быстрее диска. Универсального ответа нет, а выбор между локальным и удалённым состоянием меняется вместе с технологиями хранения и сети.
Итоги главы
Заголовок раздела «Итоги главы»- Потоковая обработка похожа на пакетную, но работает непрерывно с неограниченными данными, а брокер и лог событий играют в ней роль файловой системы.
- Брокер AMQP/JMS раздаёт сообщения по одному и удаляет их после подтверждения, поэтому подходит для очереди задач, где порядок не важен.
- Брокер на основе лога отдаёт
shardодномуconsumer, хранит сообщения на диске и позволяет перечитать их с любогоoffset. - Записи в базу тоже поток:
CDCдостаётchangelogиз базы,event sourcingстроит приложение на событиях, аlog compactionхранит в потоке полную копию базы. Dual writesведут к гонкам и расхождению систем, аCDCиoutboxрешают проблему, потому что порядок задаёт одна база.- Потоки обрабатывают для поиска шаблонов (
CEP), оконной аналитики, поддержкиmaterialized view(в том числе черезIVM) и поиска по сохранённым запросам. - Окна считают по
event timeи заранее решают, что делать с опоздавшими событиями. - Все три вида
joinв потоках держат состояние и зависят от порядка событий. Exactly-onceв потоке даютmicrobatching,checkpoint, атомарные транзакции внутри фреймворка или идемпотентные записи.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
событие (event) | Небольшая неизменяемая запись о том, что случилось, с меткой времени |
topic | Именованный поток связанных событий |
producer / consumer | Кто пишет сообщения / кто их читает |
message broker | Сервер, который принимает сообщения от producer и доставляет их consumer |
backpressure | Медленный получатель тормозит отправителя |
load balancing / fan-out | Сообщение получает один consumer из группы / все consumer |
consumer group | Группа consumer, которая делит между собой shard одного topic |
подтверждение (ack) | Сигнал брокеру, что сообщение обработано и его можно удалить |
dead letter queue (DLQ) | Отдельная очередь для сообщений, которые не удаётся обработать |
| брокер на основе лога | Брокер, который хранит сообщения в логе на диске и не удаляет их при чтении |
offset | Номер сообщения в shard и позиция consumer в логе |
change data capture (CDC) | Извлечение всех изменений базы в виде потока для других систем |
snapshot | Согласованный снимок базы, привязанный к позиции в логе изменений |
log compaction | Фоновая очистка лога: остаётся последнее значение каждого ключа |
tombstone | Запись со значением null, которая удаляет ключ при compaction |
event sourcing | Приложение хранит неизменяемые события уровня приложения, а состояние выводит из них |
changelog | Лог всех изменений состояния |
outbox | Отдельная таблица для внешних событий, которую пишут в той же транзакции и читают через CDC |
data contract | Договор о схеме данных между источником и consumer |
crypto-shredding | Удаление зашифрованных данных через уничтожение ключа |
CEP | Поиск шаблонов событий в потоке по постоянным запросам |
materialized view | Готовый результат запроса, который обновляется при изменении данных |
IVM | Инкрементальная поддержка представлений: пересчёт только изменившихся данных |
event time / processing time | Когда событие произошло / когда его обработали |
опоздавшее событие (straggler) | Событие, которое пришло после закрытия своего окна |
watermark | Отметка: событий старше неё больше не ждём |
tumbling / hopping / sliding / session window | Окна без перекрытия / с шагом / по интервалу между событиями / до паузы в активности |
stream–table join | Обогащение событий данными таблицы, копию которой обновляет changelog |
exactly-once | Результат такой, будто каждая запись обработана ровно один раз |
microbatching / checkpoint | Поток режут на маленькие пакеты / периодически сохраняют состояние |
| идемпотентность | Повтор операции даёт тот же эффект, что и одно выполнение |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Не делайте
dual writesв базу и в другие системы. БеритеCDC(например, Debezium и Kafka) и стройте производные данные из лога. - Для
pipelineвыбирайте брокер на основе лога, если нужны порядок, большой поток и повторное чтение. Для очереди задач хватит брокера AMQP/JMS. - Мониторьте отставание
consumer(consumer lag) и срок хранения лога. Еслиconsumerотстал дальше срока хранения, данные потеряны. - Ключ
shardопределяет порядок. События одной сущности отправляйте с одним ключом. - Считайте окна по
event time, продумайте опоздавшие события и метрику их потерь. Не доверяйте часам клиента. - Делайте записи в приёмник идемпотентными (upsert по ключу или по
offset). Тогда повторная обработка безопасна. - Для чувствительных данных заранее продумайте физическое удаление: неизменяемый лог и резервные копии это усложняют.
- Если
CDCпитает чужие сервисы, схема вашей базы стала публичным API. Отдавайте наружу таблицуoutboxи фиксируйте её схему вdata contract. - Настройте
DLQи алерт на неё, чтобы одно битое сообщение не остановило весь поток. - Если агрегат должен быть свежим, сравните
REFRESH MATERIALIZED VIEWпо расписанию с базами наIVM(Materialize, RisingWave): они пересчитывают только изменения.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку.
Шаг 1. Создаём данные
Заголовок раздела «Шаг 1. Создаём данные»Три таблицы: запросы к сервису с двумя видами времени, клики пользователей и topic с ценами, где ключ — товар.
-- Запросы к сервису: одно событие каждые 10 секунд с 10:00 до 10:09:50CREATE TABLE requests ASSELECT    i AS request_id,    TIMESTAMP '2026-11-15 10:00:00' + INTERVAL (i * 10) SECOND AS event_timeFROM generate_series(0, 59) AS t(i);
-- Обработчик не работал с 10:04 до 10:06 (деплой), потом разобрал очередьALTER TABLE requests ADD COLUMN processing_time TIMESTAMP;UPDATE requests SET processing_time = CASE    WHEN event_time >= TIMESTAMP '2026-11-15 10:04:00'     AND event_time <  TIMESTAMP '2026-11-15 10:06:00'    THEN TIMESTAMP '2026-11-15 10:06:00' + INTERVAL (request_id - 24) SECOND    ELSE event_time + INTERVAL 1 SECONDEND;
-- Клики пользователей для session windowCREATE TABLE clicks ASSELECT * FROM (VALUES    ('anna', TIMESTAMP '2026-11-15 09:00:00'),    ('anna', TIMESTAMP '2026-11-15 09:10:00'),    ('anna', TIMESTAMP '2026-11-15 09:25:00'),    ('anna', TIMESTAMP '2026-11-15 11:00:00'),    ('anna', TIMESTAMP '2026-11-15 11:05:00'),    ('boris', TIMESTAMP '2026-11-15 09:30:00'),    ('boris', TIMESTAMP '2026-11-15 10:15:00')) AS t(user_id, ts);
-- Topic с ценами: ключ = товар, NULL = tombstone (товар удалён)CREATE TABLE prices_log ASSELECT * FROM (VALUES    (0, 'milk', 80), (1, 'tea', 50), (2, 'milk', 85), (3, 'coffee', 120),    (4, 'tea', 55), (5, 'milk', 90), (6, 'coffee', NULL), (7, 'tea', 60)) AS t(log_offset, product, price);
Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»Событие не может быть обработано раньше, чем произошло, поэтому bad_rows должно быть 0.
SELECT (SELECT count(*) FROM requests) AS requests, (SELECT count(*) FROM requests WHERE processing_time < event_time) AS bad_rows, (SELECT count(*) FROM clicks) AS clicks, (SELECT count(*) FROM prices_log) AS log_rows;┌──────────┬──────────┬────────┬──────────┐│ requests │ bad_rows │ clicks │ log_rows ││ int64 │ int64 │ int64 │ int64 │├──────────┼──────────┼────────┼──────────┤│ 60 │ 0 │ 7 │ 8 │└──────────┴──────────┴────────┴──────────┘Задания
Заголовок раздела «Задания»1. Посчитайте запросы в tumbling window по одной минуте двумя способами: по event time и по processing time. Где появляется ложный всплеск?
Решение
SELECT m.minute, (SELECT count(*) FROM requests WHERE date_trunc('minute', event_time) = m.minute) AS by_event_time, (SELECT count(*) FROM requests WHERE date_trunc('minute', processing_time) = m.minute) AS by_processing_timeFROM ( SELECT DISTINCT date_trunc('minute', event_time) AS minute FROM requests) AS mORDER BY m.minute;┌─────────────────────┬───────────────┬────────────────────┐│ minute │ by_event_time │ by_processing_time ││ timestamp │ int64 │ int64 │├─────────────────────┼───────────────┼────────────────────┤│ 2026-11-15 10:00:00 │ 6 │ 6 ││ 2026-11-15 10:01:00 │ 6 │ 6 ││ 2026-11-15 10:02:00 │ 6 │ 6 ││ 2026-11-15 10:03:00 │ 6 │ 6 ││ 2026-11-15 10:04:00 │ 6 │ 0 ││ 2026-11-15 10:05:00 │ 6 │ 0 ││ 2026-11-15 10:06:00 │ 6 │ 18 ││ 2026-11-15 10:07:00 │ 6 │ 6 ││ 2026-11-15 10:08:00 │ 6 │ 6 ││ 2026-11-15 10:09:00 │ 6 │ 6 │├─────────────────────┴───────────────┴────────────────────┤│ 10 rows 3 columns │└──────────────────────────────────────────────────────────┘По event time поток ровный: 6 запросов в минуту. По processing time видны две пустые минуты и всплеск до 18 в 10:06, хотя пользователи вели себя как обычно.
2. Разбейте клики на session window: новая сессия начинается, если с прошлого клика пользователя прошло больше 30 минут.
Решение
WITH marked AS ( SELECT user_id, ts, CASE WHEN ts - lag(ts) OVER (PARTITION BY user_id ORDER BY ts) <= INTERVAL 30 MINUTE THEN 0 ELSE 1 END AS new_session FROM clicks), numbered AS ( SELECT *, sum(new_session) OVER (PARTITION BY user_id ORDER BY ts) AS session_no FROM marked)SELECT user_id, session_no, min(ts) AS session_start, max(ts) AS session_end, count(*) AS clicksFROM numberedGROUP BY user_id, session_noORDER BY user_id, session_no;┌─────────┬────────────┬─────────────────────┬─────────────────────┬────────┐│ user_id │ session_no │ session_start │ session_end │ clicks ││ varchar │ int128 │ timestamp │ timestamp │ int64 │├─────────┼────────────┼─────────────────────┼─────────────────────┼────────┤│ anna │ 1 │ 2026-11-15 09:00:00 │ 2026-11-15 09:25:00 │ 3 ││ anna │ 2 │ 2026-11-15 11:00:00 │ 2026-11-15 11:05:00 │ 2 ││ boris │ 1 │ 2026-11-15 09:30:00 │ 2026-11-15 09:30:00 │ 1 ││ boris │ 2 │ 2026-11-15 10:15:00 │ 2026-11-15 10:15:00 │ 1 │└─────────┴────────────┴─────────────────────┴─────────────────────┴────────┘У окна сессии нет фиксированной длины: у Анны первая сессия длится 25 минут, а у Бориса два клика с разрывом в 45 минут дали две сессии.
3. Сделайте log compaction для prices_log: оставьте по одной последней записи на товар и уберите товары, у которых последняя запись — tombstone.
Решение
SELECT log_offset, product, priceFROM prices_logQUALIFY row_number() OVER (PARTITION BY product ORDER BY log_offset DESC) = 1 AND price IS NOT NULLORDER BY log_offset;┌────────────┬─────────┬───────┐│ log_offset │ product │ price ││ int32 │ varchar │ int32 │├────────────┼─────────┼───────┤│ 5 │ milk │ 90 ││ 7 │ tea │ 60 │└────────────┴─────────┴───────┘Из 8 записей осталось 2, как на схеме log compaction выше. Новый consumer, который прочитает этот лог с offset 0, получит полную текущую копию цен.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Когда выбрать брокер AMQP/JMS, а когда брокер на основе лога? Почему в первом случае балансировка ломает порядок сообщений?
- Почему
dual writesприводят к расхождению систем, даже если ни одна запись не упала? Как это решаютCDCиoutbox? - Почему
log compactionработает дляCDC, но не работает так же дляevent sourcing? - Чем
event timeотличается отprocessing time? Что делать с опоздавшими событиями и с часами мобильного устройства? - Почему
joinпотока с таблицей может быть недетерминированным и как это связано сSCD? - Почему
microbatchingиcheckpointне защищают от двойной отправки письма? Какие допущения нужны для идемпотентных записей?
Предыдущая: Пакетная обработка. Следующая: Философия потоковых систем.