

Designing Data-Intensive Applications, глава 4: Хранение и извлечение данных
Главная мысль: движок базы данных для транзакций (OLTP) и движок для аналитики устроены по-разному. Для OLTP есть две школы: LSM-tree дописывает неизменяемые файлы и быстро пишет, а B-tree перезаписывает страницы на месте и быстро читает. Аналитика хранит данные по колонкам, сжимает их и обрабатывает пачками.
О чём глава
Заголовок раздела «О чём глава»В главе 3 мы смотрели на базу снаружи. Эта глава смотрит изнутри: как база хранит данные и как находит их снова. Свой движок хранения (storage engine) вы вряд ли напишете, но выбрать и настроить его можно, только понимая, что он делает внутри. Темы главы:
- индекс и его цена,
LSM-treeиB-tree; - вторичные индексы и базы в памяти;
- облачные хранилища и колоночное хранение;
- многомерные, полнотекстовые и векторные индексы.
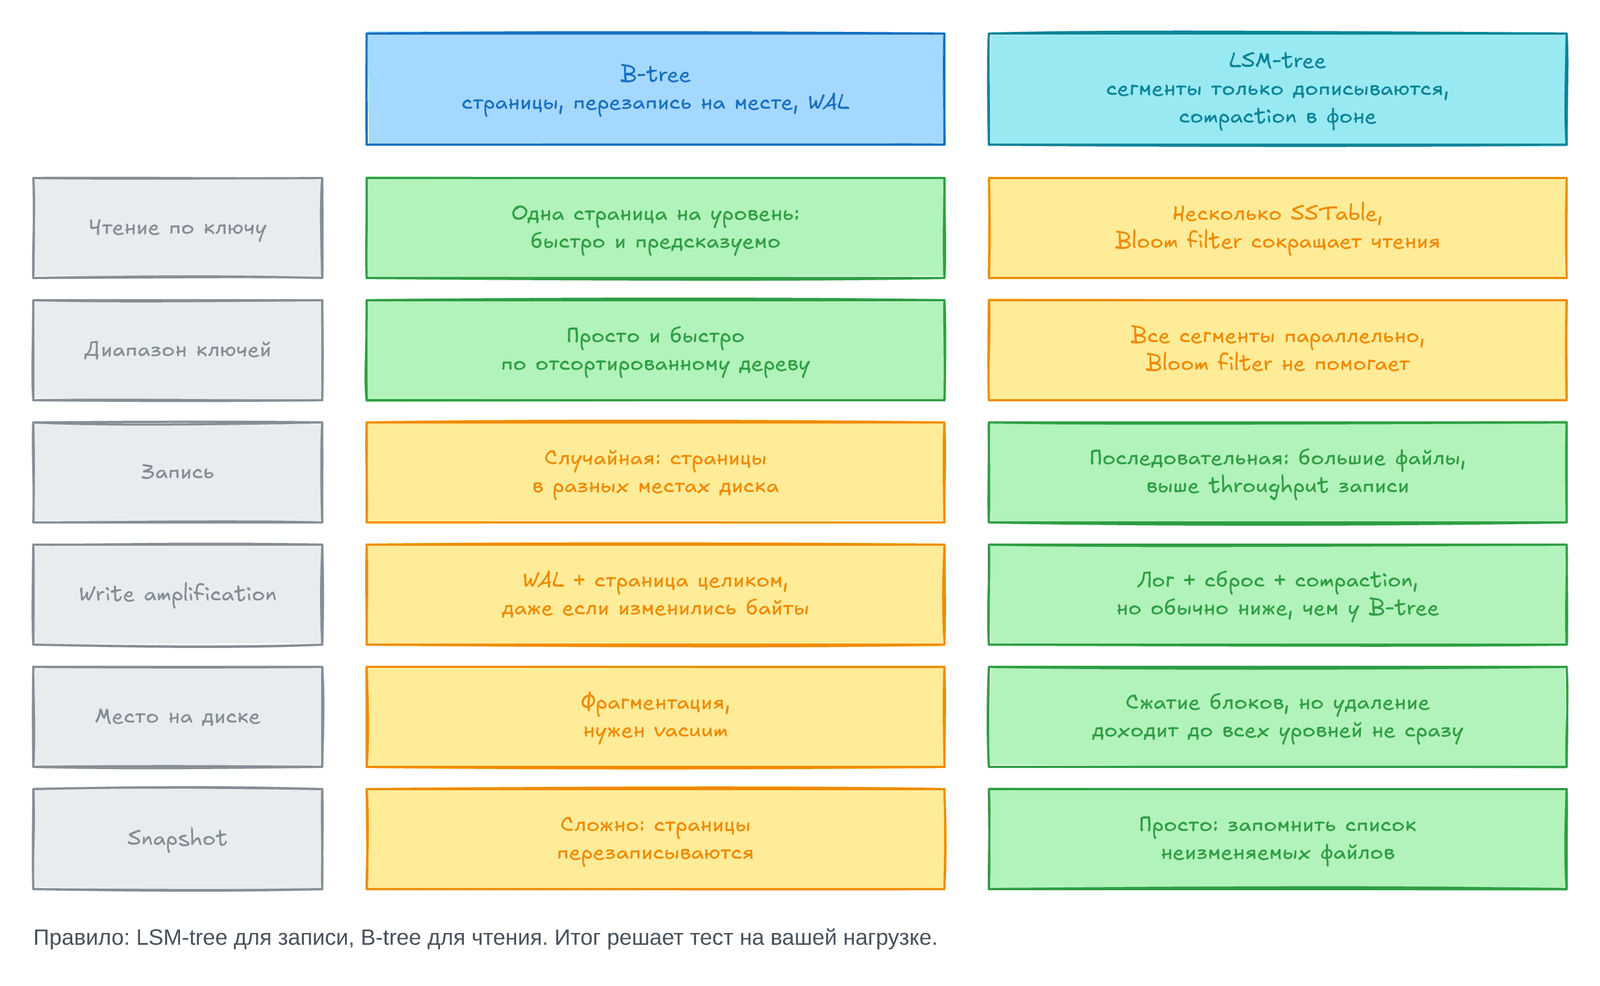
Схема сравнивает две школы хранения для OLTP из первой половины главы и показывает сильные стороны каждой.
Хранение и индексы для OLTP
Заголовок раздела «Хранение и индексы для OLTP»Самая простая база — две функции на bash: одна дописывает пару «ключ, значение» в конец файла, другая ищет последнее значение ключа. Наша версия:
db_set () {  echo "$1,$2" >> database}db_get () {  grep "^$1," database | sed -e "s/^$1,//" | tail -n 1}
db_set 1 '{"city":"Казань","sights":["Кремль"]}'db_set 2 '{"city":"Сочи","sights":["Роза Хутор"]}'db_get 2db_set 2 '{"city":"Сочи","sights":["Дендрарий"]}'db_get 2cat database
{"city":"Сочи","sights":["Роза Хутор"]}{"city":"Сочи","sights":["Дендрарий"]}1,{"city":"Казань","sights":["Кремль"]}2,{"city":"Сочи","sights":["Роза Хутор"]}2,{"city":"Сочи","sights":["Дендрарий"]}Скрипт целиком лежит в репозитории сайта: scripts/ddia-code/ch04_simple_db.sh. Старое значение ключа 2 не стёрто, поэтому db_get берёт последнее совпадение (tail -n 1).
Запись здесь очень быстрая: дописать в конец файла — самая дешёвая операция. Многие настоящие базы внутри тоже используют лог. Лог в этой книге — это последовательность записей, в которую только дописывают (append-only), часто двоичная и только для самой базы. Настоящей базе нужно ещё многое: параллельные записи, освобождение места, обработка недописанных записей после сбоя. Но принцип тот же: только дописывать в конец.
Зато чтение ужасное: db_get просматривает весь файл, цена поиска — O(n). Чтобы искать быстро, нужен индекс — дополнительная структура, которую строят из основных данных, например сортируя их по ключу. Индекс меняет только скорость запросов, но не содержимое базы.
У индекса есть цена: его надо обновлять при каждой записи. Это главный компромисс (trade-off) хранения: хорошие индексы ускоряют чтение, но занимают место и тормозят запись. Поэтому база не индексирует всё сама, а индексы выбирает разработчик по типичным запросам приложения.
Log-structured хранение
Заголовок раздела «Log-structured хранение»Допустим, файл остаётся, а чтение надо ускорить. Простой способ — хеш-таблица (hash map) в памяти: для каждого ключа она хранит позицию в файле, где лежит последнее значение. При записи обновляем позицию, при чтении переходим по ней. Так намного быстрее, но проблемы остаются:
- место от перезаписанных значений не освобождается, и диск в итоге кончится;
- после перезапуска хеш-таблицу надо строить заново, читая весь лог;
- все ключи должны помещаться в память, а хеш-таблицу на диске трудно сделать быстрой;
- запросы по диапазону неэффективны: ключи от 10000 до 19999 придётся искать по одному.
Формат SSTable
Заголовок раздела «Формат SSTable»Поэтому чаще данные хранят отсортированными по ключу. Пример — SSTable (Sorted Strings Table): файл с парами «ключ, значение», отсортированными по ключу, где каждый ключ встречается один раз.
Теперь не нужно держать в памяти все ключи. Пары группируют в блоки по несколько килобайт, а в индекс кладут первый ключ каждого блока. Такой индекс называют разреженным (sparse index). Пример: один блок начинается с handbag, следующий — с handsome. Ключ handiwork из-за сортировки может лежать только между ними, поэтому достаточно просмотреть один маленький блок. Блоки можно ещё и сжимать: это экономит диск и ввод-вывод ценой небольшого времени CPU.
Как строить и сливать SSTable
Заголовок раздела «Как строить и сливать SSTable»Читать из SSTable удобно, а писать сложно: дописать пару в конец нельзя, файл перестанет быть отсортированным. Выход — гибрид лога и отсортированного файла, log-structured подход:
- Запись попадает в отсортированную структуру в памяти, например в красно-чёрное дерево или
skip list. Её называютmemtable. - Когда
memtableбольше порога (обычно несколько мегабайт), её пишут на диск как новыйSSTable— самый новый сегмент со своим индексом. Новые записи тем временем идут в новуюmemtable. - Чтение смотрит в
memtable, потом в сегменты от новых к старым. Если ключа нет нигде, его нет в базе. - Время от времени фоновый процесс сливает сегменты и выбрасывает перезаписанные и удалённые значения. Это и есть
compaction.
Слияние работает как сортировка слиянием (mergesort): файлы читают параллельно, меньший ключ переносят в новый файл, а из повторов оставляют самое новое значение. Памяти почти не нужно.
Чтобы memtable не пропала при сбое, каждую запись дописывают ещё и в отдельный лог на диске. Он не сортирован и нужен только для восстановления. Когда memtable сброшена в SSTable, эту часть лога удаляют.
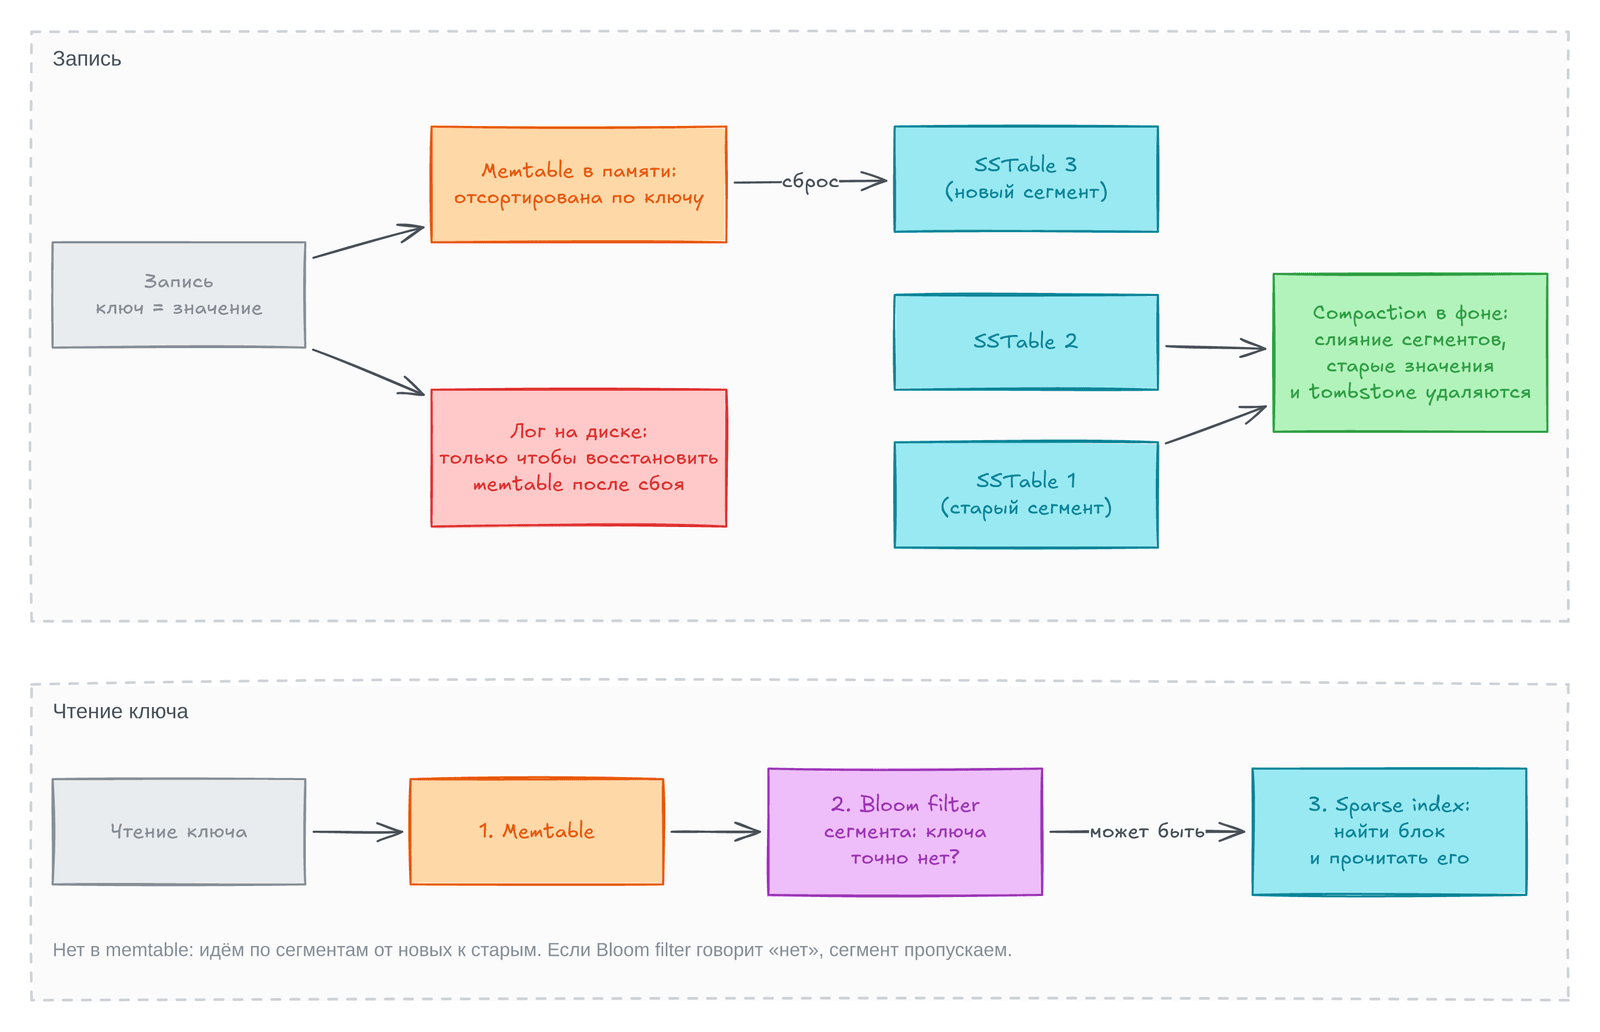
Верхняя часть схемы показывает путь записи, нижняя — путь чтения ключа.
Удалить ключ напрямую нельзя, поэтому дописывают особую запись удаления — tombstone. При слиянии она отбрасывает прежние значения ключа, а дойдя до самого старого сегмента, исчезает сама.
Этот алгоритм используют RocksDB, Cassandra, ScyllaDB и HBase. Все они выросли из статьи Google о Bigtable, где появились слова SSTable и memtable. Сам алгоритм опубликовали в 1996 году как Log-Structured Merge-tree, или LSM-tree, поэтому такие движки называют LSM-движками.
Сегмент пишут за один проход, и потом он не меняется. Пока идёт слияние, чтения обслуживают старые сегменты, потом переключаются на новый, а старые файлы удаляют. Неизменяемые файлы удобно хранить и в объектном хранилище: так делают SlateDB и Delta Lake. Неизменяемость упрощает и восстановление: недописанный при сбое SSTable просто удаляют, а оборванные записи лога ловят по контрольным суммам. Подробнее о долговечности — в главе 8.
Bloom filter
Заголовок раздела «Bloom filter»LSM-движку медленно читать давно не менявшийся ключ и особенно ключ, которого нет: приходится проверять много сегментов. Поэтому в каждый сегмент добавляют Bloom filter — быструю, но приблизительную проверку, есть ли ключ в этом SSTable.
Это массив битов, сначала из нулей. Каждый ключ сегмента пропускают через хеш-функцию, получают несколько чисел (например, 2, 9 и 4) и ставят эти биты в 1. При проверке ключа считают тот же хеш. Если хоть один бит равен 0, ключа точно нет. Если все равны 1, ключ, скорее всего, есть, но биты могли поставить и другие ключи. Это ложное срабатывание (false positive). Правило из книги: 10 бит на ключ дают около 1% ложных срабатываний, а каждые следующие 5 бит на ключ снижают их вдесятеро.
Для LSM-движка ложные срабатывания не страшны. Если фильтр сказал «нет», сегмент пропускаем. Если сказал «есть», читаем разреженный индекс и блок, а при ошибке просто зря потратили немного работы и идём к следующему сегменту.
Стратегии compaction
Заголовок раздела «Стратегии compaction»Многие LSM-системы дают выбрать, когда и какие SSTable сливать. Две частые стратегии:
| Стратегия | Как работает | Плюсы и минусы |
|---|---|---|
| Size-tiered | Маленькие новые SSTable сливают в большие старые. Четыре файла по 256 МБ дают один на 898 МБ: часть данных удалена, перезаписана или истекла | Выдерживает очень много записей, но старые файлы огромны, и слиянию нужно много временного места |
| Leveled | Файлы фиксированного размера лежат по уровням L0, L1, L2… В L0 свежие данные, дальше файлы делят диапазон ключей (a–m, n–z). Переполненный уровень сливают в следующий, более крупный | Сливает понемногу, требует меньше места на диске и быстрее читает: при поиске ключа надо проверить меньше файлов |
Size-tiered лучше, когда почти одни записи, leveled — когда преобладает чтение или когда немногие ключи пишут часто, а многие редко.
Встроенные движки
Заголовок раздела «Встроенные движки»Встроенные (embedded) базы не принимают запросы по сети. Это библиотеки в процессе вашего приложения, которые пишут файлы на локальный диск: RocksDB, SQLite, LMDB, DuckDB и KùzuDB. Они часто хранят данные в мобильных приложениях. На бэкенде подходят, если данные помещаются на одну машину и параллельных транзакций немного. Например, в системе для многих маленьких независимых клиентов (multitenant) можно завести по базе на клиента. Как масштабировать базу на много машин, расскажут глава 6 и глава 7.
Самая распространённая структура для чтения и записи по ключу — B-tree. Её придумали в 1970 году, и она до сих пор стандартный индекс почти во всех реляционных базах и во многих нереляционных.
Как и SSTable, B-tree держит ключи отсортированными, поэтому быстро ищет по ключу и по диапазону. На этом сходство заканчивается. LSM-движок пишет сегменты переменного размера один раз. B-tree делит базу на страницы фиксированного размера и перезаписывает их на месте. Традиционно страница — 4 КиБ, но PostgreSQL по умолчанию использует 8 КиБ, а MySQL — 16 КиБ. Страницы ссылаются друг на друга по номеру, как указатели на диске, и образуют дерево.
Поиск начинается с корневой страницы. В ней лежат ключи-границы и ссылки на дочерние страницы, каждая из которых отвечает за свой диапазон ключей. Ищем ключ 251: идём по ссылке между 200 и 300, потом между 250 и 270 и доходим до листа (leaf page). Лист хранит ключи и значения или ссылки на них. Число ссылок в одной странице — коэффициент ветвления (branching factor): в примере книги шесть, в реальных базах обычно несколько сотен.
Чтобы обновить значение, перезаписывают страницу-лист. Чтобы добавить ключ, кладут его в страницу нужного диапазона. Если места нет, страницу делят на две полупустые (split), а родителю добавляют границу. Пример: ключ 334 не помещается в полную страницу 333–345. Она делится на 333–337 (с ключом 334) и 337–345, родитель получает границу 337. Деление может дойти до корня, тогда над ним создают новый корень.
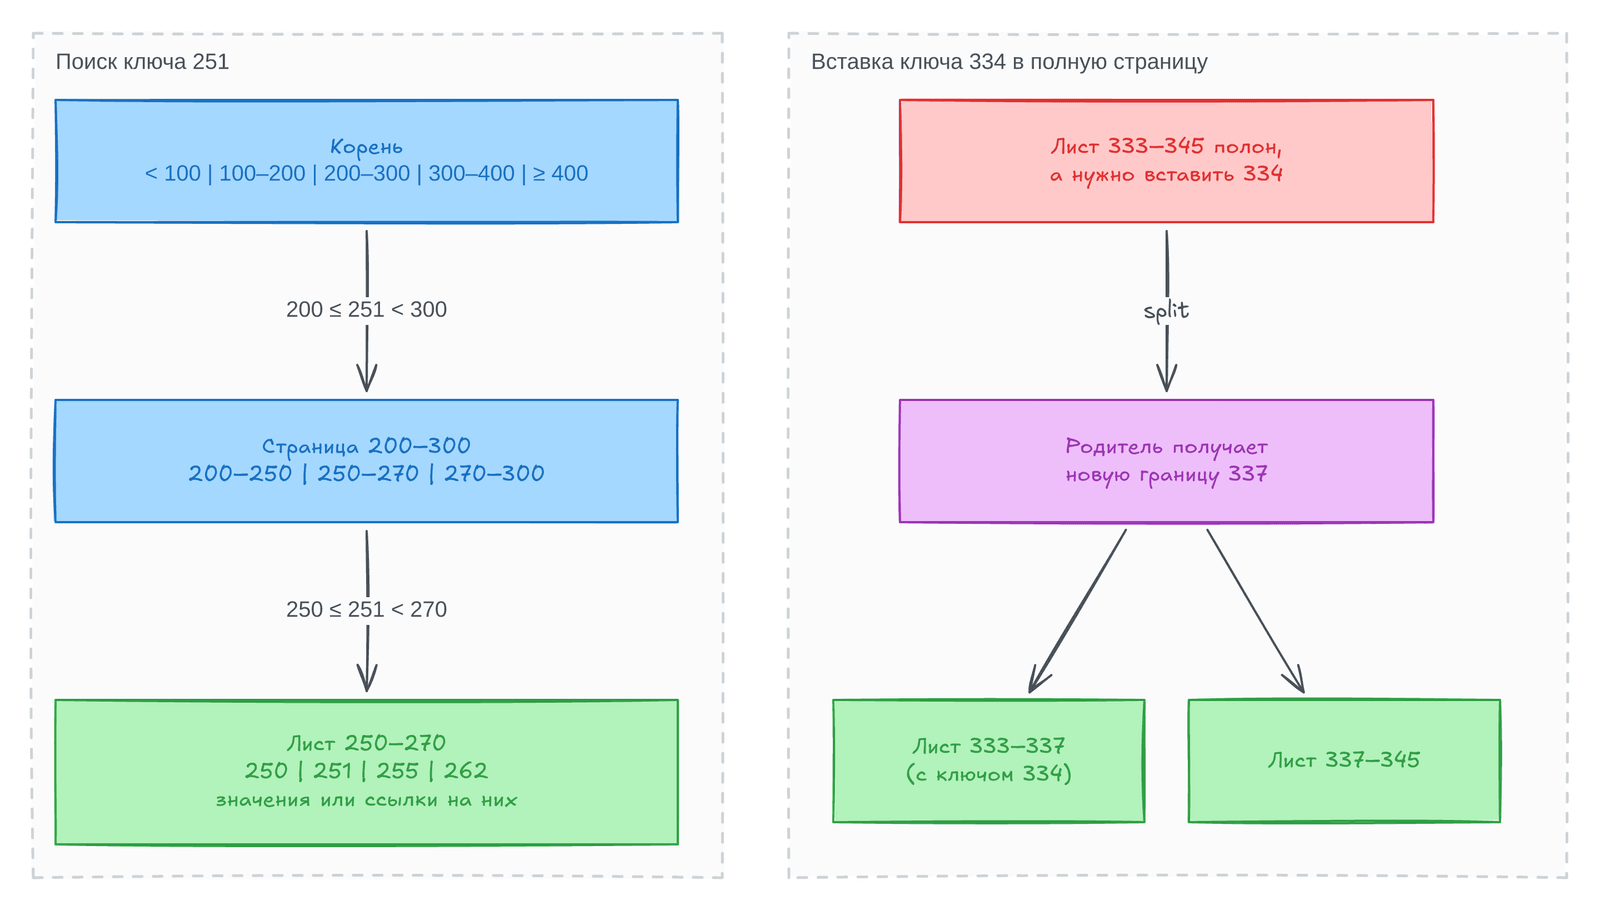
Слева на схеме путь поиска: на каждом уровне выбираем одну ссылку по границам. Справа — деление страницы.
Так дерево остаётся сбалансированным: при n ключах глубина всегда O(log n). Большинству баз хватает трёх-четырёх уровней. Четыре уровня страниц по 4 КиБ с ветвлением 500 вмещают до 250 ТБ.
Как сделать B-tree надёжным
Заголовок раздела «Как сделать B-tree надёжным»Базовая запись в B-tree — перезаписать страницу на том же месте, чтобы ссылки на неё не менялись. LSM-tree, наоборот, никогда не меняет записанный файл.
Перезапись нескольких страниц сразу, как при делении, опасна. Если база упадёт посреди операции, дерево сломается: может остаться страница-сирота без родителя. А если диск не пишет страницу атомарно, она окажется записанной наполовину (torn page). Поэтому B-tree дополняют журналом write-ahead log (WAL): каждое изменение сначала дописывают в него и только потом применяют к страницам. После сбоя дерево восстанавливают по журналу. В файловых системах это называют журналированием.
Ради скорости изменённые страницы какое-то время держат в памяти. WAL защищает и их: если запись попала в лог и сброшена на диск вызовом fsync, база восстановит её после сбоя.
Варианты B-tree
Заголовок раздела «Варианты B-tree»- Copy-on-write вместо
WAL(LMDB): изменённую страницу пишут в новое место и создают новые версии родителей. Это помогает и с параллельным доступом (глава 8). - Сокращённые ключи во внутренних страницах: там ключ нужен только как граница. Ветвление растёт, уровней меньше.
- Листья подряд на диске ускоряют просмотр диапазона, но этот порядок трудно сохранять при росте дерева.
- Ссылки листа на соседей позволяют идти по ключам без возврата к родителям.
Сравнение B-tree и LSM-tree
Заголовок раздела «Сравнение B-tree и LSM-tree»Правило: LSM-tree лучше для нагрузки с большим числом записей, а B-tree быстрее читает. Но бенчмарки чувствительны к деталям, поэтому сравнивать надо на своей нагрузке. Некоторые движки смешивают подходы, например держат несколько B-tree и сливают их, как LSM-движок сливает сегменты.
Скорость чтения
Заголовок раздела «Скорость чтения»B-tree читает одну страницу на уровень, поэтому чтение быстрое и предсказуемое. LSM-движок часто проверяет несколько SSTable, а Bloom filter сокращает обращения к диску. Диапазон в B-tree прост благодаря сортировке. LSM-движок должен параллельно пройти все сегменты и объединить результаты, а Bloom filter тут не помогает. Поэтому в LSM диапазоны дороже точечных запросов.
При очень интенсивной записи LSM-движок может давать всплески задержки (latency): memtable заполнилась, а compaction не успевает. Многие движки, включая RocksDB, тогда включают backpressure и приостанавливают чтения и записи, пока memtable не сброшена. Современные SSD (особенно NVMe) выполняют много чтений параллельно, и высокий throughput чтения доступен обоим подходам, если движок под это спроектирован.
Последовательная и случайная запись
Заголовок раздела «Последовательная и случайная запись»Если приложение пишет ключи вразброс, B-tree тоже пишет вразброс: страницы лежат где угодно. Это случайная запись (random writes). LSM-движок пишет целые сегменты, намного больше страницы. Это последовательная запись (sequential writes). Диски пишут последовательно быстрее, поэтому LSM на том же железе обычно выдерживает больше записей. На HDD разница огромная: головке надо механически сдвинуться, а это миллисекунды.
На SSD разница меньше, но есть. Флеш-память пишет страницами (обычно 4 КиБ), а стирает только блоками (обычно 512 КиБ). Перед стиранием контроллер переносит живые страницы блока в другие блоки — это сборка мусора (garbage collection, GC). При последовательной записи блок обычно принадлежит одному файлу и стирается без GC. При случайной в блоке смешаны живые и мёртвые страницы. GC тогда отнимает throughput у приложения и быстрее изнашивает диск.
Write amplification
Заголовок раздела «Write amplification»Одна запись приложения превращается в несколько записей на диск. LSM-tree пишет значение в лог, при сбросе memtable и при каждом compaction. B-tree пишет минимум дважды, в WAL и в страницу, и иногда пишет страницу целиком ради нескольких байт. Отношение всех байтов, записанных на диск, к байтам простого лога без индекса называют усилением записи (write amplification). Когда узкое место — скорость записи на диск, чем выше усиление, тем меньше записей в секунду выдержит база.
Для типичной нагрузки у LSM-tree write amplification обычно ниже: он не пишет страницы целиком и сжимает блоки. Меньше записей — и меньше износ SSD. Совет авторов: тестируйте запись долго. Пустой LSM-tree ещё не делает compaction, а с ростом базы запись делит диск со слиянием.
Место на диске
Заголовок раздела «Место на диске»B-tree со временем фрагментируется: после удалений в середине файла остаются пустые страницы, и вернуть их операционной системе трудно. Нужен фоновый процесс вроде vacuum в PostgreSQL. В LSM-tree фрагментации меньше: compaction регулярно переписывает файлы, и в сегментах нет страниц с пустым местом. К тому же блоки пар «ключ, значение» в сегментах сжимаются лучше, и файлы на диске часто получаются меньше. Старые значения занимают место до слияния, но при leveled-стратегии это немного.
Старые копии данных на диске мешают, когда данные надо точно удалить, например по закону о защите данных: удалённая запись живёт, пока tombstone не пройдёт все уровни. Зато неизменяемые сегменты удобны для снимка (snapshot): достаточно сбросить memtable и запомнить список файлов, копировать их не нужно. В B-tree с перезаписью страниц такой снимок сделать гораздо труднее.
Вторичные индексы
Заголовок раздела «Вторичные индексы»До сих пор речь шла об индексах «ключ — значение», как индекс первичного ключа, который однозначно задаёт строку, документ или вершину графа. Часто нужны и вторичные индексы (secondary index), например по user_id, чтобы найти все строки пользователя. Их создают командой CREATE INDEX. Отличие одно: ключи не уникальны. Поэтому в значении хранят список идентификаторов строк (как postings list в полнотекстовом поиске) или делают ключ уникальным, приписав идентификатор строки.
Хранение значений в индексе
Заголовок раздела «Хранение значений в индексе»- Clustered index хранит саму строку прямо в индексе. В InnoDB (MySQL) первичный ключ всегда такой.
- Индекс может хранить ссылку: первичный ключ строки (так InnoDB делает во вторичных индексах) или адрес в
heap file— файле строк без особого порядка, как в PostgreSQL. - Covering index хранит часть колонок в индексе. Некоторые запросы отвечают по одному индексу, но дублирование стоит места и замедляет запись.
Если новое значение в heap file не больше старого, его перезаписывают на месте. Если больше, запись переносят, и надо обновить все индексы или оставить в старом месте указатель на новое.
Всё в памяти
Заголовок раздела «Всё в памяти»Все структуры выше обходят ограничения дисков: чтобы быстро читать и писать, данные на диске надо тщательно раскладывать. Неудобство дисков мы терпим, потому что диск не теряет данные без питания и гигабайт на нём дешевле. Но память дешевеет, и многие наборы данных целиком помещаются в RAM. Так появились базы в памяти (in-memory).
Memcached служит только кэшем: потерять данные при перезапуске допустимо. Другие базы дают долговечность через лог изменений на диске, снимки или репликацию на другие машины. Диск там служит только логом, а читают всё из памяти. Примеры: VoltDB, SingleStore и Oracle TimesTen (реляционные), RAMCloud (хранилище «ключ — значение» с логом и в памяти, и на диске). Redis и Couchbase пишут на диск асинхронно и дают слабую долговечность.
Неожиданная мысль авторов: базы в памяти быстрее не потому, что не читают с диска. При достатке памяти и дисковая база не читает с диска: операционная система кэширует блоки. Выигрыш в том, что не надо кодировать структуры памяти в формат для диска. Ещё плюс — модели данных, которые трудно сделать на диске: Redis просто реализует очереди с приоритетом и множества.
Хранение данных для аналитики
Заголовок раздела «Хранение данных для аналитики»Модель данных хранилища (data warehouse) обычно реляционная: SQL хорошо подходит для аналитики, и многие BI-инструменты сами генерируют SQL. Снаружи хранилище похоже на OLTP-базу, но внутри оптимизировано под совсем другие запросы. Поэтому многие производители теперь поддерживают либо транзакции, либо аналитику, но не то и другое сразу. Даже HTAP-базы (hybrid transactional and analytical processing) вроде SQL Server, SAP HANA и SingleStore всё чаще состоят из двух движков с общим SQL.
Облачные хранилища данных
Заголовок раздела «Облачные хранилища данных»Рядом с Teradata, Vertica и SAP HANA широко распространились чисто облачные хранилища: BigQuery, Amazon Redshift и Snowflake. Они лучше связаны с облачными сервисами (например, сами загружают логи) и эластичнее: вычисления отделены от хранения. Данные лежат в объектном хранилище, поэтому объём и мощность можно менять независимо (см. главу 1).
Open source хранилища (Hive, Trino, Spark) тоже ушли в облако. Данные переехали в data lake, и то, что раньше было единой системой вроде Hive, распалось на компоненты:
| Компонент | Что делает | Примеры |
|---|---|---|
| Query engine | Разбирает SQL, строит план и выполняет его, обычно параллельно. Иногда отдаёт задачи Spark или Flink | Trino, Apache DataFusion, Presto |
Формат хранения (storage format) | Задаёт, как строки таблицы превращаются в байты файла. Файлы читают любые приложения на data lake | Parquet, ORC, Lance, Nimble |
Табличный формат (table format) | Говорит, какие неизменяемые файлы составляют таблицу и какая у неё схема. Даёт вставки и удаления строк, time travel (таблица на момент в прошлом) и даже транзакции | Apache Iceberg, Delta |
Каталог данных (data catalog) | Знает, какие таблицы есть в базе, создаёт и удаляет их. Обычно отдельный сервис с REST-интерфейсом, поэтому его метаданные видят и системы data governance | Snowflake Polaris, Unity Catalog, каталог Iceberg |
Колоночное хранение
Заголовок раздела «Колоночное хранение»Хранилища обычно используют star schema: большая таблица фактов (fact table) со ссылками на измерения (см. главу 3). В таблице фактов бывают триллионы строк и больше ста колонок, но запрос обычно читает четыре-пять. Пример из книги: что чаще покупают по дням недели 2024 года, свежие фрукты или конфеты. Запрос перебирает огромное число строк fact_sales, но берёт только date_key, product_sk и quantity.
OLTP-базы хранят данные построчно: все значения строки лежат рядом. Даже с индексами строчному движку придётся загрузить строки целиком, со всеми полями (а их больше сотни), и отфильтровать. Это долго. Идея колоночного хранения (column-oriented storage) проста: хранить вместе значения каждой колонки. Тогда запрос читает только свои колонки.
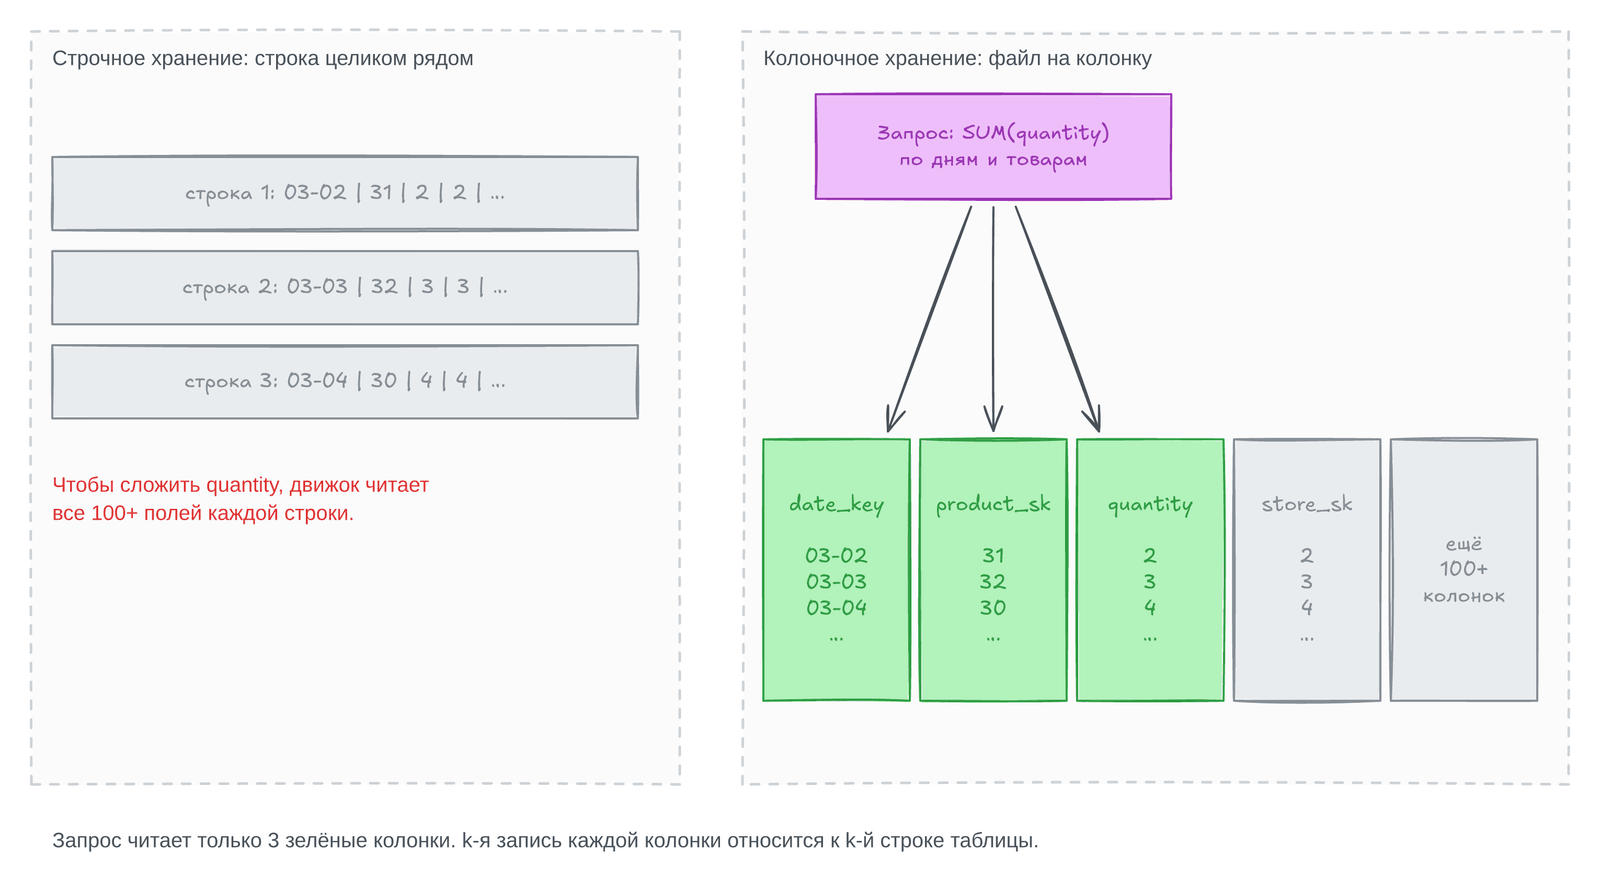
На схеме колоночный движок не трогает лишние колонки. Чтобы собрать строку, берут k-ю запись из каждой колонки: все колонки хранят строки в одном порядке.
Колоночное хранение работает и для документов: Parquet раскладывает документы по колонкам приёмом shredding, как в Dremel от Google. На практике колонку не хранят одним куском. Таблицу делят на блоки по тысячам или миллионам строк, часто по диапазону времени, и внутри блока хранят колонки отдельно. Тогда запрос читает только нужные колонки нужных блоков.
Колоночное хранение используют почти все аналитические базы: Snowflake, DuckDB, Pinot, Druid. На нём построены форматы Parquet, ORC, Lance и Nimble, форматы в памяти Apache Arrow и Pandas/NumPy, а также базы временных рядов InfluxDB IOx и TimescaleDB.
Как сжимают колонки
Заголовок раздела «Как сжимают колонки»В колонках много повторов, поэтому их хорошо сжимать. Это ещё сильнее снижает нагрузку на диск и сеть. Метод выбирают по данным, и в хранилищах особенно хорош bitmap encoding.
Разных значений в колонке обычно мало: миллиарды продаж, но 100 000 товаров. Колонку с n разными значениями превращают в n битовых карт (bitmap), по одной на значение и по биту на строку: 1, если в строке это значение. Карты обычно почти из одних нулей, поэтому их дополнительно кодируют run-length encoding: хранят длины серий нулей и единиц. Roaring bitmaps сами выбирают более компактный из двух видов: бит на строку или длины серий. Такие карты удобны для запросов хранилища:
WHERE product_sk IN (31, 68, 69): побитовое OR трёх карт.WHERE product_sk = 30 AND store_sk = 3: побитовое AND двух карт. Это работает, потому что k-й бит в обеих картах относится к одной строке.
Битовые карты отвечают даже на запросы к графу: например, кто из соцсети подписан на Y и на кого подписан X.
Авторы предупреждают: колоночные базы — не то же, что модель wide-column (column-family) в Bigtable, Accumulo и HBase. Там у строки могут быть тысячи разных колонок, но хранится она целиком, то есть такие базы строчные.
Порядок сортировки
Заголовок раздела «Порядок сортировки»Проще всего хранить строки в порядке вставки. Но можно задать порядок, как в SSTable, и использовать его как индекс. Сортируют строки целиком, а не каждую колонку отдельно, иначе неясно, какие значения относятся к одной строке. Колонки сортировки выбирают по частым запросам. Если запросы берут диапазон дат, первым ключом сортировки (sort key) делают date_key, и запрос за прошлый месяц читает только его строки. Второй ключ, например product_sk, собирает рядом продажи одного товара за день.
Сортировка помогает и сжимать. В первой колонке сортировки идут длинные серии одинаковых значений, и run-length encoding ужимает её до килобайт даже при миллиардах строк. На втором и третьем ключе серии короче, а значения в следующих колонках идут почти случайно. Но в сумме сортировка первых колонок выгодна.
Запись в колоночное хранилище
Заголовок раздела «Запись в колоночное хранилище»Запись в хранилище обычно идёт пакетами через ETL. Вставить строку в середину отсортированной таблицы дорого: пришлось бы переписать все закодированные колонки после неё. Большой пакет делит эту цену на много строк. Поэтому пишут log-structured способом: записи копятся в отсортированном строчном хранилище в памяти, потом их сливают с колоночными файлами и пишут новые файлы целиком. Неизменяемые файлы удобно держать в объектном хранилище. Запрос объединяет файлы на диске и свежие записи в памяти, так что аналитик сразу видит изменения. Так работают Snowflake, Vertica, Pinot, Druid и другие.
Выполнение запросов: компиляция и векторизация
Заголовок раздела «Выполнение запросов: компиляция и векторизация»Аналитический запрос разбивают на план из операторов, которые можно выполнять параллельно на разных машинах. Оператор проверяет значения колонок: входит ли значение в набор, больше ли оно 15, совпадают ли товар и магазин. Запрос перебирает миллионы строк, поэтому важно и время CPU. Простой оператор работает как интерпретатор языка программирования: для каждой строки заново читает структуру запроса, чтобы узнать, какие колонки сравнить или посчитать. Для аналитики это слишком медленно. Есть два быстрых подхода:
- Компиляция запроса. Движок генерирует по SQL код, компилирует его в машинный (часто через LLVM) и запускает на колонках в памяти. Это похоже на JIT-компиляцию в JVM.
- Векторизованная обработка (
vectorized processing). Запрос интерпретируют, но встроенные операторы обрабатывают значения колонки пачкой. Например, оператор равенства получает колонкуproduct_skи ID бананов и возвращает битовую карту совпадений. Вторая карта — поstore_skи нужному магазину. Побитовое AND двух карт даёт продажи бананов в этом магазине.
Оба подхода быстры, потому что используют свойства процессоров:
- последовательный доступ к памяти, чтобы было меньше промахов кэша;
- короткие внутренние циклы без вызовов функций, чтобы конвейер процессора не простаивал;
- параллелизм: потоки и инструкции SIMD (одна инструкция над многими значениями);
- работа прямо над закодированными данными, без распаковки.
Materialized views и data cube
Заголовок раздела «Materialized views и data cube»Materialized view — это копия результата запроса на диске. Обычный (виртуальный) view — только сокращение: при чтении движок подставляет запрос view. Materialized view надо обновлять при изменении данных. Некоторые базы делают это сами, а Materialize специализируется на этом. Обновление добавляет работы при записи, зато ускоряет повторяющиеся запросы.
Частный случай для хранилищ — материализованные агрегаты. Если многие запросы считают одни и те же SUM или COUNT, пересчитывать их каждый раз расточительно. Data cube (OLAP cube) хранит сетку агрегатов по измерениям. При двух измерениях это таблица: даты по одной оси, товары по другой, в ячейке SUM(net_price). Сумма по строке или столбцу даёт итог на одно измерение меньше. В реальных данных измерений больше (в примере главы 3 их пять), но принцип тот же.
Куб делает некоторые запросы очень быстрыми, например продажи по магазинам за вчера. Но он теряет гибкость: долю продаж товаров дороже $100 не посчитать, потому что цена не измерение. Поэтому хранилища держат сырые данные, а кубы используют только как ускорение.
Многомерные и полнотекстовые индексы
Заголовок раздела «Многомерные и полнотекстовые индексы»B-tree и LSM-tree ищут по диапазону одного атрибута. Самый частый индекс по нескольким колонкам — составной (concatenated index): он склеивает поля в один ключ. Это как бумажный телефонный справочник по (фамилия, имя). Он найдёт всех с нужной фамилией или нужной парой «фамилия, имя», но не всех с нужным именем.
Многомерный индекс ищет сразу по нескольким колонкам. Это важно для геоданных. Сайт ресторанов ищет все рестораны в видимом на карте прямоугольнике: latitude в одном диапазоне и одновременно longitude в другом. Составной индекс по (latitude, longitude) даст полосу широт на любой долготе, но не оба условия сразу.
Один выход — превратить точку в одно число кривой, заполняющей пространство (space-filling curve), и взять обычный B-tree. Чаще используют пространственные индексы R-tree или Bkd-tree: они кладут близкие точки в одно поддерево. Так PostGIS строит геоиндексы на механизме GiST в PostgreSQL. Бывают и регулярные сетки из треугольников, квадратов или шестиугольников. Многомерные индексы нужны не только для карт. Магазин ищет товары по диапазону цвета (красный, зелёный, синий), а база погоды — наблюдения за год с температурой от 25 до 30 °C по индексу (дата, температура).
Полнотекстовый поиск
Заголовок раздела «Полнотекстовый поиск»Полнотекстовый поиск (full-text search) ищет документы по словам в любом месте текста. Это большая отдельная область: деление на слова зависит от языка, а ещё надо учитывать опечатки, формы слов и синонимы. Всё это авторы оставляют за рамками книги.
Полнотекстовый поиск — тоже многомерный запрос: каждое слово (term) — измерение, где у документа 1 или 0. Поиск «red apples» ищет 1 в обоих измерениях сразу. Отвечают на такие запросы через обратный индекс (inverted index): ключ — слово, значение — список ID документов с ним (postings list). Этот список можно хранить как разреженную битовую карту, и тогда поиск двух слов — это побитовое AND двух карт, как в векторизованном запросе хранилища.
Так работает Lucene внутри Elasticsearch и Solr. Он хранит списки в отсортированных файлах, похожих на SSTable, и сливает их в фоне тем же log-structured способом. Индекс GIN в PostgreSQL тоже использует postings list для полнотекстового поиска и для поиска внутри JSON.
Можно индексировать не слова, а n-граммы — все подстроки длины n. Триграммы слова hello: hel, ell и llo. Индекс по триграммам ищет любые подстроки от трёх символов и даже регулярные выражения, но получается большим. Для опечаток Lucene ищет слова в пределах расстояния редактирования (edit distance): расстояние 1 значит, что одну букву добавили, удалили или заменили. Для этого он хранит слова как конечный автомат, похожий на trie, и превращает его в автомат Левенштейна.
Векторные embeddings
Заголовок раздела «Векторные embeddings»Семантический поиск (semantic search) пытается понять смысл документа и намерение пользователя. Он важен для AI-приложений, например для RAG (retrieval-augmented generation), где результаты поиска подмешивают в ответ LLM. Пример: страницу «Отмена подписки» должны находить по запросам «как закрыть аккаунт» или «расторгнуть договор», хотя слова совсем другие.
Для этого модель (embedding model, часто LLM) превращает документ в вектор чисел — vector embedding. Вектор — это точка в многомерном пространстве, и документы с похожим смыслом оказываются рядом. Авторы предупреждают о путанице: в векторизованной обработке «вектор» — это пачка значений, а здесь — массив чисел, задающий точку.
Пример с тремя измерениями: статья о сельском хозяйстве — [0,38, 0,83, 0,41], об овощах — [0,36, 0,64, 0,67], о star schema — [0,85, 0,10, −0,52]. Первые два вектора ближе друг к другу. Реальные векторы длиной от 1000 чисел, и смысл отдельных чисел не важен. Близость меряют косинусным сходством (cosine similarity, косинус угла между векторами) или евклидовым расстоянием (длина прямой между точками). Первые модели (Word2Vec, BERT, GPT) работали с текстом, потом появились модели для видео, звука и изображений. Сейчас одна мультимодальная модель строит векторы и для текста, и для картинок.
При поиске модель строит вектор запроса (иногда с контекстом, например местом пользователя), а векторный индекс возвращает документы с ближайшими векторами. R-tree при множестве измерений работают плохо, поэтому есть специальные индексы:
| Индекс | Как работает | Точность и скорость |
|---|---|---|
| Flat | Запрос меряет расстояние до каждого вектора | Точный, но медленный |
| IVF (inverted file) | Векторы делят на кластеры вокруг центроидов. Запрос проверяет только несколько ближайших кластеров, их число задаёт параметр probes | Быстрее, но приблизительный: близкие векторы могут попасть в разные кластеры. Больше probes — точнее и медленнее |
| HNSW (Hierarchical Navigable Small World) | Несколько слоёв-графов, где рёбра связывают близкие векторы. Поиск начинает в верхнем, редком слое и спускается в более густые, приближаясь к цели | Приблизительный, как IVF |
IVF и HNSW реализуют многие векторные базы, библиотека Faiss от Facebook и pgvector для PostgreSQL.
Итоги главы
Заголовок раздела «Итоги главы»- OLTP-движки обслуживают много мелких запросов по ключу и должны отвечать быстро; аналитические движки обслуживают сложные запросы, которые перебирают огромное число строк.
- Любой индекс ускоряет чтение, но замедляет запись и занимает место, поэтому индексы выбирают под реальные запросы.
- Log-structured подход (
SSTable,LSM-tree, RocksDB, Cassandra, HBase, ScyllaDB, Lucene) только дописывает файлы и удаляет старые, поэтому даёт высокийthroughputзаписи. Bloom filterпозволяет LSM-движку быстро пропускать сегменты, в которых ключа точно нет.- Подход с обновлением на месте (
B-tree) делит диск на страницы фиксированного размера; он стоит во всех крупных реляционных базах и обычно быстрее читает. B-treeзащищает себя от сбоев черезWAL, аLSM-tree— через неизменяемые файлы и лог дляmemtable.- Хранилища данных хранят данные по колонкам и сжимают их, чтобы читать с диска как можно меньше.
- Компиляция запросов и векторизованная обработка экономят время CPU при переборе миллионов строк.
- Многомерные индексы ищут по нескольким условиям сразу, полнотекстовые — по нескольким словам, а векторные индексы находят документы с похожим смыслом.
- Понимание движка помогает выбрать инструмент и предсказать, что даст изменение параметра настройки.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
SSTable | Файл пар «ключ, значение», отсортированных по ключу |
Memtable | Отсортированная структура в памяти для свежих записей LSM-движка |
LSM-tree | Каскад SSTable, которые сливаются в фоне (compaction) |
Tombstone | Запись, которая помечает ключ как удалённый |
Bloom filter | Битовый массив, который точно говорит, что ключа в сегменте нет |
B-tree | Дерево страниц фиксированного размера с обновлением на месте |
WAL | Лог, куда пишут изменение до того, как применить его к страницам |
Write amplification | Во сколько раз записи на диск превышают записи простого лога |
| Clustered / covering index | Индекс, который хранит всю строку / часть колонок |
| Колоночное хранение | Значения каждой колонки хранятся вместе |
Bitmap encoding | Битовая карта на каждое значение колонки, по биту на строку |
Sort key | Колонка, по которой сортируют строки колоночной таблицы |
| Data cube | Сетка заранее посчитанных агрегатов по измерениям |
Inverted index | Индекс от слова к списку документов (postings list) |
Vector embedding | Вектор чисел, который задаёт смысл документа как точку в пространстве |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбирайте движок по нагрузке. Много записей: смотрите на LSM (Cassandra, RocksDB). Много точечных чтений и транзакций:
B-tree(PostgreSQL, MySQL). - Не запускайте тяжёлую аналитику на боевой OLTP-базе. Используйте реплику или хранилище данных.
- Для аналитики храните данные в колоночных форматах (Parquet) и в колоночных хранилищах. Выбирайте
sort keyпод частые фильтры, например дату. - Каждый лишний индекс замедляет запись. Удаляйте неиспользуемые.
- Моделируйте хранилище как факты и измерения. Храните сырые факты, агрегаты добавляйте как ускорение.
- Не доверяйте общим бенчмаркам. Тестируйте на своих данных и достаточно долго, чтобы проявился
compaction. - Пишите в
data lakeпакетами, а не по строке: мелкие файлы Parquet плохо сжимаются и замедляют чтение, а Iceberg и Delta потом всё равно их сливают. - Удаление по закону (например, по запросу пользователя) в LSM-движке и в табличных форматах не мгновенно: старые файлы живут до
compactionили очистки снимков. - Для семантического поиска не обязательно ставить отдельную базу:
pgvectorдаёт IVF и HNSW прямо в PostgreSQL.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку.
Шаг 1. Создаём сегменты LSM и таблицу продаж
Заголовок раздела «Шаг 1. Создаём сегменты LSM и таблицу продаж»Таблица segments — это три сегмента LSM-движка. seq растёт со временем, а value IS NULL означает tombstone. Таблица fact_sales — маленькая таблица фактов.
CREATE TABLE segments ASSELECT * FROM (VALUES    (1, 1, 'apple',  '10'),    (1, 2, 'banana', '20'),    (1, 3, 'cherry', '30'),    (2, 4, 'apple',  '11'),    (2, 5, 'durian', '40'),    (3, 6, 'banana', NULL),    (3, 7, 'cherry', '31')) AS t(segment_id, seq, key, value);
CREATE TABLE fact_sales ASSELECT    i                                          AS row_id,    DATE '2024-03-01' + CAST(i % 4 AS INTEGER) AS date_key,    30 + (i * 7) % 3                           AS product_sk,    1 + (i * 5) % 4                            AS store_sk,    1 + i % 5                                  AS quantityFROM generate_series(1, 20) AS g(i);
Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»SELECT (SELECT count(*) FROM segments) AS segment_rows, (SELECT count(*) FROM fact_sales) AS sales_rows;┌──────────────┬────────────┐│ segment_rows │ sales_rows ││ int64 │ int64 │├──────────────┼────────────┤│ 7 │ 20 │└──────────────┴────────────┘Задания
Заголовок раздела «Задания»- Сделайте
compaction: оставьте для каждого ключа самое новое значение и выбросьте удалённые ключи. - Постройте битовые карты для
product_sk = 30иstore_sk = 3и найдите строки с обоими условиями через побитовое AND. - Посчитайте серии одинаковых значений (их сжимает
run-length encoding) вdate_keyиproduct_sk: в порядке вставки и после сортировки поdate_key, product_sk.
Решение
SELECT key, valueFROM segmentsQUALIFY row_number() OVER (PARTITION BY key ORDER BY seq DESC) = 1 AND value IS NOT NULLORDER BY key;┌─────────┬─────────┐│ key │ value ││ varchar │ varchar │├─────────┼─────────┤│ apple │ 11 ││ cherry │ 31 ││ durian │ 40 │└─────────┴─────────┘banana пропал: его последняя запись — tombstone. У apple и cherry остались новые значения из более свежих сегментов.
Решение
WITH bitmaps AS ( SELECT bitstring_agg(row_id, 1, 20) FILTER (WHERE product_sk = 30) AS b_product, bitstring_agg(row_id, 1, 20) FILTER (WHERE store_sk = 3) AS b_store FROM fact_sales)SELECT b_product, b_store, b_product & b_store AS b_and, bit_count(b_product & b_store) AS matchesFROM bitmaps;┌──────────────────────┬──────────────────────┬──────────────────────┬─────────┐│ b_product │ b_store │ b_and │ matches ││ bit │ bit │ bit │ int64 │├──────────────────────┼──────────────────────┼──────────────────────┼─────────┤│ 00100100100100100100 │ 01000100010001000100 │ 00000100000000000100 │ 2 │└──────────────────────┴──────────────────────┴──────────────────────┴─────────┘Каждый бит — одна строка таблицы. AND оставил единицы в строках 6 и 18: обычный WHERE product_sk = 30 AND store_sk = 3 тоже вернёт 2 строки.
Решение
WITH as_inserted AS ( SELECT date_key <> lag(date_key) OVER (ORDER BY row_id) AS new_date, product_sk <> lag(product_sk) OVER (ORDER BY row_id) AS new_product FROM fact_sales), sorted AS ( SELECT date_key <> lag(date_key) OVER (ORDER BY date_key, product_sk) AS new_date, product_sk <> lag(product_sk) OVER (ORDER BY date_key, product_sk) AS new_product FROM fact_sales)SELECT 'как вставили' AS row_order, 1 + count(*) FILTER (WHERE new_date) AS date_runs, 1 + count(*) FILTER (WHERE new_product) AS product_runsFROM as_insertedUNION ALLSELECT 'date_key, product_sk', 1 + count(*) FILTER (WHERE new_date), 1 + count(*) FILTER (WHERE new_product)FROM sorted;┌──────────────────────┬───────────┬──────────────┐│ row_order │ date_runs │ product_runs ││ varchar │ int64 │ int64 │├──────────────────────┼───────────┼──────────────┤│ как вставили │ 20 │ 20 ││ date_key, product_sk │ 4 │ 12 │└──────────────────────┴───────────┴──────────────┘В порядке вставки каждая строка — отдельная серия, сжимать нечего. После сортировки первый ключ date_key даёт всего 4 серии, а второй ключ product_sk — 12: он сжимается хуже, как и пишут авторы.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему простой лог пишет быстро, но читает медленно, и как индекс меняет этот баланс?
- Зачем LSM-движку и
memtable, и отдельный лог на диске, и почему лог не надо сортировать? - Когда
Bloom filterэкономит работу, а когда бесполезен? - Почему деление страницы в
B-treeопасно при сбое и какWALрешает эту проблему? - Когда выбрать size-tiered
compaction, а когда leveled? - Почему колоночное хранение ускоряет аналитику и почему сортировка по первому ключу сжимает колонку лучше всего?
Предыдущая: Модели данных и языки запросов. Следующая: Кодирование данных и изменение схем.