

Designing Data-Intensive Applications, глава 7: Sharding
Главная мысль: Sharding делит данные на части и раскладывает их по узлам, чтобы система выдержала больше, чем одна машина. Цена — сложность: нужно выбрать ключ, держать нагрузку ровной и знать, где лежит каждая запись.
О чём глава
Заголовок раздела «О чём глава»В главе 6 мы хранили копии данных на нескольких узлах. Эта глава о другом: что делать, если данных или записей так много, что один узел не справляется. Темы: зачем нужен sharding, деление по диапазону ключей и по хешу, rebalancing, hot spot, маршрутизация запросов и вторичные индексы.
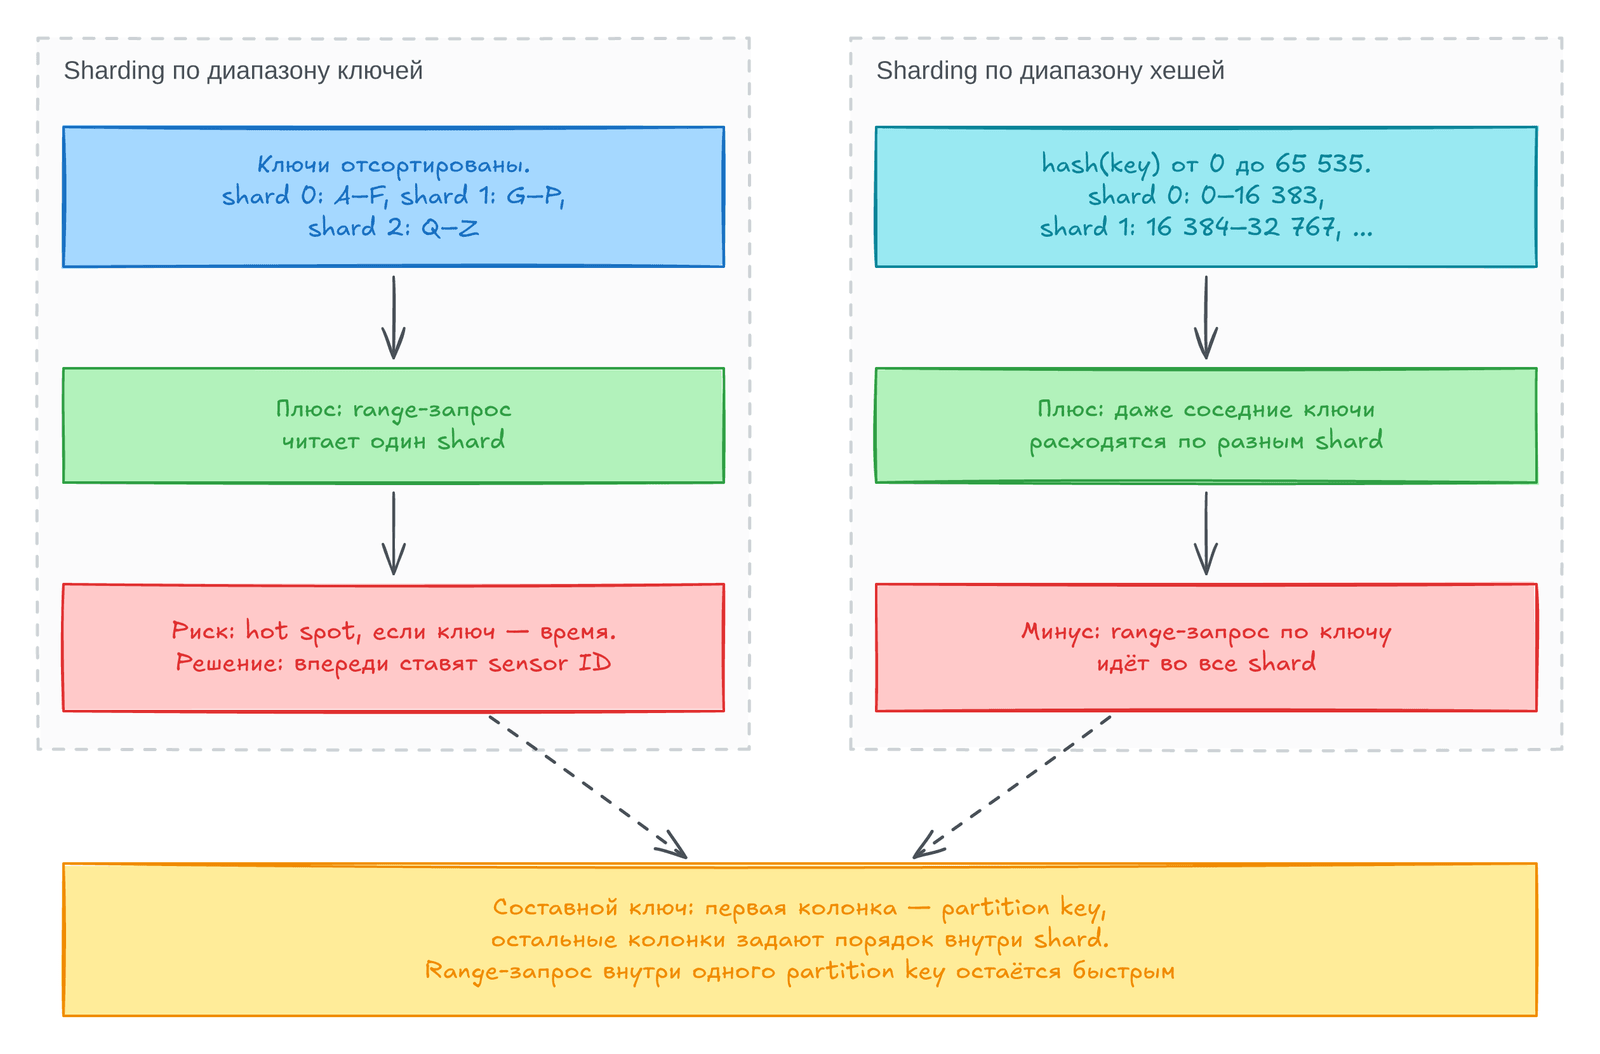
Схема сравнивает два главных способа деления. Слева ключи отсортированы, справа их сначала пропускают через хеш-функцию. Внизу — составной ключ: первая часть ключа выбирает место записи, остальные задают порядок внутри.
Sharding и репликация
Заголовок раздела «Sharding и репликация»Распределённая база раскладывает данные по узлам двумя способами. Репликация хранит одну запись на нескольких узлах. Sharding делит данные на части, и разные части лежат на разных узлах. Каждая запись принадлежит ровно одному shard, так что каждый shard — это маленькая отдельная база.
Обычно оба способа сочетают: копии каждого shard лежат на нескольких узлах ради отказоустойчивости. При репликации с одним leader узел может быть leader для одних shard и follower для других, но у каждого shard только один leader. Схема sharding почти не зависит от схемы репликации, поэтому дальше авторы о репликации не говорят.
Shard, partition и другие названия
Заголовок раздела «Shard, partition и другие названия»В Kafka shard называют partition, в CockroachDB — range, в HBase и TiDB — region, в Cassandra — token-range, в Bigtable, YugabyteDB и ScyllaDB — tablet. В PostgreSQL partitioning и sharding различают: первое делит таблицу на файлы на одной машине (так можно быстро удалить целую часть), второе разносит данные по машинам. Во многих других системах это синонимы.
Слово shard (осколок), по одной версии, пришло из игры Ultima Online: там разбитый кристалл отражал в каждом осколке копию мира, и так назвали параллельные игровые серверы. Не путайте sharding с разрывом сети (network partition): это сбой связи, о нём глава 9.
Плюсы и минусы sharding
Заголовок раздела «Плюсы и минусы sharding»Главная причина делить базу — масштабирование: объём данных или throughput записи стали слишком велики для одного узла. Если не хватает только скорости чтения, хватит реплик из главы 6. Sharding — один из основных способов горизонтального масштабирования (scale-out): систему растят не большей машиной, а новыми машинами, и каждая обрабатывает свои shard параллельно.
Авторы называют sharding тяжёлым решением для большого масштаба. Если одна машина справляется (а сегодня она может очень много), лучше обойтись без него, потому что sharding добавляет сложность:
- Нужно выбрать
partition key— поле, по которому запись попадает вshard. Если ключ известен, запись находится быстро. Если нет, приходится искать во всехshard. Сменить схему потом трудно. - Реляционные данные делить труднее, чем «ключ — значение»: поиск по вторичному индексу и
joinзадевают разныеshard. - Запись может задеть несколько
shard. Тогда нужна распределённая транзакция. Она обычно намного медленнее локальной и может стать узким местом (см. главу 8).
Иногда sharding применяют даже на одной машине. Redis, VoltDB и FoundationDB запускают по однопоточному процессу на ядро CPU, и каждый процесс держит свои shard.
Sharding для multitenancy
Заголовок раздела «Sharding для multitenancy»SaaS-сервисы часто многоарендные (multitenant). Tenant — это клиент-организация со своими пользователями и своими данными, отдельными от чужих. Например, в сервисе email-рассылок каждая компания — отдельный tenant. Такие системы иногда строят на sharding: у каждого tenant свой shard, или мелкие tenant делят один. Что это даёт:
| Плюс | Что даёт |
|---|---|
| Изоляция ресурсов | Тяжёлый запрос одного клиента меньше тормозит других |
| Изоляция прав | Ошибка в проверке доступа реже открывает чужие данные |
Cell-based architecture | Сервисы и данные группы клиентов образуют автономную ячейку (cell): сбой в ней не задевает другие |
| Backup по клиенту | Можно восстановить одного клиента, не трогая остальных |
| Требования закона | Запрос по GDPR или CCPA на выгрузку и удаление данных — простая операция над одним shard |
| Место хранения | Shard клиента можно держать в стране, которую требует закон |
| Постепенная миграция схемы | Новую схему выкатывают по одному клиенту и видят ошибку раньше, чем она заденет всех. Но сделать это транзакционно трудно |
Трудности тоже есть. Клиент должен помещаться на один узел, иначе его снова придётся делить. Отдельный shard для каждого мелкого клиента слишком дорог, а в общем shard растущего клиента трудно потом переселить. Функции, которые связывают данные разных клиентов, требуют join между shard.
Sharding данных «ключ — значение»
Заголовок раздела «Sharding данных «ключ — значение»»Цель sharding — разложить данные и запросы по узлам поровну. Тогда в теории 10 узлов хранят в 10 раз больше данных и выдерживают в 10 раз больше запросов, чем один. При добавлении или удалении узла нагрузку нужно снова выровнять: это rebalancing.
Неровное деление называют перекосом (skew), и он сильно снижает пользу от sharding. В худшем случае девять узлов из десяти простаивают, а узким местом становится один занятой. Shard с непропорционально большой нагрузкой — это hot spot, а отдельный горячий ключ (например, знаменитость в соцсети) — hot key.
Значит, нужен алгоритм, который по partition key находит shard. В хранилище «ключ — значение» это весь ключ или его начало, в реляционной модели — любая колонка, не обязательно первичный ключ. Алгоритм должен допускать rebalancing, чтобы снимать hot spot.
Sharding по диапазону ключей
Заголовок раздела «Sharding по диапазону ключей»Каждый shard получает непрерывный диапазон ключей, как том бумажной энциклопедии: чтобы найти статью, берут том, в диапазон которого попадает заголовок. Диапазоны неравные, потому что данные неравномерны: в одном томе две буквы, в другом семь. Границы задаёт администратор (Vitess, слой sharding для MySQL) или сама база (Bigtable, HBase, CockroachDB, FoundationDB, MongoDB в режиме диапазонов).
Внутри shard ключи отсортированы, например в B-tree или SSTable (см. главу 4). Поэтому range scan — чтение диапазона ключей — простой: если ключ — время замера датчика, легко взять все показания за месяц.
Минус в том, что соседние ключи создают hot spot. Если ключ — время, все свежие записи идут в shard текущего месяца, а остальные простаивают. Решение — поставить в начало ключа ID датчика, а время — вторым. Тогда записи многих датчиков расходятся по разным shard, но чтение нескольких датчиков за период требует отдельного запроса на каждый датчик.
Rebalancing при делении по диапазону
Заголовок раздела «Rebalancing при делении по диапазону»Когда базу только создают, диапазонов ключей ещё нет, и делить нечего. HBase и MongoDB позволяют заранее создать shard в пустой базе (pre-splitting), но для этого нужно знать, как лягут ключи. Дальше большой shard делят на части с непрерывными поддиапазонами и раздают их узлам, а маленькие соседние shard сливают. Так же делятся и сливаются страницы на верхнем уровне B-tree.
База обычно делит shard по размеру (в HBase по умолчанию 10 GB) или, в некоторых системах, по долгой высокой нагрузке на запись. Так горячий shard делится, даже если данных в нём мало. Плюс подхода в том, что число shard следует за объёмом данных: при малом объёме частей мало и накладные расходы малы, при большом размер каждой части ограничен. Минус в цене: деление переписывает все данные shard в новые файлы, как compaction. А делить обычно приходится как раз нагруженный shard, и деление может его перегрузить.
Sharding по хешу ключа
Заголовок раздела «Sharding по хешу ключа»Если близость ключей не важна (например, это ID клиентов), ключ сначала хешируют. Хорошая хеш-функция превращает неравномерные данные в равномерные: даже похожие строки получают далёкие хеши от 0 до 2³² − 1, но одна строка всегда даёт один хеш.
Криптостойкость не нужна: MongoDB берёт MD5, Cassandra и ScyllaDB — Murmur3. А встроенные функции вроде Object.hashCode() в Java не годятся: у одного ключа в разных процессах может быть разный хеш.
Пояснение: то же верно для
hash()в Python, поэтому в примере кода ниже мы берём MD5.
Хеш по модулю числа узлов
Заголовок раздела «Хеш по модулю числа узлов»Первая мысль — номер узла hash(key) % N. Но при смене числа узлов N переезжает большинство ключей. Было три узла, и узел 0 хранил хеши 0, 3, 6, 9. После добавления четвёртого хеш 3 уходит на узел 3, хеш 6 — на узел 2, хеш 9 — на узел 1. Нужен способ, который двигает как можно меньше данных.
Фиксированное число shard
Заголовок раздела «Фиксированное число shard»Популярное решение — создать гораздо больше shard, чем узлов. Например, 10 узлов сразу получают 1000 shard, по 100 на узел. Ключ лежит в shard номер hash(key) % 1000, а система отдельно помнит, какой shard на каком узле. Новый узел забирает часть shard у старых. Привязка ключей к shard не меняется, а переносить целые shard дешевле, чем делить. Пока перенос идёт по сети, запросы работают по старому распределению.
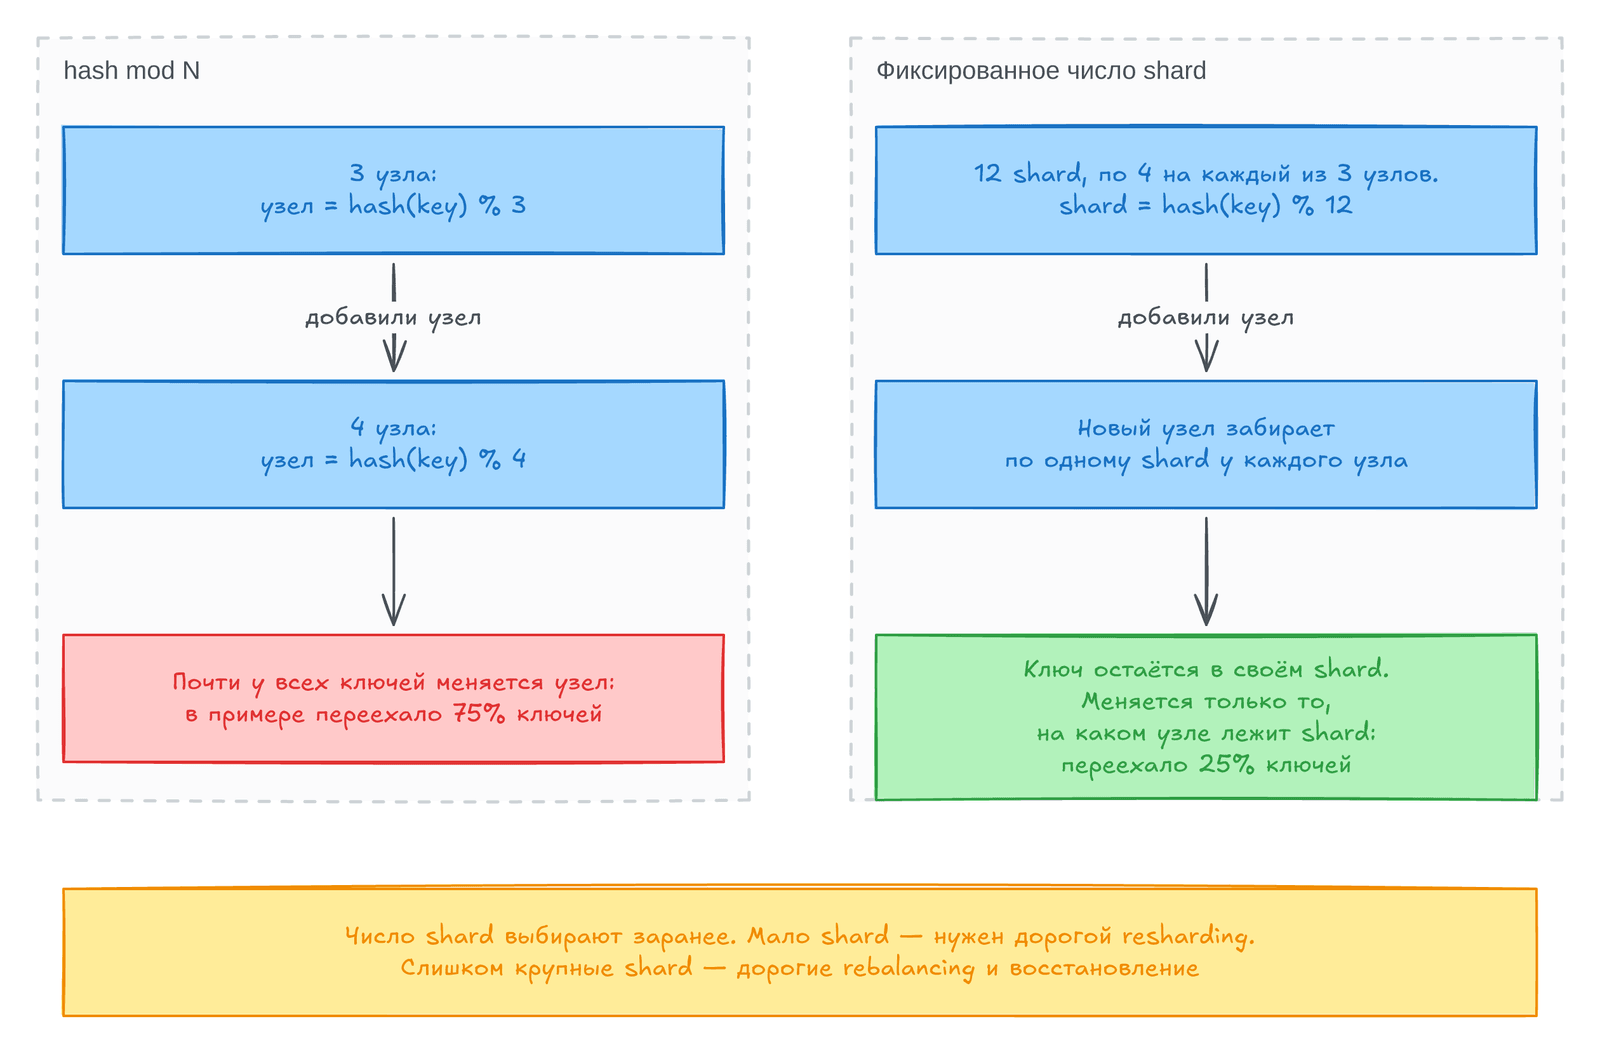
Слева при mod N у большинства ключей меняется узел. Справа новый узел просто забирает несколько целых shard. Цифры — из нашего примера кода в конце страницы.
Число shard удобно брать с многими делителями, чтобы ровно делить его на разное число узлов. Мощным машинам можно дать больше shard. Так работают Citus (sharding для PostgreSQL), Riak, Elasticsearch и Couchbase.
Подход хорош, если число shard угадали заранее: узлов не может быть больше, чем shard. Иначе нужен дорогой resharding, который делит и переписывает каждый shard, а некоторые системы не дают делать его во время записи. Трудно и при меняющемся объёме: размер shard растёт вместе с данными. Большие shard дорого переносить и восстанавливать, а маленькие дают накладные расходы.
Sharding по диапазону хешей
Заголовок раздела «Sharding по диапазону хешей»Если число shard нельзя предсказать, деление по диапазону ключей совмещают с хешем: каждый shard получает диапазон значений хеша. Например, 16-битный хеш даёт числа от 0 до 65 535: shard 0 берёт 0–16 383, shard 1 — 16 384–32 767 и так далее. Соседние метки времени получают далёкие хеши. Большой или нагруженный shard можно разделить, поэтому число shard следует за объёмом данных.
Минус в том, что range-запросы по partition key идут во все shard. Но если ключ составной и partition key — только первая колонка, то range-запросы по остальным колонкам быстрые: все такие записи лежат в одном shard.
Похожий приём есть в хранилищах данных. В BigQuery partition key выбирает часть таблицы, а cluster columns задают порядок внутри неё. Snowflake сам раскладывает записи по micro-partitions, но даёт задать cluster key, как и Delta Lake. Кластеризация ускоряет range scan и фильтры и улучшает компрессию.
По диапазонам хешей делят YugabyteDB и DynamoDB, а в MongoDB это опция. Cassandra и ScyllaDB режут пространство хешей на диапазоны со случайными границами: по умолчанию 16 на узел в Cassandra и 256 в ScyllaDB. Диапазоны разного размера, но их много, и неровности сглаживаются. Новый узел забирает у старых части их диапазонов и получает примерно честную долю данных.
Consistent hashing
Заголовок раздела «Consistent hashing»Consistent hashing — это алгоритм, который раскладывает ключи по shard поровну и при смене числа shard переносит как можно меньше ключей. Слово consistent здесь не связано ни с согласованностью реплик, ни с ACID: алгоритм просто старается оставить ключ на месте. Схема Cassandra близка к исходному определению. В других алгоритмах (rendezvous hashing, jump consistent hashing) новый узел получает не части диапазонов, а отдельные ключи со всех узлов.
Перекос нагрузки и hot spot
Заголовок раздела «Перекос нагрузки и hot spot»Ровное число ключей ещё не значит ровную нагрузку. Пост знаменитости с миллионами подписчиков вызывает шквал чтений и записей по одному ключу. При делении по диапазонам такой ключ можно вынести в отдельный shard и даже на отдельную машину.
Можно помочь и в приложении: к горячему ключу добавляют две случайные цифры, и записи расходятся по 100 ключам в разных shard. Цена приёма:
- Чтение собирает данные из всех 100 ключей. Делится только запись, нагрузка чтения не падает.
- Делить стоит лишь немногие горячие ключи, поэтому нужно помнить, какие ключи разделены.
- Нагрузка меняется: вирусный пост горяч пару дней. Ключи, горячие для чтения и для записи, требуют разных приёмов.
Некоторые облачные сервисы справляются с перекосом сами: у Amazon это heat management или adaptive capacity.
Rebalancing: автоматически или вручную
Заголовок раздела «Rebalancing: автоматически или вручную»Одни системы сами делят и переносят shard, другие оставляют это администратору. Couchbase и Riak выбрали середину: предлагают план, но ждут подтверждения человека. Автоматика удобна: меньше рутины, а DynamoDB обещает добавлять и убирать shard за минуты.
Но rebalancing дорог: нужно перенаправить запросы и перенести много данных. Это нагружает сеть и узлы, а у предела throughput деление shard может не успевать за записями. Опаснее всего автоматика вместе с автоматическим обнаружением сбоев. Перегруженный узел отвечает медленно, другие считают его мёртвым и переносят с него нагрузку. От этого перегружаются уже они, и начинается каскадный сбой.
Поэтому человек в процессе rebalancing полезен: медленнее, но без сюрпризов. Ручной rebalancing полезен и для того, чтобы заранее разгрузить узлы перед известным пиком вроде Cyber Monday.
Маршрутизация запросов
Заголовок раздела «Маршрутизация запросов»Остаётся вопрос: к какому узлу (IP-адресу и порту) идти за ключом? Это маршрутизация запросов (request routing). Она похожа на поиск сервисов (service discovery), но есть отличие. Экземпляры сервиса обычно не хранят состояние, и load balancer шлёт запрос любому. В базе с sharding запрос по ключу обработает только узел с репликой нужного shard. Есть три подхода:
- Через любой узел (например,
round-robin load balancer). Если у узла нет нужногоshard, он пересылает запрос владельцу и возвращает ответ клиенту. - Через
routing tier. Отдельный слой сам запросы не обрабатывает, а работает какload balancer, который знает проshard. - Клиент знает карту и подключается к нужному узлу напрямую.
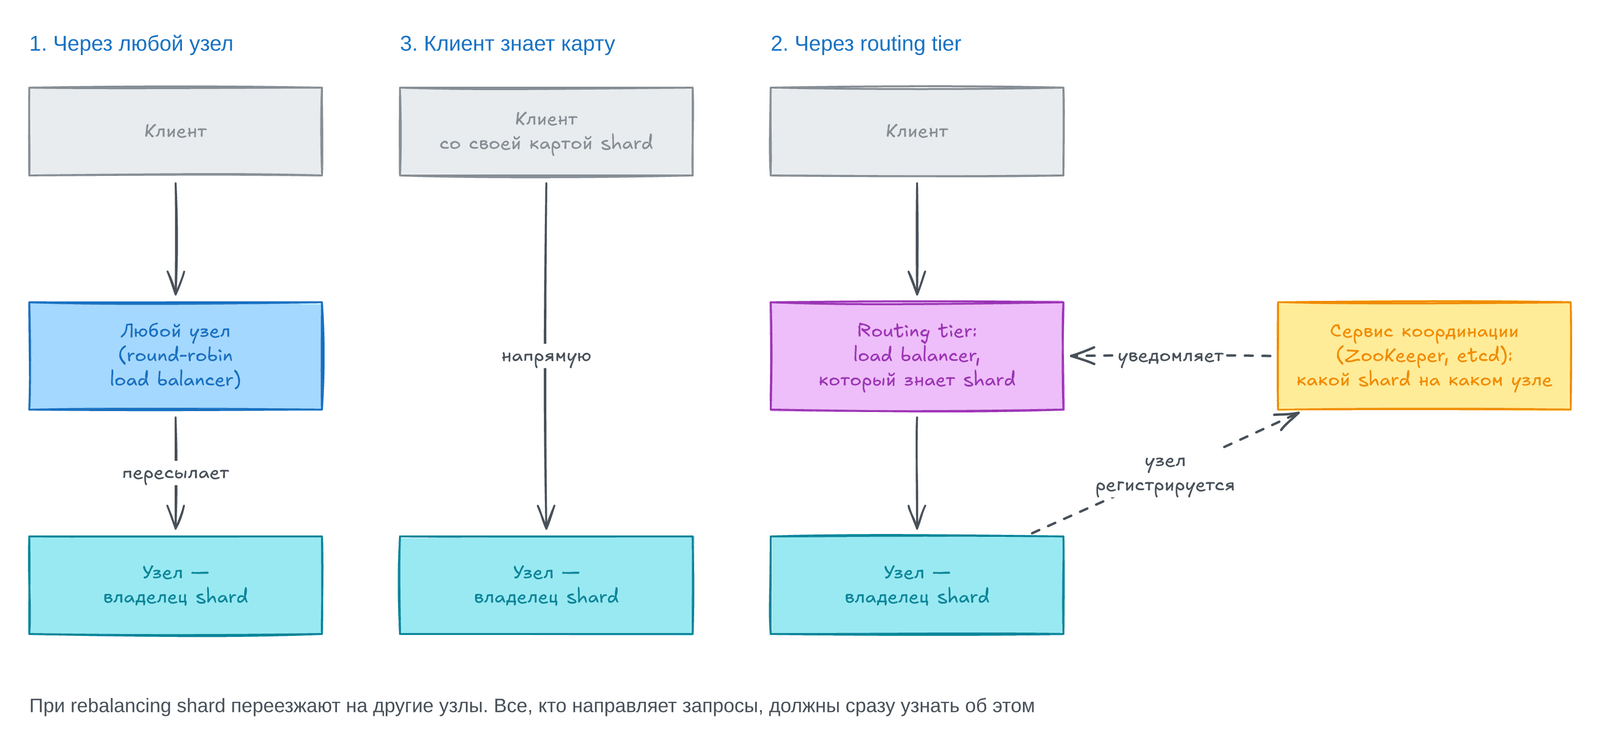
Три способа стоят в колонках. Справа — сервис координации: узлы регистрируются в нём, а он уведомляет routing tier об изменениях.
У всех подходов общие трудные вопросы. Кто решает, где живёт shard? Один координатор проще всего, но он может упасть, а при смене координатора возможен split brain — два координатора с противоречивыми решениями. Как маршрутизатор узнаёт об изменениях? И что делать с запросами, которые ещё идут к старому узлу, когда shard уже переехал?
Многие системы хранят карту shard в сервисе координации — ZooKeeper или etcd. Он использует консенсус (см. главу 10), чтобы пережить сбои и не допустить split brain. Узлы регистрируются в ZooKeeper, а routing tier или клиент подписываются на карту и получают уведомления о каждом изменении.
| Система | Кто хранит карту shard |
|---|---|
| HBase, SolrCloud | ZooKeeper |
| MongoDB | свой config server, mongos как routing tier |
| Kafka, YugabyteDB, TiDB, ScyllaDB | встроенный протокол Raft |
| Riak | gossip protocol между узлами |
В Riak узлы передают друг другу состояние кластера по gossip protocol, как слухи. Это гораздо слабее консенсуса: разные части кластера могут считать владельцами одного shard разные узлы. Базы без leader это терпят, потому что и так дают слабые гарантии. IP-адреса узлов клиенты обычно находят через DNS: адреса меняются реже карты shard.
Всё это касается поиска одного ключа в OLTP-базе. В аналитических базах запрос обычно параллельно собирает данные из многих shard, это тема главы 11.
Sharding и вторичные индексы
Заголовок раздела «Sharding и вторичные индексы»Схемы выше работают, если известен partition key записи. Вторичный индекс устроен иначе: он ищет все вхождения значения, например все красные машины или все статьи со словом «чепуха». В реляционных и документных базах такие индексы — стандарт, а для Solr и Elasticsearch — смысл существования. Но на shard вторичный индекс сам не ложится. Есть два подхода.
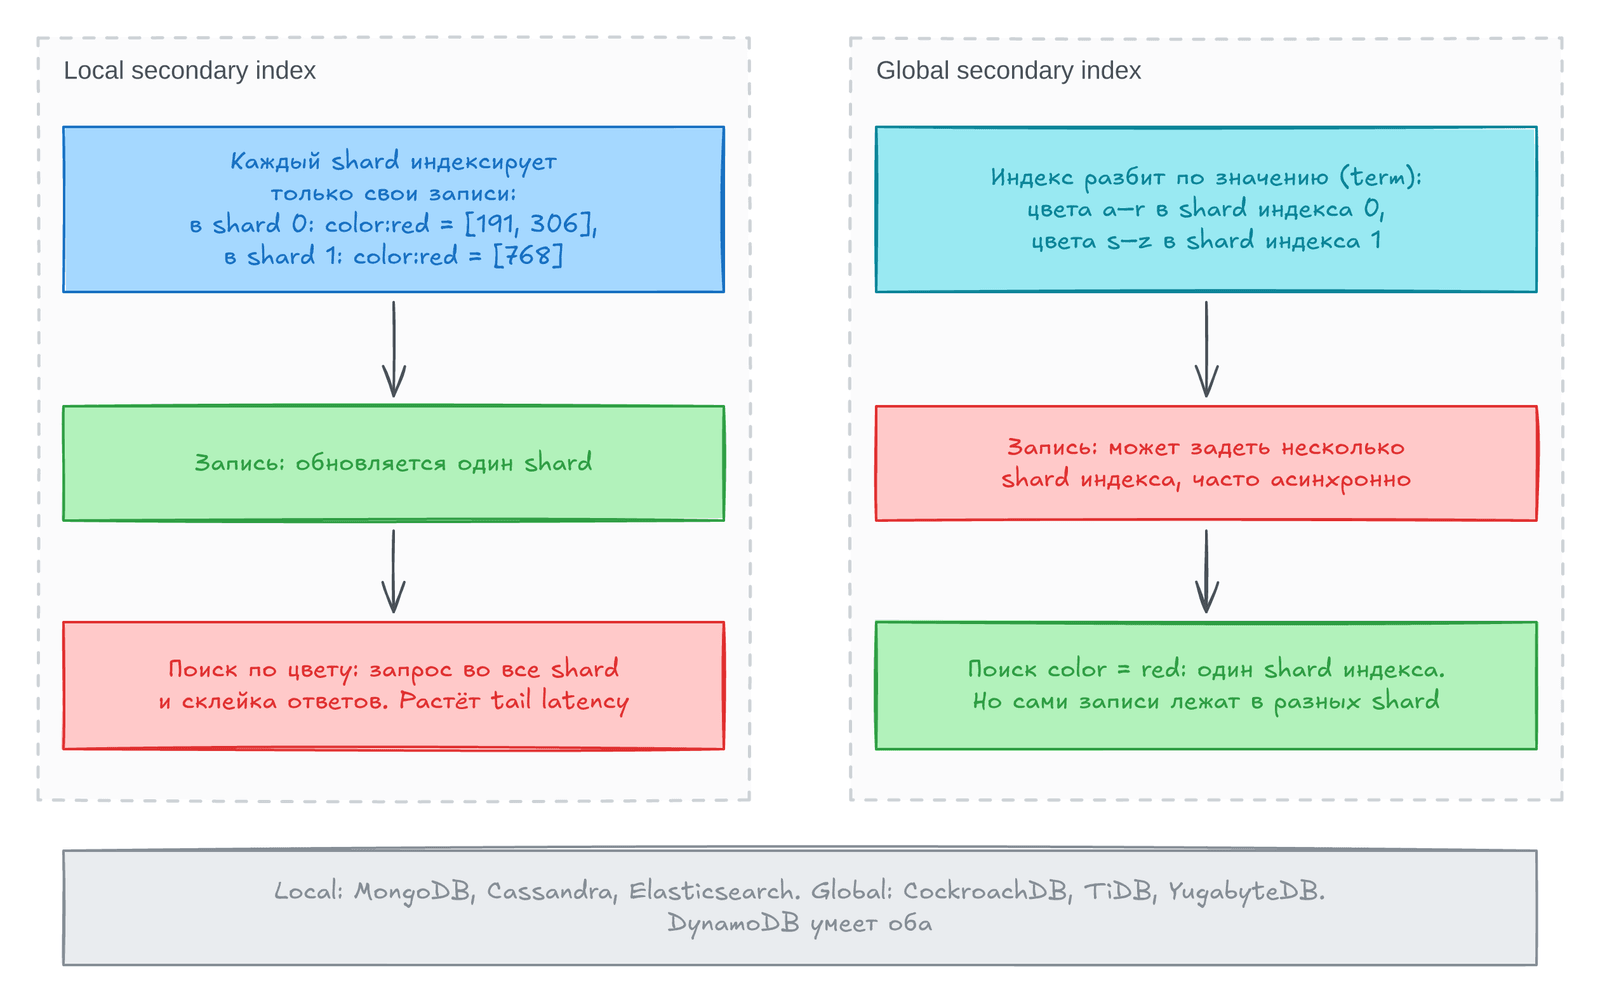
Слева локальный индекс: запись дешёвая, поиск идёт во все shard. Справа глобальный: поиск по одному условию читает один shard индекса, зато запись дороже.
Локальные вторичные индексы
Заголовок раздела «Локальные вторичные индексы»Каждый shard ведёт индекс только по своим записям, поэтому запись обновляет один shard. Это локальный индекс (local index), в информационном поиске — document-partitioned index.
Пример — сайт подержанных машин. ID объявления служит partition key: ID 0–499 в shard 0, 500–999 в shard 1. Для фильтров нужны индексы по цвету и марке. Когда добавляют красную машину, shard дописывает её ID в список color:red. Такой список ID называют postings list.
Авторы предупреждают: не пишите вторичный индекс сами в коде приложения поверх «ключ — значение». Гонки и частичные отказы при записи легко рассинхронизируют индекс и данные.
Если partition key известен, ищут в одном shard. Если нужна лишь часть результатов, хватит любого shard. Но для всех красных машин запрос идёт во все shard, а ответы склеивают. Это дорого: растёт tail latency, ведь ответ ждёт самый медленный shard. Новые shard добавляют места, но не throughput запросов, потому что каждый shard обрабатывает каждый запрос. Всё же локальные индексы есть в MongoDB, Riak, Cassandra, Elasticsearch, SolrCloud и VoltDB.
Глобальные вторичные индексы
Заголовок раздела «Глобальные вторичные индексы»Глобальный индекс (global index) покрывает данные всех shard. На одном узле он станет узким местом, поэтому его тоже делят, но по значению, а не так, как данные. В примере все красные машины собраны под color:red: цвета на a–r лежат в shard индекса 0, на s–z — в shard 1.
Такой индекс называют term-partitioned: term — любое искомое значение. Это значение служит partition key индекса, по диапазону или по хешу. Поэтому запрос с одним условием (color = red) читает postings list из одного shard. Но сами записи всё равно лежат в разных shard.
Минусы:
- Несколько условий. Цвет и марка лежат в разных
shardиндекса. Для AND нужно пересечь дваpostings list, а длинные списки долго передавать по сети. - Сложная запись. Одна запись задевает несколько
shardиндекса, и держать их в согласии с данными трудно. Один выход — распределённая транзакция (глава 8).
Глобальные индексы есть в CockroachDB, TiDB и YugabyteDB, а DynamoDB умеет оба вида. В DynamoDB глобальный индекс обновляется асинхронно и может отдавать устаревшие данные, как при replication lag. Глобальные индексы полезны, если чтений больше, чем записей, и postings list не слишком длинные.
Итоги главы
Заголовок раздела «Итоги главы»Shardingнужен, когда одна машина не выдерживает данные или записи. Если выдерживает, лучше обойтись без него.- Цель — ровно разложить данные и запросы и избежать
hot spot. - При делении по диапазону ключей
range-запросы быстрые, но соседние ключи создаютhot spot. Большойshardделят на два. - Хеш теряет порядок ключей, зато выравнивает нагрузку. Часто заранее создают фиксированное число
shardи переносят их целиком. - Составной ключ сочетает оба подхода: первая часть выбирает
shard, остальные задают порядок внутри. - Запрос находит узел через любой узел,
routing tierили клиента с картой. Карту часто хранит сервис координации. - Локальный индекс пишет в один
shard, но читает из всех. Глобальный читает из одного, но пишет в несколько. - Запись сразу в несколько
shard— трудный случай: что делать, если в одну часть запись прошла, а в другую нет? Ответ — в следующих главах.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
shard | Часть данных; каждая запись лежит ровно в одном shard |
partition key | Поле, по которому выбирают shard |
skew | Перекос данных или запросов |
hot spot / hot key | Shard или ключ с непропорционально большой нагрузкой |
rebalancing | Перенос shard между узлами |
resharding | Смена числа shard с перезаписью данных |
consistent hashing | Хеширование, при котором при смене числа shard переезжает минимум ключей |
routing tier | Слой, который знает карту shard и пересылает запросы |
split brain | Два координатора одновременно принимают решения |
| local / global secondary index | Индекс внутри shard / индекс, поделённый по значению |
postings list | Список ID записей с данным значением |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Выбирайте ключ под запросы. Деление по дате создаёт
hot spotна последнем периоде. Добавьте в начало ключа источник или user ID. Partitionв хранилищах и lakehouse. Деление по дате удобно для диапазонов и удаления старых данных, но мелкие части дают много маленьких файлов.- Следите за
skew. Один огромный ключ тормозитjoin. Решение — salting (случайный суффикс), но читать придётся все части. - Считайте цену индексов. Локальный удешевляет запись, глобальный — чтение, но может отставать.
- Не используйте
hash mod N. Берите фиксированное числоshardили диапазоны хешей. Rebalancingв продакшене планируйте вне пиков и не оставляйте автоматику без контроля человека.Partitionв Kafka — тот жеshard: порядок есть только внутри него, а ключ сообщения выбираетpartition.- Не делите базу раньше времени: сначала реплики для чтения и машина покрупнее.
Пример кода: сколько данных переезжает
Заголовок раздела «Пример кода: сколько данных переезжает»Посчитаем на 10 000 ключах, сколько из них сменит узел, когда к трём узлам добавят четвёртый. Скрипт: scripts/ddia-code/ch07_rebalance.py, нужен только Python 3.
# Глава 7: сколько ключей переезжает, когда в кластер из 3 узлов добавляют 4-й.import hashlib
def h(key):  # стабильный хеш: одинаковый в любом процессе (в отличие от hash() в Python)    return int(hashlib.md5(key.encode()).hexdigest(), 16)
keys = [f"user:{i}" for i in range(10_000)]
# 1. hash mod N: номер узла = хеш по модулю числа узловmoved = sum(h(k) % 3 != h(k) % 4 for k in keys)print(f"hash mod N:          переехало {moved / len(keys):.0%} ключей")
# 2. Фиксированное число shard: ключ -> shard не меняется, новый узел забирает целые shardSHARDS = 12old = {s: s % 3 for s in range(SHARDS)}             # по 4 shard на узелnew = dict(old)for s in (0, 1, 2):                                 # узлы 0, 1, 2 отдают по одному shard узлу 3    new[s] = 3moved = sum(old[h(k) % SHARDS] != new[h(k) % SHARDS] for k in keys)print(f"фиксированные shard: переехало {moved / len(keys):.0%} ключей")
hash mod N: переехало 75% ключейфиксированные shard: переехало 25% ключейС фиксированными shard переезжает только та четверть ключей, которую должен получить новый узел.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Когда
shardingоправдан, а когда хватит одной машины? - Почему время в начале ключа создаёт
hot spotи чем придётся заплатить за исправление? - Почему
hash mod Nплох дляrebalancingи когда фиксированное числоshardсамо становится проблемой? - Почему автоматический
rebalancingс автоматическим обнаружением сбоев может вызвать каскадный сбой? - Когда выбрать локальный вторичный индекс, а когда глобальный?
Предыдущая: Репликация. Следующая: Транзакции.