

Designing Data-Intensive Applications, глава 5: Кодирование данных и изменение схем
Главная мысль: приложение меняется постоянно, но старый и новый код, старые и новые данные долго живут рядом. Поэтому формат, в котором данные превращаются в байты, должен давать совместимость в обе стороны: новый код читает старые данные, а старый код читает новые.
О чём глава
Заголовок раздела «О чём глава»Глава отвечает на вопрос: как хранить и передавать данные, чтобы систему можно было менять по частям, без остановки. В главе 2 это свойство названо evolvability, то есть простотой изменений. В главе 3 мы видели, что реляционная база держит одну схему, а документная (schema-on-read) хранит смесь старых и новых форматов. Теперь вопрос шире: как код и данные разных версий понимают друг друга.
Темы главы:
backward compatibilityиforward compatibility;- форматы конкретного языка, JSON, XML, CSV и JSON Schema;
- бинарные форматы со схемой: Protocol Buffers и Avro;
- четыре пути данных: через базу, через сервисы (REST и RPC), через
workflow engineи черезmessage broker.
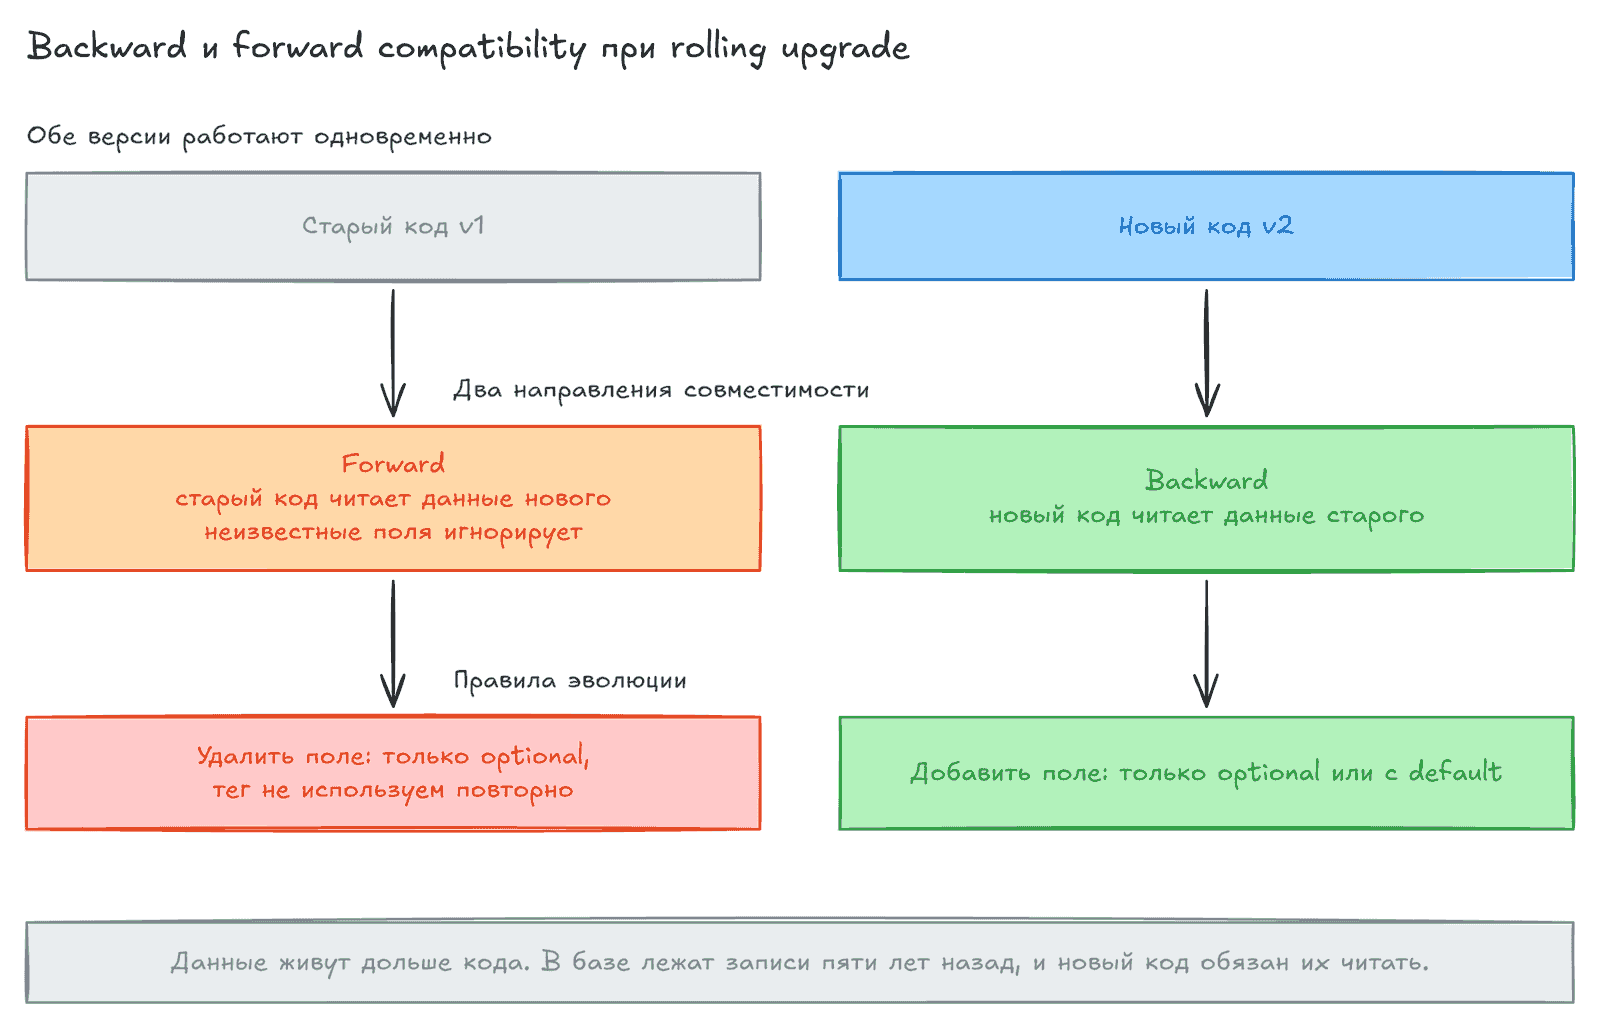
Слева старый код читает данные нового (forward), справа новый код читает данные старого (backward). Внизу правила, которые сохраняют эти свойства.
Совместимость в обе стороны
Заголовок раздела «Совместимость в обе стороны»Новое поле в данных обычно требует нового кода. Но в большом приложении код нельзя обновить везде в один момент:
- На сервере делают
rolling upgrade(staged rollout): новую версию ставят на несколько узлов, проверяют и идут дальше. Релиз проходит без простоя, поэтому релизы можно делать чаще. - Клиентское приложение обновляет пользователь, и он может долго этого не делать.
Значит, старый и новый код, а также старые и новые форматы живут вместе. Нужна совместимость в двух направлениях:
| Свойство | Что гарантирует |
|---|---|
backward compatibility | Новый код читает данные, которые записал старый код |
forward compatibility | Старый код читает данные, которые записал новый код |
Для API так: если старый клиент вызывает новый сервис, нужна backward compatibility для запроса и forward compatibility для ответа. Если новый клиент вызывает старый сервис, всё наоборот.
Backward compatibility получить обычно легко: автор нового кода знает старый формат и может его обработать. С forward compatibility сложнее, потому что старый код должен спокойно пропускать то, что добавила новая версия.
Есть и ловушка. Новый код сохранил запись с новым полем. Старый код прочитал её, поменял другое поле и записал обратно. Если запись превратилась в объект, который не хранит неизвестные поля, новое поле молча пропадёт.
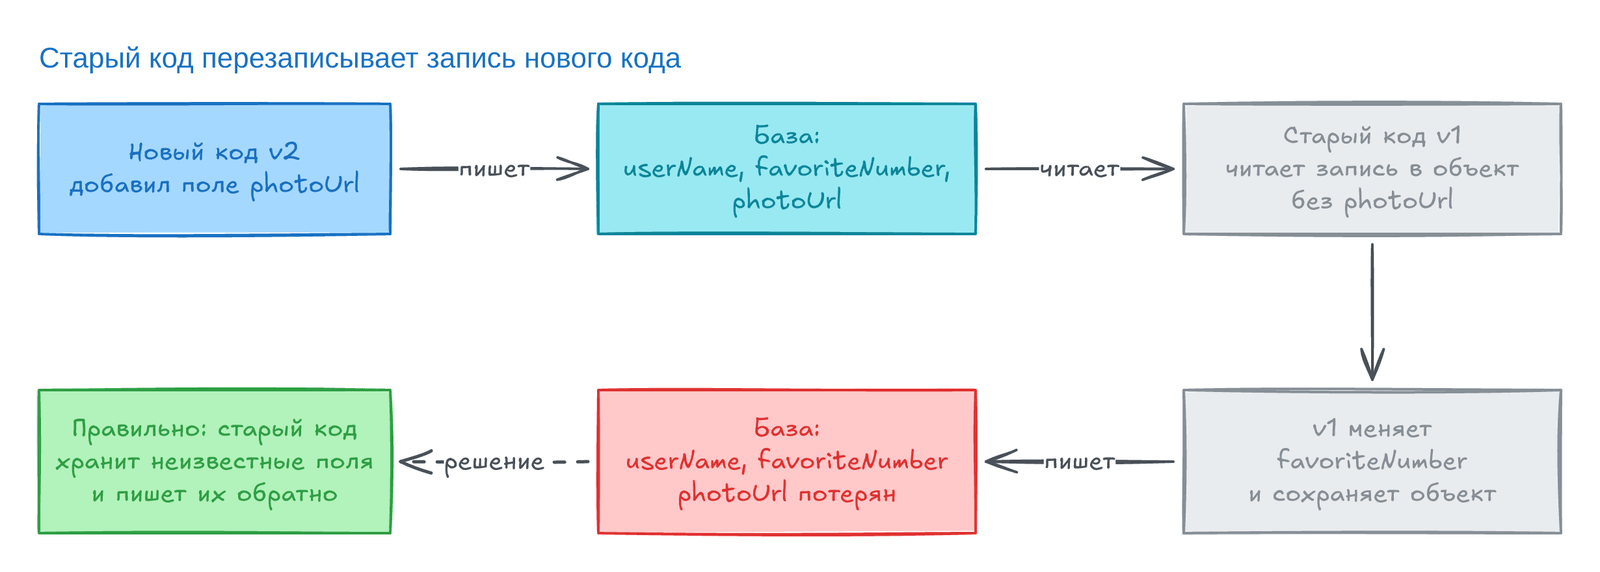
Идите по стрелкам: запись с полем photoUrl проходит через старый код и возвращается в базу уже без него. Зелёный блок показывает, как этого избежать.
Форматы кодирования данных
Заголовок раздела «Форматы кодирования данных»Программа держит данные в двух видах. В памяти это объекты, списки, хеш-таблицы и деревья с указателями, удобные процессору. В файле или в сети это цельная последовательность байтов, например документ JSON. Указатель для другого процесса ничего не значит, поэтому два вида сильно отличаются.
Перевод из памяти в байты называется кодированием (encoding), его также называют serialization или marshaling. Обратный перевод — это декодирование (decoding, parsing, unmarshaling). Авторы выбирают слово encoding, потому что serialization в теории транзакций (глава 8) значит совсем другое.
Иногда перевод не нужен: база может работать прямо с данными в том виде, в каком они лежат на диске (глава 4). Есть и zero-copy форматы (Cap’n Proto, FlatBuffers), которые одинаковы в памяти, на диске и в сети. Но большинству систем перевод нужен.
Форматы конкретного языка
Заголовок раздела «Форматы конкретного языка»Во многих языках кодирование встроено: java.io.Serializable в Java, pickle в Python, Marshal в Ruby. Это удобно, но у таких форматов глубокие проблемы:
- Данные трудно прочитать на другом языке, и вы надолго привязаны к своему.
- Декодер должен уметь создавать объекты любых классов. Злоумышленник может подсунуть свои байты и часто выполнить свой код на сервере.
- Совместимость версий в них обычно продумана плохо.
- Скорость и размер тоже не в приоритете: встроенный
Serializableв Java известен медленной работой и раздутым результатом.
Вывод авторов: встроенное кодирование языка годится только для очень временных задач.
JSON, XML и CSV
Заголовок раздела «JSON, XML и CSV»Если данные читают многие языки, первые кандидаты — JSON и XML. CSV тоже не зависит от языка, но хранит только плоские таблицы. Все три формата текстовые и отчасти читаются человеком, но у них есть проблемы:
- Числа. В XML и CSV число не отличить от строки из цифр без внешней схемы. JSON не отличает целые от дробных и не задаёт точность. Целые больше 2⁵³ не помещаются без потерь в
double, поэтому JavaScript читает их неточно. Например, X (бывший Twitter) отдаёт 64-битный ID поста дважды: числом и строкой. - Бинарные строки. JSON и XML не хранят байты без кодировки. Их обходят через Base64, но это костыль, и размер растёт примерно на треть.
- Схемы. XML Schema и JSON Schema мощные и поэтому сложные. Без них правила кодирования чисел и байтов приходится зашивать в код.
- CSV схемы не имеет вовсе: смысл столбцов знает только приложение. Формат ещё и расплывчат: не все парсеры правильно обрабатывают запятую или перевод строки внутри значения.
XML к тому же часто ругают за многословность. И всё же для передачи данных между организациями эти форматы хороши. Если стороны договорились о формате, его красота и компактность почти не важны: договориться разным компаниям труднее всего.
JSON Schema
Заголовок раздела «JSON Schema»JSON Schema стала стандартным способом описать данные, которые передают между системами или хранят. Её используют в OpenAPI и в реестрах схем (schema registry) Confluent и Apicurio. Есть она и в базах: pg_jsonschema в PostgreSQL, $jsonSchema в MongoDB.
Кроме простых типов, схема задаёт ограничения: например, поле port от 1 до 65 535. Модель содержимого бывает открытой (open content model, разрешены любые неописанные поля) или закрытой (только описанные поля). По умолчанию additionalProperties равно true, поэтому схема обычно говорит, что запрещено, а не что разрешено.
Это гибко, но громоздко. Пример из книги: словарь с целыми ключами. Ключи JSON всегда строки, поэтому через patternProperties разрешают ключи только из цифр, а additionalProperties: false запрещает остальное. Добавьте условия if/else и ссылки на внешние схемы, и менять такую схему с сохранением совместимости становится трудно. С XML Schema то же самое.
Бинарные варианты JSON
Заголовок раздела «Бинарные варианты JSON»JSON и XML занимают много места, поэтому появились их бинарные варианты: MessagePack, CBOR, BSON, Smile и другие для JSON, WBXML и Fast Infoset для XML. Ни один не стал так популярен, как текстовые оригиналы. Они иногда расширяют типы, но схемы у них нет, поэтому имена всех полей лежат внутри данных.
Авторы кодируют одну запись разными форматами: userName = «Martin», favoriteNumber = 1337, interests = «daydreaming» и «hacking». В MessagePack первый байт 0x83 значит «объект из трёх полей», второй 0xa8 значит «строка длиной 8 байт», дальше идёт имя userName. Длина известна заранее, поэтому не нужны ни маркер конца, ни экранирование.
| Формат | Размер записи | Что внутри |
|---|---|---|
| JSON без пробелов | 81 байт | Имена полей и значения текстом |
| MessagePack | 66 байт | Имена полей, типы, длины, значения |
| Protocol Buffers | 33 байта | Номера полей, типы, значения |
| Avro | 32 байта | Только значения |
Выигрыш MessagePack мал, и авторы сомневаются, что он стоит потери читаемости. Форматы со схемой кодируют ту же запись вдвое компактнее, чем MessagePack.
Protocol Buffers
Заголовок раздела «Protocol Buffers»Protocol Buffers (protobuf) — это бинарный формат от Google. Он похож на Apache Thrift из Facebook, и почти всё ниже верно и для Thrift. Protobuf требует схему на языке описания интерфейсов (IDL). Для нашей записи это сообщение Person:
| Поле | Тег | Тип |
|---|---|---|
user_name | 1 | string |
favorite_number | 2 | int64 |
interests | 3 | repeated string |
Генератор создаёт из схемы классы на разных языках. Язык схемы проще JSON Schema: только поля и типы, без ограничений на значения.
Запись занимает 33 байта. Имён полей в данных нет. Вместо них стоят теги полей (field tag): числа 1, 2 и 3 из схемы, короткие псевдонимы полей. Тег и тип упакованы в один байт. Целые числа хранятся с переменной длиной (varint): в каждом байте 7 бит числа, а старший бит говорит, будут ли ещё байты. Поэтому 1337 занимает два байта. Списка как типа нет: repeated значит, что тег просто повторяется в записи несколько раз.
Теги полей и schema evolution
Заголовок раздела «Теги полей и schema evolution»Изменение схемы со временем называется schema evolution. Запись в protobuf — это склеенные поля, каждое с тегом и типом, а пустые поля не пишутся. Значит, смысл данных держится на тегах. Имя поля менять можно, тег — нельзя.
- Новое поле получает новый тег. Старый код пропустит незнакомый тег: тип подскажет, сколько байтов пропустить. Парсер может и сохранить такое поле, что решает проблему с рисунка выше. Это
forward compatibility. - Старые данные новый код читает всегда, а отсутствующее новое поле получает значение по умолчанию (пустую строку, 0). Это
backward compatibility. - Удалённое поле — зеркальный случай. Его тег нельзя использовать снова: старые данные с ним где-то лежат. Тег помечают в схеме как
reserved. - Смена типа возможна для некоторых типов, но с риском. Если 32-битное целое стало 64-битным, новый код прочитает старые данные, а старый код обрежет большое число до 32 бит.
Apache Avro появился в 2009 году внутри Hadoop, потому что protobuf плохо подходил под его задачи. У Avro тоже есть схема, причём два языка схемы: Avro IDL для человека и JSON для программ. Как и в protobuf, схема задаёт только поля и типы:
{ "type": "record", "name": "Person", "fields": [ {"name": "userName", "type": "string"}, {"name": "favoriteNumber", "type": ["null", "long"], "default": null}, {"name": "interests", "type": {"type": "array", "items": "string"}} ]}Тегов в схеме нет. Запись занимает 32 байта, это самый компактный вариант. В байтах нет ни имён, ни типов: значения идут подряд. Строка — это длина и байты, но в данных не сказано, что это строка. Целые числа переменной длины: от −64 до 63 занимают байт, до ±8191 два байта.
Разобрать байты можно, только если идти по полям в порядке схемы и брать типы из неё. Значит, читателю нужна ровно та схема, которой писали данные. Как же тогда меняется схема?
Схема писателя и схема читателя
Заголовок раздела «Схема писателя и схема читателя»Приложение кодирует данные той версией схемы, которую знает, например встроенной в код. Это схема писателя (writer's schema). При декодировании нужны две схемы: схема писателя и схема читателя (reader's schema), то есть поля и типы, которых ждёт код. Они могут отличаться. Тогда Avro сравнивает их и переводит данные из схемы писателя в схему читателя. В protobuf при декодировании используется одна схема.
Правила перевода заданы в спецификации Avro:
- Поля сопоставляются по имени, поэтому порядок может быть разным.
- Поле есть у писателя, но нет у читателя: его пропускают.
- Поле нужно читателю, но его нет у писателя: подставляют значение по умолчанию из схемы читателя.
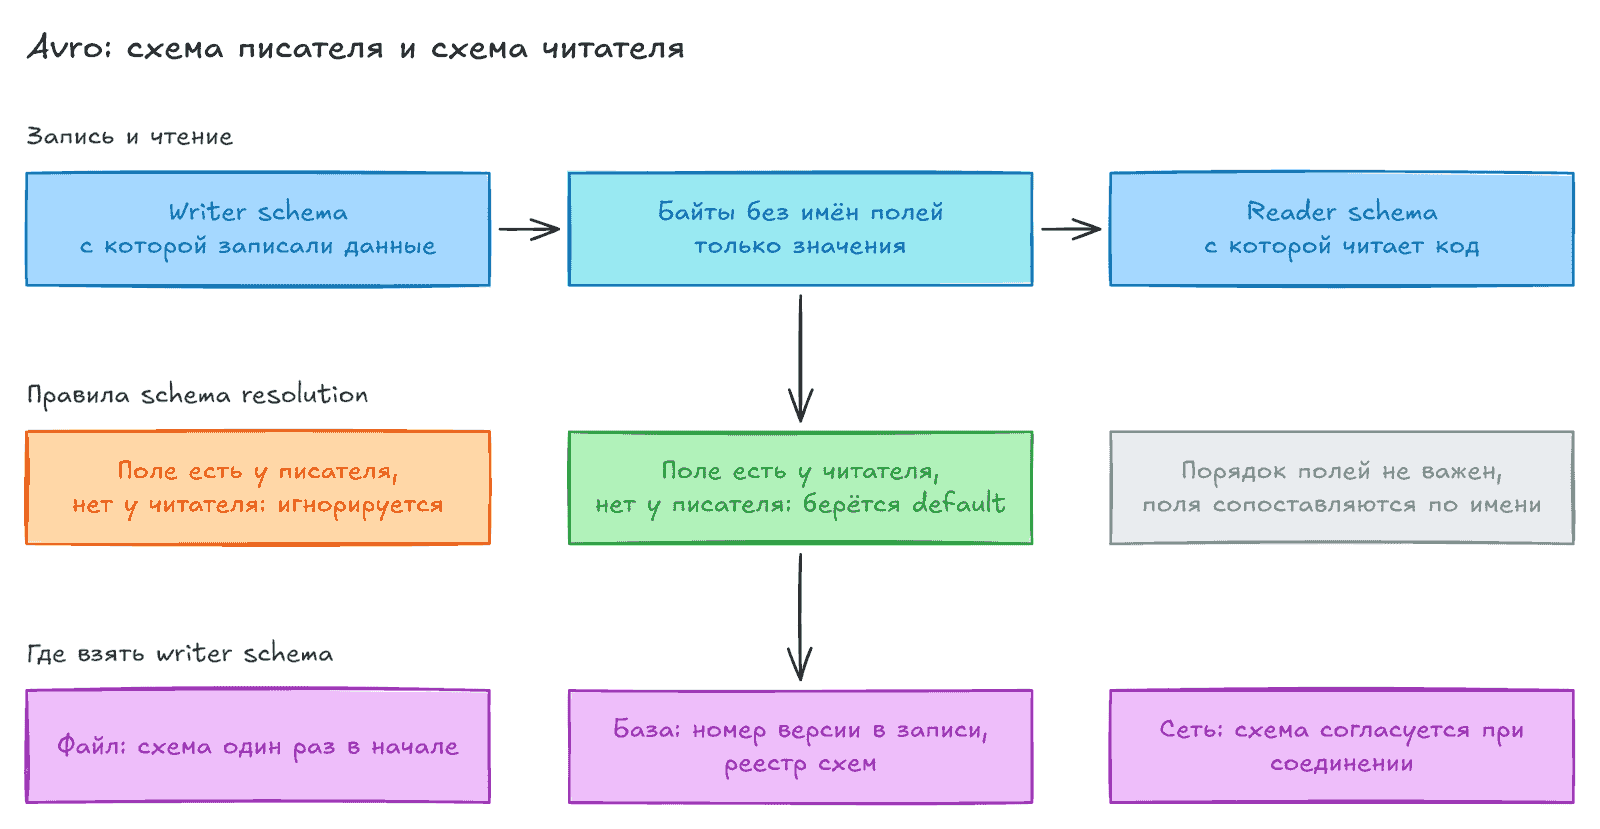
Верхний ряд показывает путь данных, средний — правила перевода, нижний — где читатель находит схему писателя.
Правила schema evolution в Avro
Заголовок раздела «Правила schema evolution в Avro»В Avro forward compatibility значит, что схема писателя новее схемы читателя, а backward compatibility — что старше. Добавлять и удалять можно только поля со значением по умолчанию. Добавили поле без него — новый читатель не прочитает старые данные, и сломается backward. Удалили такое поле — старый читатель не прочитает новые данные, и сломается forward.
Во многих языках любая переменная может быть null, а в Avro поле по умолчанию не может. Чтобы поле могло быть null, нужен union: например, union { null, long, string } значит «число, строка или пустое значение». null может быть значением по умолчанию, только если это первая ветка. Это многословнее, но схема явно говорит, какие поля могут быть пустыми, и это защищает от ошибок.
Тип поля можно сменить, если Avro умеет его переводить. Имя тоже можно сменить через псевдонимы (aliases) в схеме читателя: новый читатель сопоставит старое имя писателя с псевдонимом. Но такая смена совместима только в одну сторону: новый код прочитает старые данные, а старый код новые — нет. То же верно для новой ветки в union.
Откуда читатель знает схему писателя
Заголовок раздела «Откуда читатель знает схему писателя»Класть схему в каждую запись нельзя: она часто больше самих данных. Ответ зависит от того, где работает Avro:
| Где | Как передают схему писателя |
|---|---|
| Большой файл с миллионами записей одной схемы | Схему пишут один раз в начале файла, в формате object container file (см. главу 11) |
| База, где записи пишут по одной | В начало записи кладут номер версии схемы, а версии хранят в базе. Так работают Confluent Schema Registry для Kafka и Espresso в LinkedIn |
| Сетевое соединение | Стороны договариваются о версии при подключении. Так работает Avro RPC |
База версий схем полезна в любом случае: это документация и способ проверять совместимость. Версией служит растущий номер или хеш схемы.
Схемы, созданные программой
Заголовок раздела «Схемы, созданные программой»Отсутствие тегов делает Avro удобным для схем, которые создаёт программа. Пусть нужно выгрузить реляционную базу в бинарный файл. Программа делает схему Avro из каждой таблицы: столбец становится полем с тем же именем. Если в таблице добавили и удалили столбец, программа просто создаст новую схему при следующей выгрузке. Поля опознаются по имени, поэтому новая схема писателя сопоставится со старой схемой читателя.
С protobuf теги пришлось бы назначать вручную и следить, чтобы генератор не выдал уже занятый тег. Protobuf не задумывался для таких схем, а Avro задумывался.
Чем хороши схемы
Заголовок раздела «Чем хороши схемы»Языки схем protobuf и Avro намного проще XML Schema и JSON Schema, поэтому их поддерживает много языков. Идеи не новы: ASN.1 стандартизовали в 1984 году, и его бинарная кодировка DER до сих пор кодирует SSL-сертификаты. ASN.1 тоже меняет схему через теги, но он сложен и плохо документирован. Свои бинарные протоколы есть и у баз данных, а драйверы ODBC и JDBC переводят ответы в структуры в памяти.
У бинарных форматов со схемой несколько плюсов:
- Они компактнее бинарных вариантов JSON, потому что не хранят имён полей.
- Схема — это документация, которая всегда актуальна: без неё данные не прочитать.
- База схем позволяет проверить совместимость до выхода в прод.
- В языках со статической типизацией из схемы генерируют код с проверкой типов при компиляции.
Итог авторов: schema evolution даёт ту же гибкость, что JSON-базы без схемы, но с лучшими гарантиями и инструментами. При этом число одновременно живущих форматов лучше держать минимальным, чтобы не усложнять эксплуатацию.
Пути данных между процессами
Заголовок раздела «Пути данных между процессами»Совместимость — это отношение между процессом, который кодирует данные, и процессом, который их декодирует. Кто есть кто, зависит от пути данных. Глава разбирает четыре пути: база, вызовы сервисов, workflow engine и асинхронные сообщения.
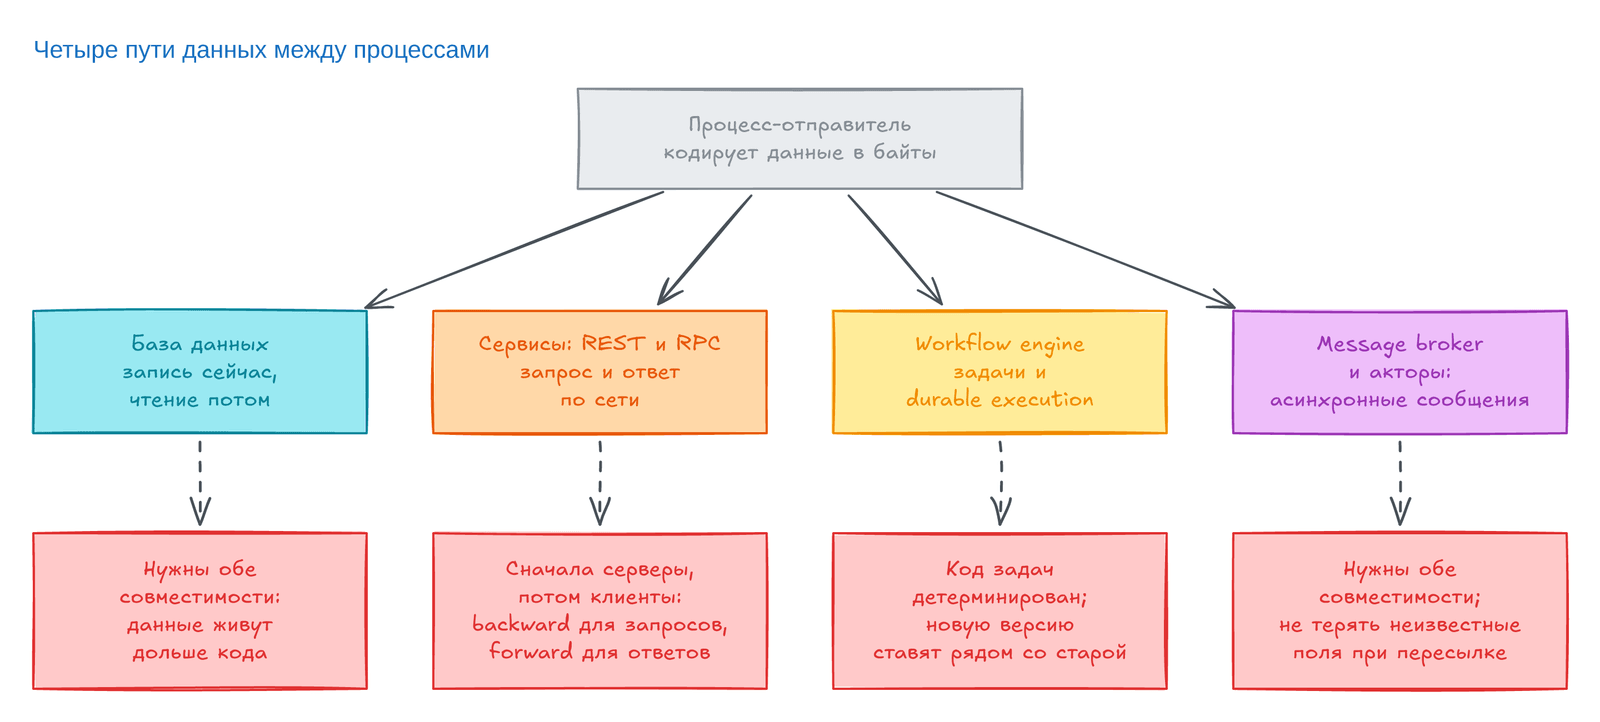
Верхний блок кодирует данные, средний ряд показывает четыре пути, нижний — главное требование каждого пути.
Данные через базу данных
Заголовок раздела «Данные через базу данных»В базе писатель кодирует данные, а читатель декодирует. Если процесс один, то читатель — его будущая версия, и запись в базу похожа на письмо себе в будущее. Здесь нужна backward compatibility. Но обычно с базой работают несколько процессов, и во время rolling upgrade часть из них уже на новом коде. Новый код пишет, старый читает, поэтому нужна и forward compatibility.
Значения, записанные в разное время
Заголовок раздела «Значения, записанные в разное время»В одной базе лежат значения, записанные 5 миллисекунд и 5 лет назад. Код можно заменить за минуты, а старые записи останутся в старой кодировке, пока их явно не перепишут. Это коротко называют «данные живут дольше кода».
Переписать (мигрировать) большой набор данных дорого, поэтому базы делают это фоном. Например, движки на LSM-tree переводят данные в новый формат во время compaction. Реляционные базы умеют добавить столбец со значением null без переписывания: при чтении старой строки они подставят null. Так база выглядит записанной по одной схеме, хотя на диске лежат разные версии. Сложные изменения (поле стало списком, данные переехали в другую таблицу) всё ещё требуют переписать данные, и совместимость при таких миграциях остаётся задачей для исследователей.
Архивное хранение
Заголовок раздела «Архивное хранение»Копию базы для бэкапа или загрузки в хранилище данных (data warehouse) обычно кодируют по последней схеме, даже если в базе лежат записи разных версий. Данные всё равно копируют, поэтому копию разумно привести к одной схеме. Выгрузка пишется один раз и не меняется, поэтому подходят object container file Avro или колоночный Parquet для аналитики. Подробнее об этом в главе 11.
Данные через сервисы: REST и RPC
Заголовок раздела «Данные через сервисы: REST и RPC»Чаще всего процессы в сети делятся на клиентов и серверы. Сервер открывает API, клиент шлёт к нему запросы. Такой API называют сервисом. Так устроен веб: браузер шлёт GET и POST по стандартам HTTP, URL и HTML. Мобильные приложения и JavaScript в браузере тоже ходят на серверы, но получают не HTML для человека, а данные для кода, чаще всего в JSON. Транспортом служит HTTP, но API у каждого приложения свой, и клиент с сервером должны договориться о его деталях.
Сервис похож на базу, но принимает не любые запросы, а только те, что задала его бизнес-логика. Это даёт инкапсуляцию. Цель микросервисов — менять и разворачивать каждый сервис отдельно силами одной команды. Значит, старые и новые версии клиентов и серверов работают вместе, и пока API совместим, команда может менять внутри что угодно.
Веб-сервисы
Заголовок раздела «Веб-сервисы»Сервис на HTTP называют веб-сервисом, хотя работает он не только в вебе. Им пользуются приложения на устройствах пользователей, сервисы внутри одной компании и сервисы разных компаний, например платёжные системы или OAuth.
Самая популярная философия — REST. Она опирается на HTTP: URL обозначает ресурс, а кэширование, аутентификация и тип содержимого берутся из средств HTTP. Такие API называют RESTful.
Чтобы вызвать сервис, клиент должен знать адреса (endpoint) и форматы. Их описывают на IDL: OpenAPI (Swagger) для сервисов на JSON и Protocol Buffers для gRPC. В книге пример на OpenAPI в YAML: сервис «Ping, Pong» на GET /ping отвечает JSON с полем message.
Код сервиса пишут во фреймворке (Spring Boot, FastAPI, gRPC), который берёт на себя маршрутизацию, метрики и аутентификацию. В книге тот же сервис на FastAPI занимает несколько строк. В FastAPI описание IDL генерируется из кода, а в gRPC наоборот: из описания генерируется заготовка сервера. В обоих случаях можно получить клиентские библиотеки, документацию и проверку совместимости изменений.
Проблемы удалённого вызова процедур
Заголовок раздела «Проблемы удалённого вызова процедур»У веб-сервисов было много предшественников с серьёзными проблемами. EJB и Java RMI работают только в Java, DCOM — только у Microsoft. CORBA слишком сложна и не даёт совместимости версий, SOAP и WS-* тоже страдали от сложности.
Все они построены на идее удалённого вызова процедур (RPC) из 1970-х: запрос по сети должен выглядеть как вызов локальной функции. Эту абстракцию называют location transparency. Авторы считают её ошибочной в корне:
| Локальный вызов | Сетевой запрос |
|---|---|
| Успех или ошибка зависят от параметров | Запрос или ответ может потеряться, сервер может тормозить или упасть, нужны повторы |
| Есть результат, исключение или зависание | Бывает timeout без ответа, и неизвестно, дошёл ли запрос (глава 9) |
| Повтор безопасен | Повтор может выполнить действие дважды, нужна идемпотентность (idempotence) |
| Время почти постоянное | Задержка (latency) скачет от долей миллисекунды до секунд |
| Можно передать ссылку на объект | Все параметры надо закодировать в байты, большие объекты — проблема |
| Один язык | Типы переводят между языками, например числа больше 2⁵³ в JavaScript |
Поэтому не стоит маскировать удалённый сервис под локальный объект. Отчасти REST привлекателен тем, что не выдаёт передачу состояния по сети за вызов функции.
Балансировщики нагрузки, service discovery и service mesh
Заголовок раздела «Балансировщики нагрузки, service discovery и service mesh»Клиент должен знать адрес сервиса. Это задача service discovery. Можно прописать IP и порт, но если сервер упал или переехал, клиента придётся перенастраивать вручную. Обычно копий сервиса много, и запросы распределяют между ними. Это балансировка нагрузки (load balancing):
- Аппаратный балансировщик — устройство в дата-центре. Клиент подключается к одному адресу, а устройство направляет соединение на живой сервер.
- Программный балансировщик (NGINX, HAProxy) делает то же, но это обычная программа.
- DNS даёт одному имени несколько IP-адресов. Но DNS медленно распространяет изменения и кэширует записи, поэтому при частых переездах клиент получит устаревший адрес.
- Система
service discoveryдержит реестр в etcd или ZooKeeper (глава 10). Копия сервиса при старте регистрирует хост, порт и метаданные, например какиеshardона обслуживает (глава 7), и шлётheartbeat, пока жива. Клиент берёт список адресов и подключается напрямую. В отличие от DNS, такая система справляется, когда копии сервиса часто появляются и исчезают. Service meshобъединяет оба подхода. Балансировщик стоит рядом с каждым клиентом и сервером, в процессе или какsidecar-контейнер. Клиент идёт к своему балансировщику, тот — к балансировщику сервера. Кроме того, шифрование TLS берёт на себя балансировщик, и видно, кто кого вызывает и где сбои.
С Kubernetes часто ставят service mesh (Istio, Linkerd). Базам и системам сообщений бывают нужны свои балансировщики, а простым системам хватает программного.
Кодирование и совместимость в RPC
Заголовок раздела «Кодирование и совместимость в RPC»В отличие от базы, здесь можно считать, что сначала обновляют все серверы, а потом клиентов. Тогда нужна backward compatibility для запросов и forward compatibility для ответов. Правила совместимости зависят от формата: gRPC и Avro RPC следуют правилам protobuf и Avro. В REST с JSON совместимым считают новый необязательный параметр запроса или новое поле ответа.
Сложность в том, что RPC часто связывает разные организации, и владелец не может заставить клиентов обновиться. Совместимость приходится держать годами, а при несовместимом изменении — поддерживать несколько версий API рядом. Единого способа указать версию нет: её кладут в URL, в заголовок Accept или хранят на сервере для каждого API-ключа.
Durable execution и workflow
Заголовок раздела «Durable execution и workflow»Возьмём платёж: сервис платежей вызывает проверку на мошенничество, затем списывает деньги с карты, затем зачисляет их через банковский сервис. Такая цепочка шагов называется workflow, а шаг — задачей (task). Workflow описывают графом задач на языке программирования, на DSL или в разметке вроде BPEL. В книге платёж нарисован в нотации BPMN. В Temporal задачу называют activity, в других движках — durable functions.
Workflow выполняет движок (workflow engine). Он решает, где и когда запустить задачу, что делать при сбое и сколько задач запускать параллельно. Orchestrator планирует задачи, executor их выполняет. Запуск идёт по расписанию или от внешнего триггера: веб-сервиса или человека.
| Движки | Для чего |
|---|---|
| Airflow, Dagster, Prefect | Оркестрация задач ETL в системах данных |
| Camunda, Orkes | Графическая нотация (BPMN) для не-инженеров |
| Temporal, Restate | Durable execution |
Каждый платёж нужно провести ровно один раз, а сбой посередине может списать деньги с карты, но не зачислить их на счёт. Обернуть шаги разных сервисов в одну транзакцию нельзя, а внешний платёжный шлюз мы не контролируем. Durable execution решает это так: фреймворк пишет каждый вызов RPC и каждое изменение состояния в надёжный журнал, похожий на write-ahead log. При повторе упавшей задачи он не вызывает уже успешные шаги заново, а возвращает их сохранённый результат. В книге показан фрагмент на Temporal: PaymentWorkflow по очереди вызывает проверку и списание, у каждой задачи timeout 15 секунд.
У подхода есть цена:
- Внешний сервис всё равно должен давать идемпотентный API, а разработчик — передавать уникальный ID.
- Фреймворк ждёт при повторе те же вызовы в том же порядке. Если поменять вызовы местами, поведение станет неопределённым. Безопаснее развернуть новую версию рядом: начатые запуски завершаются на старом коде, новые идут на новом.
- Код должен быть детерминированным. Случайные числа и системные часы опасны, поэтому фреймворки дают свои версии этих функций, а Temporal Workflow Check ищет недетерминизм.
К детерминизму авторы вернутся в главе 9.
Пояснение: для инженера данных это знакомая тема. Airflow тоже
workflow engine, и его задачи тоже лучше делать идемпотентными: повторный запуск за ту же дату не должен дублировать строки.
Архитектуры на событиях (event-driven)
Заголовок раздела «Архитектуры на событиях (event-driven)»В event-driven архитектуре запрос называют событием или сообщением. Отправитель не ждёт обработки, а сообщение идёт не напрямую, а через message broker, который временно его хранит. Это даёт плюсы по сравнению с RPC:
- брокер служит буфером, если получатель недоступен или перегружен;
- он заново доставит сообщение упавшему процессу;
- не нужен
service discovery; - одно сообщение получат несколько получателей;
- отправитель не знает, кто читает его сообщения.
Общение асинхронное: отправил и забыл. Но можно ждать ответ в отдельном канале и получить подобие RPC.
Message broker
Заголовок раздела «Message broker»Раньше рынок занимали TIBCO, IBM WebSphere и webMethods, потом открытые RabbitMQ, ActiveMQ, NATS, Redpanda и Apache Kafka, теперь ещё облачные Kinesis, Azure Service Bus и Pub/Sub. Подробнее о них в главе 12. Чаще всего используют два шаблона:
- Очередь (
queue): сообщение получает один изconsumer. Topic: сообщение получают все подписчики.
Сообщение — это байты с метаданными, формат любой. Обычно берут Protocol Buffers, Avro или JSON и ставят рядом schema registry, который проверяет совместимость версий. Схему сообщений можно описать и в AsyncAPI, аналоге OpenAPI. Многие брокеры пишут сообщения на диск, но удаляют их после прочтения. Для event sourcing (глава 3) брокер настраивают хранить сообщения бессрочно. Если consumer пересылает сообщения в другой topic, он должен сохранять неизвестные поля, иначе повторится проблема потерянного поля.
Распределённые фреймворки акторов
Заголовок раздела «Распределённые фреймворки акторов»Модель акторов (actor model) — это способ писать конкурентный код без прямой работы с потоками, гонками и deadlock. Актор представляет одну сущность, хранит своё состояние и общается с другими только асинхронными сообщениями, которые могут теряться. Актор обрабатывает одно сообщение за раз, поэтому в его коде не нужно думать о потоках.
Akka, Orleans и Erlang/OTP переносят эту модель на много узлов: сообщение для другого узла кодируется, уходит по сети и декодируется. Location transparency здесь работает лучше, чем в RPC, потому что модель акторов и так допускает потерю сообщений. Но при rolling upgrade сообщения ходят между узлами разных версий, поэтому нужна совместимость в обе стороны и один из форматов этой главы.
Итоги главы
Заголовок раздела «Итоги главы»- Детали кодирования влияют не только на скорость, но и на архитектуру и на то, как систему можно менять.
Rolling upgradeдаёт релизы без простоя, частые и малые, а плохой релиз откатывают раньше, чем он заденет многих.- Узлы работают на разных версиях кода, поэтому данные должны давать
backward compatibilityиforward compatibility. - Форматы конкретного языка привязаны к одному языку и часто не дают совместимости.
- JSON, XML и CSV распространены, но расплывчаты в типах, особенно с числами и бинарными строками.
- Protocol Buffers и Avro компактны, у них ясные правила совместимости, а схема служит документацией; минус в том, что без декодирования данные не прочитать.
- Через базу данные кодирует писатель и декодирует читатель, и данные живут дольше кода.
- В
RPCи REST клиент кодирует запрос и декодирует ответ, а сервер делает обратное. Durable executionдаётworkflowвыполнение «ровно один раз», но требует детерминированного кода.- В архитектуре на событиях узлы обмениваются сообщениями через
message brokerили акторы.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
Кодирование (encoding) | Перевод структур из памяти в байты |
backward compatibility | Новый код читает старые данные |
forward compatibility | Старый код читает новые данные |
rolling upgrade | Постепенное обновление узлов без простоя |
schema evolution | Изменение схемы, при котором старые и новые данные живут вместе |
Тег поля (field tag) | Номер поля в Protocol Buffers вместо имени |
| Схема писателя / схема читателя | В Avro: схема записи и схема, которую ждёт код |
Реестр схем (schema registry) | Хранилище версий схем с проверкой совместимости |
RPC | Удалённый вызов, замаскированный под локальный |
service discovery | Поиск адреса нужного сервиса |
durable execution | Повтор workflow с пропуском сделанных шагов по журналу |
Идемпотентность (idempotence) | Повтор операции не меняет результат |
message broker | Посредник, который временно хранит сообщения |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Для событий в
topicKafka используйте Avro или Protobuf вместе соschema registry. Включайте проверку совместимости до деплоя. - Новые поля делайте необязательными или с
default. Не меняйте и не используйте повторно теги. Не удаляйте поля безdefault. - Выгружайте данные из баз в Avro или Parquet, а схему генерируйте из таблицы.
- Следите, чтобы
ETLиconsumerне теряли неизвестные поля, когда перезаписывают данные. - Для внешних API подходит JSON, для внутренних систем лучше форматы со схемой. ID больше 2⁵³ передавайте в JSON строкой.
- Делайте повторные запросы идемпотентными: в сети повторы и потерянные ответы обычны.
- Код
workflowв Airflow, Dagster или Temporal держите детерминированным, а несовместимые изменения выпускайте новой версией рядом со старой.
Код из главы
Заголовок раздела «Код из главы»Авторы кодируют одну запись в разных форматах и считают байты. Мы повторили это без библиотек: скрипт scripts/ddia-code/ch05_encodings.py вручную собирает JSON, MessagePack, Protocol Buffers и Avro. Основа кодирования в protobuf и Avro — функция varint:
def varint(n):    out = bytearray()    while True:        b, n = n & 0x7F, n >> 7        out.append(b | 0x80 if n else b)        if not n:            return bytes(out)
print(varint(1337).hex(" "))   # 1337 = 0b10100111001print(varint(63).hex(" "), "|", varint(300).hex(" "))
b9 0a3f | ac 02Вывод всего скрипта (python3 -I ch05_encodings.py). Размеры совпадают с книгой: 81, 66, 33 и 32 байта. Последняя строка показывает, как ID больше 2⁵³ портится при чтении в double:
формат            байтов  первые байтыJSON                  81  7b 22 75 73 65 72 4e 61 6d 65 ...MessagePack           66  83 a8 75 73 65 72 4e 61 6d 65 ...Protocol Buffers      33  0a 06 4d 61 72 74 69 6e 10 b9 ...Avro                  32  0c 4d 61 72 74 69 6e 02 f2 14 ...
1337 как varint: b9 0aAvro long    63 -> байтов: 1Avro long    64 -> байтов: 2Avro long  8191 -> байтов: 2Avro long  8192 -> байтов: 3
ID в JSON: 9007199254740993 | прочитан как double: 9007199254740992
Правила Avro для схемы писателя и схемы читателя помещаются в одну функцию. Полная версия с примером потерянного поля лежит в scripts/ddia-code/ch05_compatibility.py:
NO_DEFAULT = object()V1 = [("userName", NO_DEFAULT), ("favoriteNumber", None)]V2 = V1 + [("photoUrl", None)]  # новое поле с default
def resolve(record, reader_schema):    out = {}    for name, default in reader_schema:        if name in record:            out[name] = record[name]      # поле есть у писателя        elif default is not NO_DEFAULT:            out[name] = default           # нет у писателя: default читателя        else:            raise ValueError(f"нет поля {name}")    return out                            # лишние поля писателя пропали
print(resolve({"userName": "Martin", "favoriteNumber": 1337}, V2))print(resolve({"userName": "Martin", "favoriteNumber": 1337, "photoUrl": "/u/1.jpg"}, V1))
{'userName': 'Martin', 'favoriteNumber': 1337, 'photoUrl': None}{'userName': 'Martin', 'favoriteNumber': 1337}Первая строка — backward compatibility: новая схема читает старую запись и подставляет default. Вторая — forward compatibility: старая схема читает новую запись и пропускает photoUrl.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Чем
backward compatibilityотличается отforward compatibility? Почему вторую получить труднее? - Почему в Protocol Buffers можно переименовать поле, но нельзя менять его тег или использовать старый тег повторно?
- Как читатель Avro узнаёт схему писателя в файле, в базе и в сетевом соединении?
- Почему Avro удобнее protobuf, когда схему выгрузки создаёт программа из схемы базы?
- Почему авторы считают идею
RPC«как локальный вызов» ошибочной? Назовите три отличия сетевого запроса. - Когда
durable executionломается от безобидной на вид правки кода и как этого избежать?
Предыдущая: Хранение и извлечение данных. Следующая: Репликация.