

Designing Data-Intensive Applications, глава 9: Проблемы распределённых систем
Главная мысль: в распределённой системе что-то всегда ломается частично. Сеть теряет и задерживает сообщения, часы врут, процесс может замереть в любой момент. Узел не знает наверняка, что происходит у других, поэтому важные решения принимает большинство узлов, а не один узел.
О чём глава
Заголовок раздела «О чём глава»Глава отвечает на вопрос: на что можно полагаться, когда программа работает на многих машинах, и на что нельзя? В главе 8 транзакции скрывали от нас сбои. Здесь авторы нарочно становятся пессимистами и перебирают всё, что может пойти не так. Решения этих проблем будут в главе 10.
Темы главы:
- частичные отказы и почему они отличают распределённую систему от одной машины;
- ненадёжная сеть: потерянные пакеты,
timeout, очереди, коммутация каналов и пакетов; - ненадёжные часы:
time-of-day clockиmonotonic clock, дрейф,LWW, интервал уверенности; - паузы процессов и lease;
- знание и истина: кворум,
fencing token,Byzantine fault; - модели системы,
safetyиliveness; - как проверять алгоритмы:
model checking,fault injection,deterministic simulation testing.
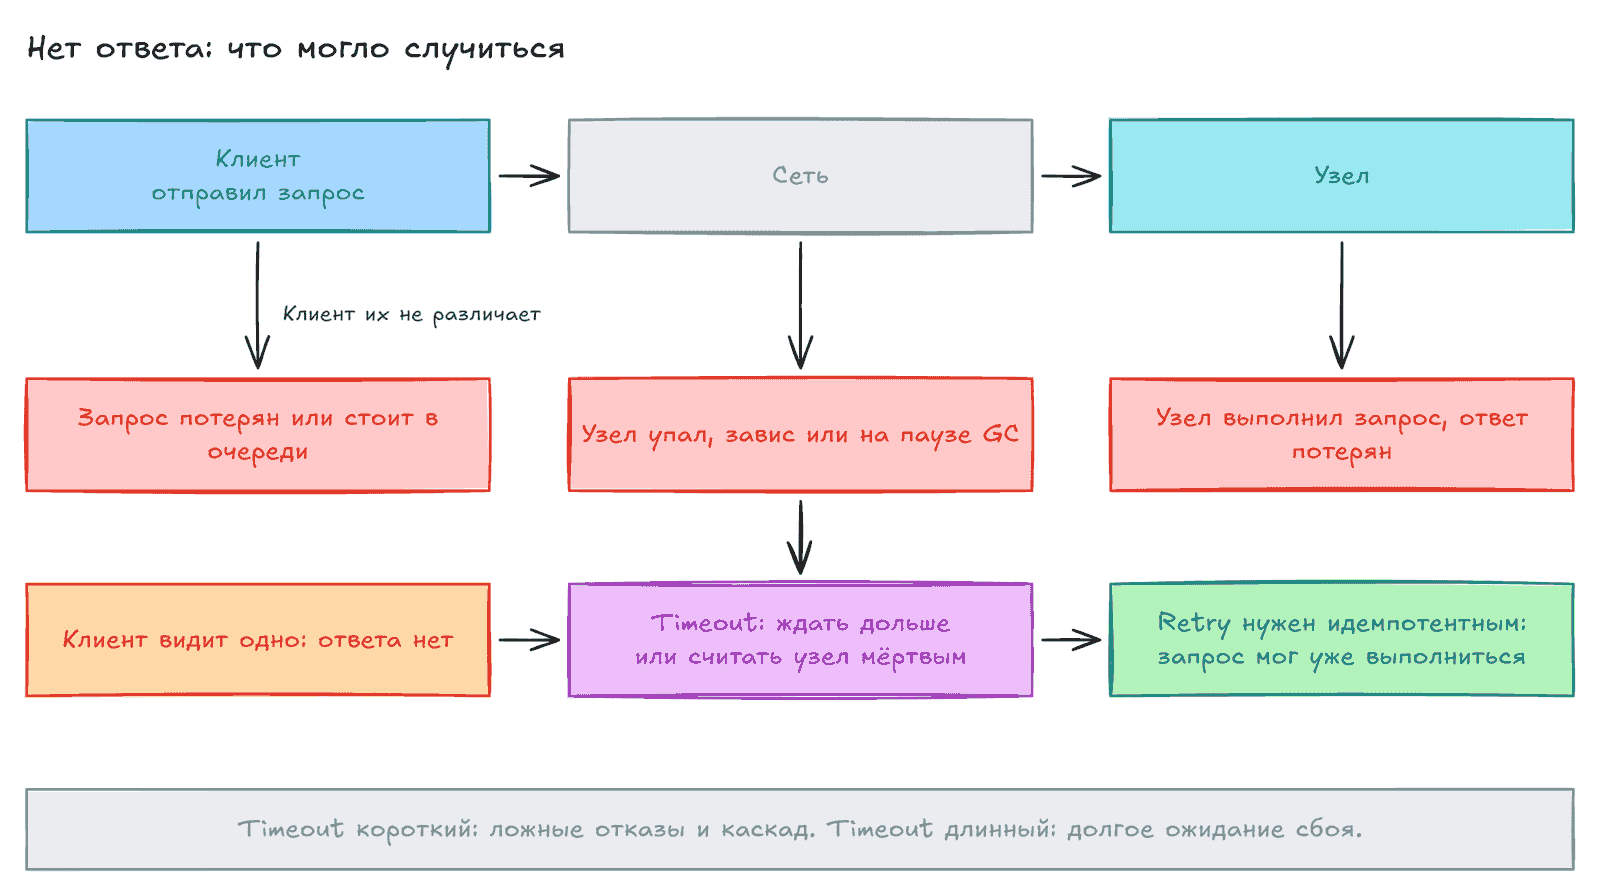
Схема показывает главную трудность главы. Клиент видит только одно: ответа нет. Причин может быть много, и снаружи их не различить.
Ошибки и частичные отказы
Заголовок раздела «Ошибки и частичные отказы»Программа на одном компьютере обычно предсказуема: она либо работает, либо нет. Исправное железо выполняет одну и ту же операцию с одним результатом, то есть детерминированно. При поломке железа компьютер чаще падает целиком: kernel panic, «синий экран», отказ загрузки. Так задумано нарочно: неверный результат хуже полного отказа, потому что с ним труднее разобраться. Компьютер прячет «грязную» физику за идеальной моделью. На самом деле данные иногда тихо портятся, но так редко, что этим пренебрегают.
С несколькими машинами в сети сбои случаются намного чаще, и игнорировать их нельзя. Авторы приводят рассказ инженера Coda Hale: разрывы сети внутри дата-центра, отказы питания и коммутаторов, случайное выключение целых стоек. Однажды водитель грузовика въехал в систему кондиционирования дата-центра.
Частичный отказ (partial failure) — это ситуация, когда одна часть системы сломана непредсказуемым образом, а другие работают. Такие отказы недетерминированы: операция с несколькими узлами иногда проходит, иногда нет, и вы можете даже не узнать, выполнилась ли она.
Но есть и плюс. Если система переживает частичные отказы, её можно обновлять по одному узлу (rolling upgrade) без остановки сервиса. Так из ненадёжных частей получается система надёжнее одной машины. Для этого нужно знать, какие сбои бывают, и создавать их нарочно в тестах. В распределённых системах пессимизм окупается.
Ненадёжные сети
Заголовок раздела «Ненадёжные сети»Системы из этой книги устроены как shared-nothing: набор машин, связанных сетью. У каждой машины своя память и свой диск, а чужие данные доступны только через запрос по сети. Надёжность здесь дают реплики на других машинах, а не запасные детали внутри одной машины, как у мейнфреймов.
Интернет и сети дата-центров (обычно Ethernet) — это асинхронные пакетные сети. Сеть не обещает, когда пакет дойдёт и дойдёт ли вообще. Если вы ждёте ответа, возможны такие случаи:
- запрос потерялся, например кто-то выдернул кабель;
- запрос стоит в очереди и придёт позже;
- удалённый узел упал или выключен;
- узел временно не отвечает, например из-за паузы сборщика мусора (GC);
- узел выполнил запрос, но ответ потерялся или задержался в сети.
Отправитель узнаёт о доставке только из ответа, а ответ тоже может потеряться. Снаружи все эти случаи выглядят одинаково: ответа пока нет. Обычно ставят timeout: после некоторого времени отправитель перестаёт ждать. Но и тогда он не знает, получил ли узел запрос: запрос может всё ещё лежать в очереди и дойти позже.
Ограничения TCP
Заголовок раздела «Ограничения TCP»Большие сообщения не помещаются в один пакет (обычно несколько килобайт), поэтому их разбивает и собирает протокол TCP. Почти всё сказанное о нём верно и для QUIC, SCTP и других транспортных протоколов.
TCP называют «надёжным»: он повторно отправляет потерянные пакеты, восстанавливает их порядок, ловит порчу контрольной суммой и подбирает скорость, чтобы не перегрузить сеть и получателя (backpressure). Данные сначала попадают в буфер ОС отправителя, затем через коммутаторы в буфер ОС получателя. Получатель отправляет подтверждение и только потом сообщает приложению о данных.
Но о сети думать всё равно нужно. Если подтверждение не пришло, TCP не знает, что пропало: пакет или подтверждение. Повтор не гарантирует доставку: выдернутый кабель TCP обратно не вставит. В итоге он сообщает приложению об ошибке. Повторы работают только внутри одного соединения, поэтому при переподключении данные могут продублироваться.
Если соединение оборвалось, неизвестно, сколько данных узел успел обработать. Подтверждение значит лишь, что пакет получило ядро ОС, а приложение могло упасть раньше. Чтобы знать, что запрос выполнен, нужен ответ от самого приложения. И всё же TCP удобен: он передаёт большие сообщения и много запросов по одному соединению. Так работают HTTP и многие протоколы RPC.
Сбои сети на практике
Заголовок раздела «Сбои сети на практике»Сети строят десятки лет, но надёжными так и не сделали. Сбои часты даже в дата-центре одной компании:
- в одном дата-центре среднего размера нашли около 12 сбоев сети в месяц: половина отключала одну машину, половина — целую стойку;
- запасное сетевое оборудование помогает меньше, чем ожидают, потому что не защищает от ошибок людей в настройке, а это одна из главных причин аварий;
- оптические линии рвали коровы, бобры и акулы, а ещё люди: по ошибке, ради металла или ради диверсии;
- между облачными регионами время туда и обратно (round-trip time) на высоких перцентилях доходило до нескольких минут. Внутри дата-центра пакет задерживался больше чем на минуту из-за перестройки сети;
- связь бывает разорвана частично: A говорит с B, B с C, но A не говорит с C. Сетевая карта может отправлять пакеты и терять все входящие;
- даже короткий разрыв может иметь последствия, которые длятся намного дольше.
Вывод авторов: сообщение может задержаться сколь угодно долго. Любое общение по сети может сорваться, и программа должна это обрабатывать.
Разрыв сети (network partition, или netsplit) — это случай, когда часть сети отрезана от остальной. По сути он не отличается от других сбоев сети. С sharding этот термин не связан (см. главу 7).
Если обработка сбоев сети не продумана, кластер может навсегда зависнуть даже после восстановления сети или удалить все данные. Обрабатывать сбой не всегда значит переживать его: если сеть обычно надёжна, на время сбоя можно просто показывать пользователям ошибку. Но нужно знать, как система реагирует на сбой, и уметь её восстановить. Для этого сбои вызывают нарочно (см. fault injection ниже).
Обнаружение сбоев
Заголовок раздела «Обнаружение сбоев»Балансировщику нагрузки нужно перестать слать запросы мёртвому узлу. В базе с одним leader при его падении один из follower должен стать новым leader (failover, см. главу 6). Для этого надо понять, жив ли узел.
Иногда есть явный сигнал. Если процесс упал, а машина доступна, ОС отклонит TCP-соединение пакетом RST или FIN. Скрипт на узле может сообщить другим о падении процесса, как делает HBase. Можно спросить коммутаторы дата-центра, если есть доступ к их управлению. Маршрутизатор может ответить пакетом ICMP Destination Unreachable.
Но рассчитывать на такие сигналы нельзя: в общем случае ответа не будет совсем. Можно повторить запрос, дождаться timeout и объявить узел мёртвым. Узел при этом может быть жив, поэтому приходится выбирать между двумя ошибками. Короткий timeout ложно хоронит живые узлы, а длинный заставляет долго ждать мёртвые.
Timeout и неограниченные задержки
Заголовок раздела «Timeout и неограниченные задержки»Каким должен быть timeout? Простого ответа нет. Длинный timeout означает, что пользователи долго ждут или видят ошибки. Короткий быстрее находит сбой, но чаще ошибается, когда узел просто замедлился из-за всплеска нагрузки.
Ложное объявление смерти опасно. Если живой узел как раз отправлял письмо, а его работу подхватил другой, письмо уйдёт дважды. Кроме того, работу «мёртвого» узла передают другим, и нагрузка на них растёт. Если узел был просто перегружен, это может вызвать каскадный отказ, и в крайнем случае все узлы объявят друг друга мёртвыми.
Представим сеть, где пакет либо доходит за время d, либо теряется, а исправный узел отвечает за время r. Тогда ответ всегда придёт за 2d + r, и это был бы разумный timeout. Но у реальных систем нет ни одной из этих гарантий. В асинхронных сетях задержки не ограничены, и серверы тоже не обещают ответить за фиксированное время. Быть быстрым «обычно» мало: при низком timeout хватит одного короткого всплеска задержки, чтобы система начала ошибаться и объявлять живые узлы мёртвыми.
Перегрузка сети и очереди
Заголовок раздела «Перегрузка сети и очереди»Как время в пути на машине зависит от пробок, так и разброс задержек пакетов чаще всего вызывают очереди:
- если несколько узлов шлют пакеты одному получателю, коммутатор ставит их в очередь. Это перегрузка сети (network congestion). Если очередь переполнится, пакет отбрасывается и его шлют снова, хотя сеть исправна;
- если на машине-получателе заняты все ядра, ОС держит запрос в очереди, пока приложение не освободится;
- в облаке VM замирает на десятки миллисекунд, пока ядро процессора занято другой VM, и входящие данные копятся в буфере;
- TCP ограничивает скорость отправки, поэтому данные ждут ещё у отправителя.
Когда TCP сам повторяет потерянный пакет, приложение не видит потери. Оно видит только задержку.
Приложения, чувствительные к задержке, например видеосвязь и VoIP, используют UDP. Это компромисс: UDP не управляет потоком и не повторяет пакеты, поэтому часть причин разброса исчезает. UDP хорош там, где опоздавшие данные бесполезны. В звонке потерянный пакет не успеют переслать вовремя, поэтому приложение вставляет тишину, а повтор происходит на уровне людей: «Повтори, звук пропал».
Разброс задержек сети
Заголовок раздела «Разброс задержек сети»Очереди особенно растут, когда система близка к пределу мощности. В публичных облаках линии, коммутаторы, сетевые карты и процессоры делят многие клиенты. Чужую нагрузку вы не видите, поэтому задержки скачут, если рядом работает noisy neighbor — сосед, который потребляет много ресурсов.
Поэтому timeout подбирают опытным путём: долго меряют время туда и обратно на многих машинах и выбирают компромисс между скоростью обнаружения и ложными срабатываниями. Ещё лучше, если система сама меряет время ответа и его разброс (jitter) и подстраивает timeout. Так работает Phi Accrual failure detector в Akka и Cassandra.
Синхронные и асинхронные сети
Заголовок раздела «Синхронные и асинхронные сети»Почему не сделать сеть с фиксированной задержкой и без потерь? Авторы сравнивают сеть дата-центра с проводной телефонной сетью, которая очень надёжна. Звонок создаёт канал (circuit): на всём пути резервируется фиксированная полоса до конца звонка. Например, в сети ISDN каждая сторона гарантированно отправляет ровно 16 бит звука каждые 250 микросекунд. Такая сеть синхронна: место уже зарезервировано на каждом шаге, очередей нет, и максимальная задержка фиксирована (bounded delay).
Почему нельзя сделать задержки предсказуемыми
Заголовок раздела «Почему нельзя сделать задержки предсказуемыми»Канал держит полосу, которую никто другой не займёт. TCP же берёт свободную сейчас полосу и старается передать данные как можно быстрее. Ethernet и IP используют коммутацию пакетов, где есть очереди и, значит, неограниченные задержки.
Причина в том, что эти сети рассчитаны на неравномерный (bursty) трафик. Звонку нужен постоянный поток бит, а веб-странице, письму или файлу — просто быстрая передача. Для файла по каналу пришлось бы угадывать полосу. Если полосы мало, передача идёт медленно, а сеть простаивает. Если много, канал не создать: сеть не выделит полосу, которую не может гарантировать. TCP же сам подстраивается под свободную мощность сети.
Задержка и использование ресурсов
Заголовок раздела «Задержка и использование ресурсов»Разброс задержек — следствие динамического деления ресурсов. Если провод держит 10 000 звонков, ваш канал получает ровно одно место, даже когда остальные 9999 мест пусты. Интернет делит полосу динамически: коммутаторы каждый миг решают, чей пакет отправить. Минус — очереди, плюс — провод загружен полностью, и каждый байт дешевле. С процессорами так же: поток иногда ждёт в очереди планировщика, зато железо загружено лучше. Поэтому облака и запускают VM разных клиентов на одной машине.
Гарантии задержки возможны при статическом делении ресурсов, но это дороже. Авторы подводят итог: переменные задержки — не закон природы, а результат компромисса между ценой и пользой.
Смешанные сети
Заголовок раздела «Смешанные сети»Были попытки совместить коммутацию каналов и пакетов: ATM в 1980-х и отчасти InfiniBand. Механизмы качества обслуживания (QoS) — приоритеты пакетов, планирование, ограничение скорости отправителей — позволяют имитировать каналы или получить статистически ограниченную задержку. Есть и новые алгоритмы вроде L4S, а Linux traffic controller (TC) умеет менять приоритеты пакетов. Ближе всего к каналам в интернете пиринг провайдеров и маршруты BGP, где можно купить выделенную полосу, но на уровне целых сетей.
Однако в общих дата-центрах, облаках и интернете QoS не включён. Значит, перегрузка и неограниченные задержки будут, а «правильного» timeout нет: его подбирают по измерениям.
Ненадёжные часы
Заголовок раздела «Ненадёжные часы»Приложениям нужно время в двух смыслах. Одни вопросы меряют длительность: истёк ли timeout, каков 99-й перцентиль времени ответа, сколько запросов в секунду обработано. Другие описывают момент времени: когда опубликована статья, когда отправить напоминание, когда истекает запись в кэше, какое время стоит на ошибке в логе.
В распределённой системе со временем трудно. Сообщение идёт по сети с неизвестной задержкой, поэтому трудно понять порядок событий на разных машинах. Кроме того, у каждой машины свои кварцевые часы, и они немного спешат или отстают. Часы синхронизируют, чаще всего по NTP (Network Time Protocol): компьютер подводит время по группе серверов, а те берут его из точного источника, например GPS.
Monotonic clock и time-of-day clock
Заголовок раздела «Monotonic clock и time-of-day clock»У современных компьютеров есть минимум два вида часов, и путать их нельзя, потому что они нужны для разного.
Time-of-day clock
Заголовок раздела «Time-of-day clock»Time-of-day clock — это часы, которые возвращают дату и время по календарю (wall-clock time). Например, clock_gettime(CLOCK_REALTIME) в Linux и System.currentTimeMillis() в Java возвращают время от эпохи: полуночи UTC 1 января 1970 года, без високосных секунд.
Их синхронизируют по NTP, поэтому timestamp на разных машинах в идеале значат одно и то же. Но если часы сильно ушли вперёд, NTP может резко их сбросить, и время прыгнет назад. Из-за таких скачков и високосных секунд эти часы не годятся для измерения длительности. Скачков при переходе на летнее время можно избежать, если хранить время в UTC.
Monotonic clock
Заголовок раздела «Monotonic clock»Monotonic clock — это часы для измерения длительности, например timeout или времени ответа. В Linux это clock_gettime(CLOCK_MONOTONIC), в Java — System.nanoTime(). Они всегда идут только вперёд и работают как секундомер: показание снимают до действия и после, а разница даёт прошедшее время. Само значение смысла не несёт, поэтому сравнивать показания с двух машин бессмысленно.
NTP может ускорить или замедлить ход этих часов до 0,05% (slewing), но не может заставить их прыгнуть. Разрешение у них обычно микросекунды и лучше. Для timeout в распределённой системе monotonic clock подходит: синхронизация между узлами ему не нужна.
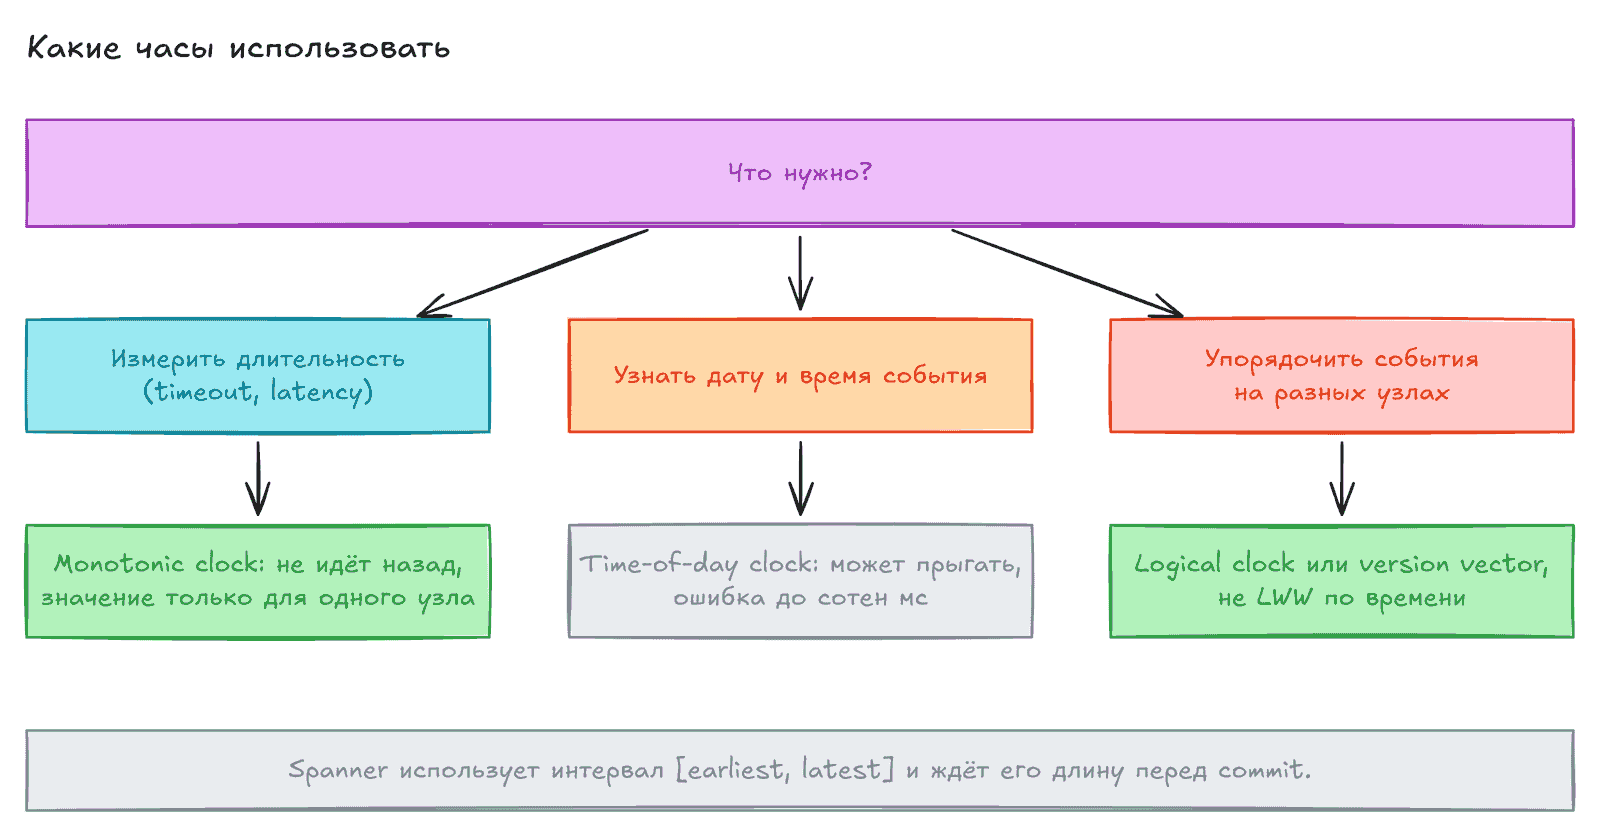
Схема подводит итог: для длительности берите monotonic clock, для даты события — time-of-day clock с учётом его ошибки, а для порядка событий на разных узлах — logical clock (см. ниже).
Синхронизация и точность часов
Заголовок раздела «Синхронизация и точность часов»Time-of-day clock без синхронизации бесполезны, но выставить точное время намного труднее, чем кажется:
- кварц дрейфует, то есть спешит или отстаёт, в зависимости от температуры. Google закладывает дрейф до 200 ppm: 6 мс при синхронизации каждые 30 секунд или 17 секунд при синхронизации раз в сутки;
- если часы слишком далеки от сервера NTP, клиент может отказаться синхронизироваться или резко сбросить время;
- узел, случайно отрезанный firewall от NTP, могут долго не замечать, пока дрейф копится;
- NTP не точнее сетевой задержки. Через интернет получали ошибку от 35 мс, а при всплесках задержки — около секунды;
- некоторые серверы NTP ошибаются на часы. Клиенты отбрасывают выбросы, но ставить корректность своей системы в зависимость от времени, которое сообщил незнакомец из интернета, тревожно;
- високосная секунда даёт минуту из 59 или 61 секунды и уже роняла большие системы. Её «размазывают» на день (smearing), а с 2035 года високосные секунды отменят;
- в VM часы прыгают вперёд после каждой паузы, а клиент NTP внутри VM об этих паузах не знает;
- часам на телефонах и чужих устройствах доверять нельзя: пользователи ставят неверное время, например чтобы обмануть игру.
Высокая точность достижима за большие деньги. Европейская регуляция MiFID II требует от фондов высокочастотного трейдинга держать часы в пределах 100 микросекунд от UTC. Для этого нужны GPS-приёмники или атомные часы, протокол PTP (Precision Time Protocol) и мониторинг. Полагаться только на GPS рискованно: сигнал легко заглушить. Некоторые облака уже предлагают точную синхронизацию для VM.
Опора на синхронизированные часы
Заголовок раздела «Опора на синхронизированные часы»В сутках не всегда 86 400 секунд, часы могут пойти назад, а время на двух узлах может сильно различаться. Как и с сетью, программа должна быть готова к неверным часам.
Беда в том, что плохие часы легко не заметить. Сломанный процессор виден сразу, а с ушедшими часами почти всё работает. Если программа полагается на точное время, итогом скорее будет тихая потеря данных, чем громкое падение. Поэтому следите за расхождением часов на всех машинах кластера и выводите из кластера узел, чьи часы ушли слишком далеко.
Timestamp для порядка событий
Заголовок раздела «Timestamp для порядка событий»Соблазнительно, но опасно упорядочивать по часам события на разных узлах. Авторы разбирают базу с несколькими leader. Клиент A пишет x = 1 на узел 1, запись реплицируется на узел 3. Клиент B увеличивает x на узле 3, и теперь x = 2. Обе записи приходят на узел 2 с timestamp по часам узла, где они возникли. Часы узлов 1 и 3 расходятся меньше чем на 3 мс, а это лучше, чем обычно бывает на практике.
Запись x = 2 основана на x = 1, но её timestamp меньше: 42,003 секунды против 42,004. Запись B причинно позже записи A, а timestamp у неё раньше.
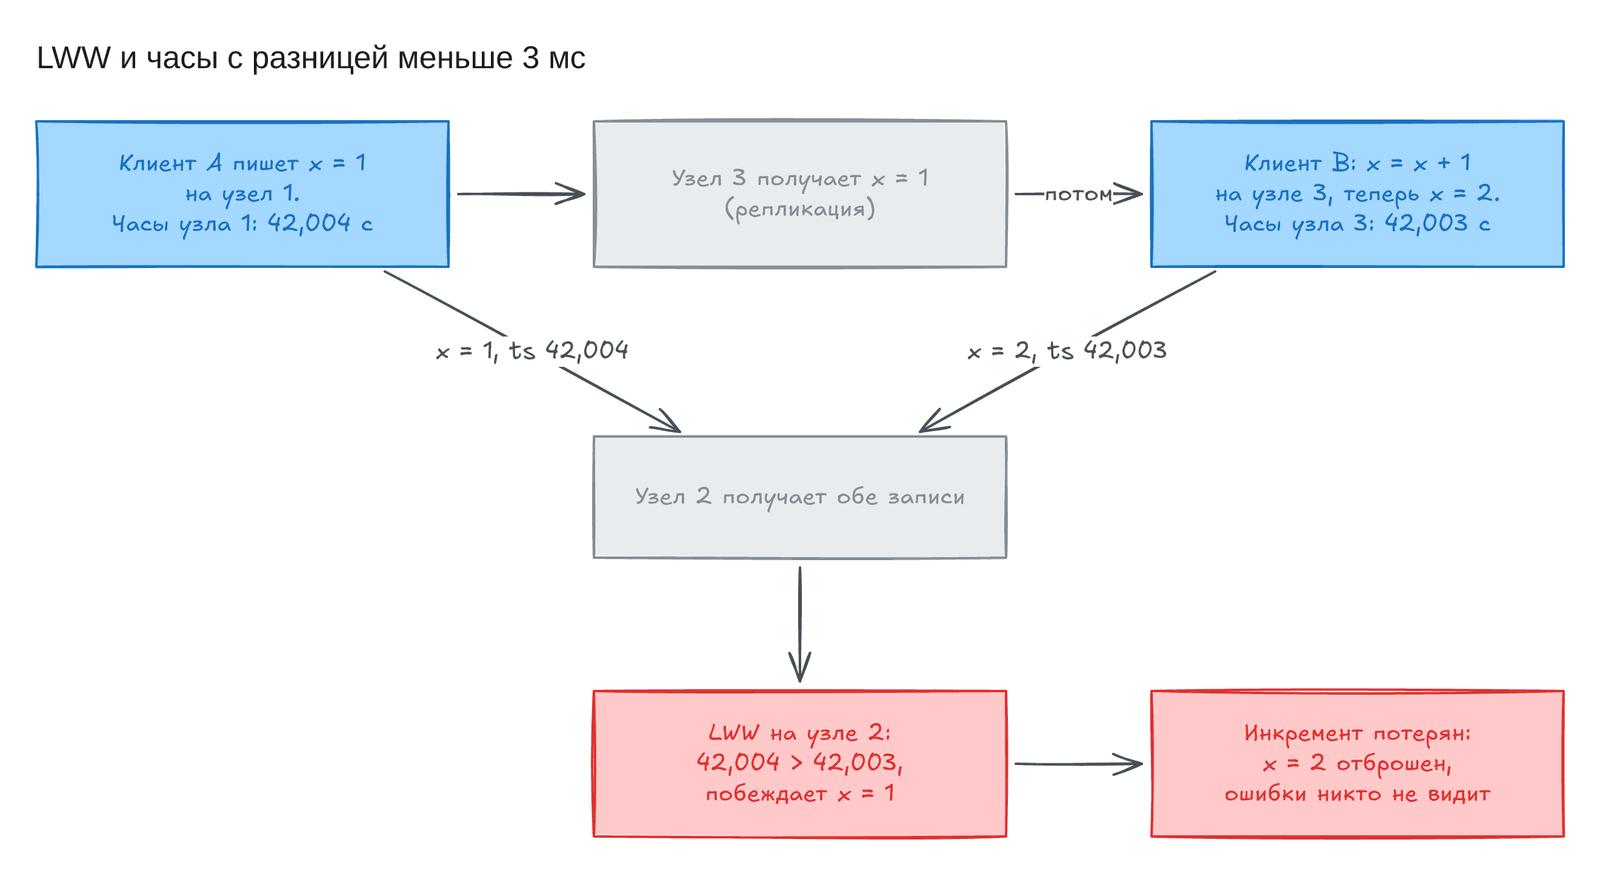
Last write wins (LWW) — это способ разрешать конфликты: оставляют запись с наибольшим timestamp, остальные отбрасывают (см. главу 6). На схеме узел 2 решит, что x = 1 новее, и выбросит x = 2: инкремент потерян.
Можно давать новому значению timestamp больше старого, даже если он опережает локальные часы, но это требует лишнего чтения. Cassandra и ScyllaDB экономят это чтение и берут timestamp по часам клиента с LWW. У такого подхода серьёзные проблемы:
- записи загадочно пропадают. Узел с отстающими часами не может перезаписать значение от узла со спешащими, пока не пройдёт разница часов. Данные молча теряются без единой ошибки;
LWWне отличает записи, которые быстро шли одна за другой, от по-настоящему одновременных. Для причинности нужны отдельные механизмы, напримерversion vector;- два узла могут создать записи с одинаковым timestamp. Тогда нужен дополнительный признак, например случайное число, но и он может нарушить причинность.
Даже с хорошим NTP пакет, отправленный в 100 мс по часам отправителя, может прийти в 99 мс по часам получателя, то есть «раньше, чем ушёл». Точнее NTP не сделать: его точность ограничена временем туда и обратно по сети, а для верного порядка ошибка часов должна быть намного меньше сетевой задержки.
Безопаснее упорядочивать события через logical clock — часы на растущих счётчиках, которые показывают только, какое событие было раньше. Часы, которые меряют реальное время, называют физическими. Подробнее о logical clock — в главе 10.
Показания часов с интервалом уверенности
Заголовок раздела «Показания часов с интервалом уверенности»Часы можно прочитать с точностью до наносекунд, но это не значит, что значение так точно. Дрейф кварца легко даёт несколько миллисекунд, а с сервером NTP в интернете ошибка — десятки миллисекунд и при перегрузке больше 100 мс.
Поэтому показание часов лучше считать диапазоном с интервалом уверенности: например, система на 95% уверена, что сейчас от 10,3 до 10,5 секунды после начала минуты. Ширина интервала складывается из дрейфа с последней синхронизации, ошибки сервера и времени туда и обратно до него. Обычный clock_gettime эту ошибку не сообщает. Исключения — TrueTime API в Google Spanner и Amazon ClockBound: они возвращают [earliest, latest], и реальное время точно лежит внутри.
Синхронизированные часы для глобальных снимков
Заголовок раздела «Синхронизированные часы для глобальных снимков»В главе 8 мы видели MVCC: длинные транзакции на чтение видят снимок (snapshot) базы и не мешают коротким транзакциям на запись. Для этого нужен растущий ID транзакции: запись с ID больше, чем у снимка, снимок не видит.
На одном узле хватает счётчика. В базе на многих машинах общий ID для всех shard требует координации. ID должен отражать причинность: если B читает данные A, у B ID больше. При множестве быстрых транзакций такой генератор становится узким местом.
Можно ли брать timestamp синхронизированных часов как ID? Spanner так и делает между дата-центрами. Если интервалы A = [A_earliest, A_latest] и B = [B_earliest, B_latest] не пересекаются, то B точно было после A. Поэтому перед commit транзакции на запись Spanner нарочно ждёт ширину интервала. Тогда любая транзакция, которая прочитает эти данные, произойдёт достаточно поздно, и интервалы не пересекутся. Чтобы ждать меньше, Google ставит в каждый дата-центр GPS-приёмник или атомные часы, и ошибка часов составляет около 7 мс.
Атомные часы для этого не обязательны: главное — сам интервал, а точный источник только сужает его. YugabyteDB на AWS может использовать ClockBound, и другие системы тоже начинают опираться на синхронизацию часов.
Паузы процессов
Заголовок раздела «Паузы процессов»Пусть в базе у каждого shard один leader. Как узлу понять, что он всё ещё leader и его не объявили мёртвым? Один вариант — lease: блокировка с timeout, которую одновременно держит только один узел. Пока lease действует, узел — leader. Он должен заранее продлевать lease, а если упадёт, после истечения lease его место займёт другой.
В книге приведён цикл: узел берёт запрос, продлевает lease, если до конца меньше 10 секунд, и обрабатывает запрос, если lease действительна. В нём две ошибки. Первая: срок lease задала другая машина, а сравнивают его с локальными часами. Если часы расходятся на несколько секунд, код ведёт себя странно.
Вторая ошибка серьёзнее. Код считает, что между проверкой времени и обработкой запроса проходит мало времени. Но если поток замрёт на 15 секунд прямо перед проверкой lease, то к обработке lease уже истечёт, и leader станет другой узел. Поток о паузе не знает и заметит это только на следующем шаге цикла, уже сделав что-то опасное.
Может ли поток замереть так надолго? Да, причин много:
- потоки долго ждут общий ресурс, например блокировку или очередь;
- сборщик мусора (например, в JVM) останавливает все потоки. Раньше такие паузы длились минутами, сейчас реже, но всё ещё заметны;
- VM можно приостановить и продолжить, например при живой миграции на другой хост. Пауза может длиться сколько угодно;
- ноутбук или телефон засыпает, когда пользователь закрывает крышку;
- ОС или гипервизор переключаются на другой поток или VM (время у других VM называют steal time);
- поток ждёт медленный диск. Диск бывает задействован неожиданно: например, Java подгружает классы при первом использовании. А сетевой диск вроде Amazon EBS добавляет разброс сети;
- при swap обращение к памяти вызывает чтение с диска, а при нехватке памяти ОС почти только гоняет страницы (thrashing). Поэтому на серверах swap часто отключают;
- процесс останавливают сигналом SIGSTOP, например Ctrl-Z в shell, иногда случайно.
Поток прерывается в любой точке и продолжает позже, ничего не заметив. На одной машине против этого есть мьютексы, семафоры и атомарные счётчики. В распределённую систему их не перенести: общей памяти нет, есть только сообщения по ненадёжной сети. Узел должен считать, что может замереть в любой момент, даже посреди функции. Пока он стоит, другие могут объявить его мёртвым, а он узнает об этом не сразу.
Эту ошибку и её исправление мы разберём на Python в конце страницы.
Гарантии времени ответа
Заголовок раздела «Гарантии времени ответа»Причины пауз можно устранить, если очень постараться. Компьютеры, которые управляют самолётами, ракетами и машинами, работают в системах жёсткого реального времени (hard real-time): программа обязана ответить к сроку, иначе откажет вся система. Подушка безопасности не должна ждать паузы GC. В вебе словом real-time называют другое: потоковую обработку без жёстких сроков (см. главу 12).
Для таких гарантий нужны ОС реального времени (RTOS), библиотеки с известным худшим временем выполнения, ограничения на выделение памяти и огромное число тестов. Это дорого и сильно сужает выбор языков и инструментов. К тому же «реальное время» не значит «быстро»: throughput у таких систем может быть ниже. Для серверных систем данных это невыгодно, поэтому они живут с паузами и нестабильными часами.
Как уменьшить влияние сборки мусора
Заголовок раздела «Как уменьшить влияние сборки мусора»Алгоритмы GC сильно улучшились: хорошо настроенный сборщик обычно останавливает процесс не дольше нескольких миллисекунд. В Java есть CMS, G1, ZGC, Epsilon и Shenandoah для разных профилей памяти, в Go — один самонастраиваемый сборщик. Можно взять язык без GC: Swift считает ссылки, а Rust и Mojo следят за временем жизни объектов через систему типов.
В языке с GC паузы можно смягчить: переиспользовать объекты из пулов или хранить данные вне кучи (off-heap). Можно считать паузу GC короткой плановой остановкой: среда предупреждает о скорой сборке, приложение перестаёт слать узлу запросы и запускает GC без нагрузки. Ещё вариант — собирать только короткоживущие объекты и регулярно перезапускать процессы по одному, как при rolling upgrade. Полностью паузы так не убрать, но их влияние снижается.
Знание, истина и ложь
Заголовок раздела «Знание, истина и ложь»Узел ничего не знает о других наверняка. Он догадывается о них только по сообщениям, которые получил или не получил. Если узел не отвечает, узнать его состояние нельзя, потому что проблему сети не отличить от проблемы узла.
Вопрос похож на философский, но копать так глубоко не нужно. Достаточно явно описать допущения о поведении системы — модель системы (system model) — и доказать корректность алгоритма для этой модели. Тогда надёжное поведение достижимо, даже если модель почти ничего не гарантирует. Такие алгоритмы будут в главе 10.
Решает большинство
Заголовок раздела «Решает большинство»Авторы разбирают три сценария. В первом узел получает все сообщения, но его исходящие теряются. По timeout другие объявляют его мёртвым: его тащат на кладбище, а он кричит «Я не умер!», но его никто не слышит. Во втором узел сам замечает, что его сообщения не подтверждают, но сделать ничего не может. В третьем узел замирает на минуту, его объявляют мёртвым, а потом он продолжает работу как ни в чём не бывало и даже не знает, что его «похоронили».
Мораль: узел не может доверять собственной оценке ситуации, а система не может полагаться на один узел. Поэтому многие алгоритмы опираются на кворум — голосование узлов. Если кворум объявил узел мёртвым, тот обязан подчиниться и уйти со своей роли, даже если чувствует себя живым.
Чаще всего кворум — это больше половины узлов. Тогда система работает, пока сломано меньшинство: из трёх узлов можно потерять один, из пяти — два. И это безопасно: двух большинств с разными решениями одновременно не бывает. Подробнее кворумы разобраны вместе с консенсусом в главе 10.
Распределённые блокировки и lease
Заголовок раздела «Распределённые блокировки и lease»Блокировки и lease часто используют неправильно. Lease — это блокировка, которая истекает и переходит к новому владельцу, если старый перестал отвечать. Она нужна, когда исполнитель должен быть ровно один:
- только один узел может быть
leaderдляshard, иначе будетsplit brain— два узла сразу считают себя главными; - только один клиент может менять определённый объект, иначе одновременные записи его испортят;
- только один узел должен обрабатывать конкретный входной файл, иначе работа будет сделана дважды.
Если несколько узлов одновременно считают, что держат lease, в третьем случае файл обработают дважды, и это лишь потраченные впустую ресурсы. В первых двух можно потерять или испортить данные.
Авторы разбирают ошибку, которая на самом деле была в HBase. Файл может менять только один клиент, и перед записью клиент берёт lease у сервиса блокировок (lock service). Но если клиент замрёт надолго, lease истечёт, и её получит другой клиент. Первый проснётся, решит, что lease всё ещё у него, и продолжит писать. Записи смешаются и испортят файл. Тот же итог бывает и без паузы: клиент 1 отправил запись перед падением, она застряла в сети и дошла до хранилища, когда lease уже была у клиента 2.
Защита от зомби и задержанных запросов
Заголовок раздела «Защита от зомби и задержанных запросов»Зомби — это бывший владелец lease, который ещё не узнал, что потерял её. Исключить зомби нельзя, поэтому надо сделать так, чтобы они не навредили. Это называют fencing — «огородить» зомби.
Некоторые системы просто выключают зомби: отключают от сети или гасят машину (приём STONITH). Работает это плохо. Это не спасает от задержанного в сети запроса, узлы могут выключить друг друга, а данные могут испортиться раньше, чем зомби найдут.
Надёжнее другое решение. Выдавая lease, сервис блокировок возвращает fencing token — число, которое растёт с каждой выдачей. Клиент прикладывает token к каждой записи в хранилище. В Chubby, сервисе блокировок Google, это называют sequencer, в Kafka — epoch number, в Paxos и Raft — номер ballot или term.
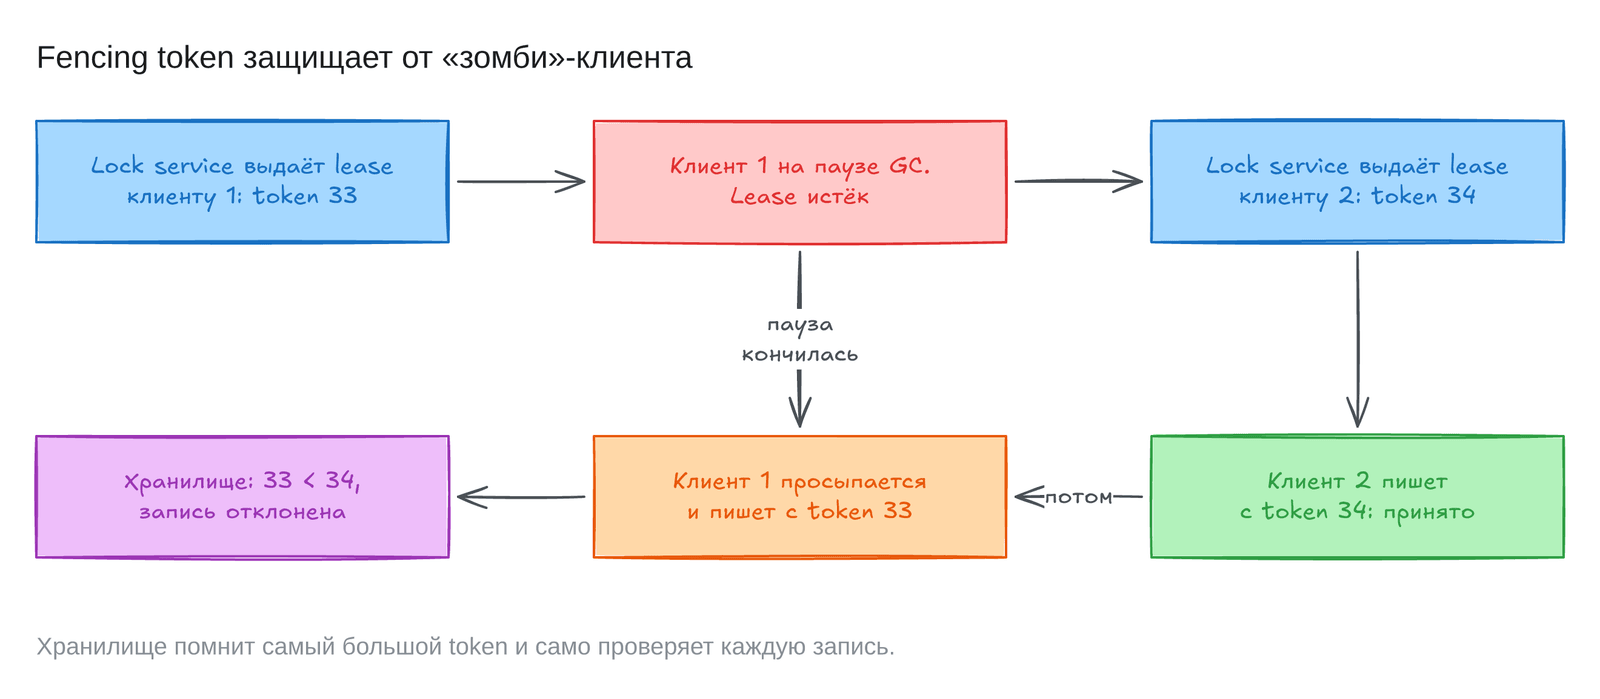
Схема повторяет пример из книги. Клиент 1 получает token 33 и замирает. Затем token 34 получает клиент 2 и пишет. Клиент 1 оживает и пишет с token 33, но хранилище уже видело 34 и отклоняет запрос. Новый владелец lease должен сразу записать что-то в хранилище: после этого все зомби огорожены.
Это похоже на оптимистичное управление конкурентным доступом (OCC) из главы 8, но зомби огорожен навсегда, а транзакцию после конфликта OCC можно повторить. В ZooKeeper роль token играет zxid или cversion, в etcd — номер ревизии вместе с ID lease, в Hazelcast token выдаёт FencedLock API. Вместо проверки token хранилище может поддерживать условную запись, как атомарный CAS (compare-and-set): запись проходит, только если объект не меняли с последнего чтения. Так умеют объектные хранилища: conditional writes в Amazon S3, conditional headers в Azure Blob Storage, request preconditions в Google Cloud Storage.
Fencing при нескольких репликах
Заголовок раздела «Fencing при нескольких репликах»Если клиенты пишут только в одно хранилище с условной записью, отдельный сервис блокировок почти не нужен. Но fencing token полезен, когда реплик несколько. Пусть хранилище — key-value база без leader с LWW (см. главу 6), где каждая реплика сама принимает решение по timestamp от клиента. Тогда token кладут в старшие цифры timestamp, и любой timestamp нового владельца больше любого timestamp старого.
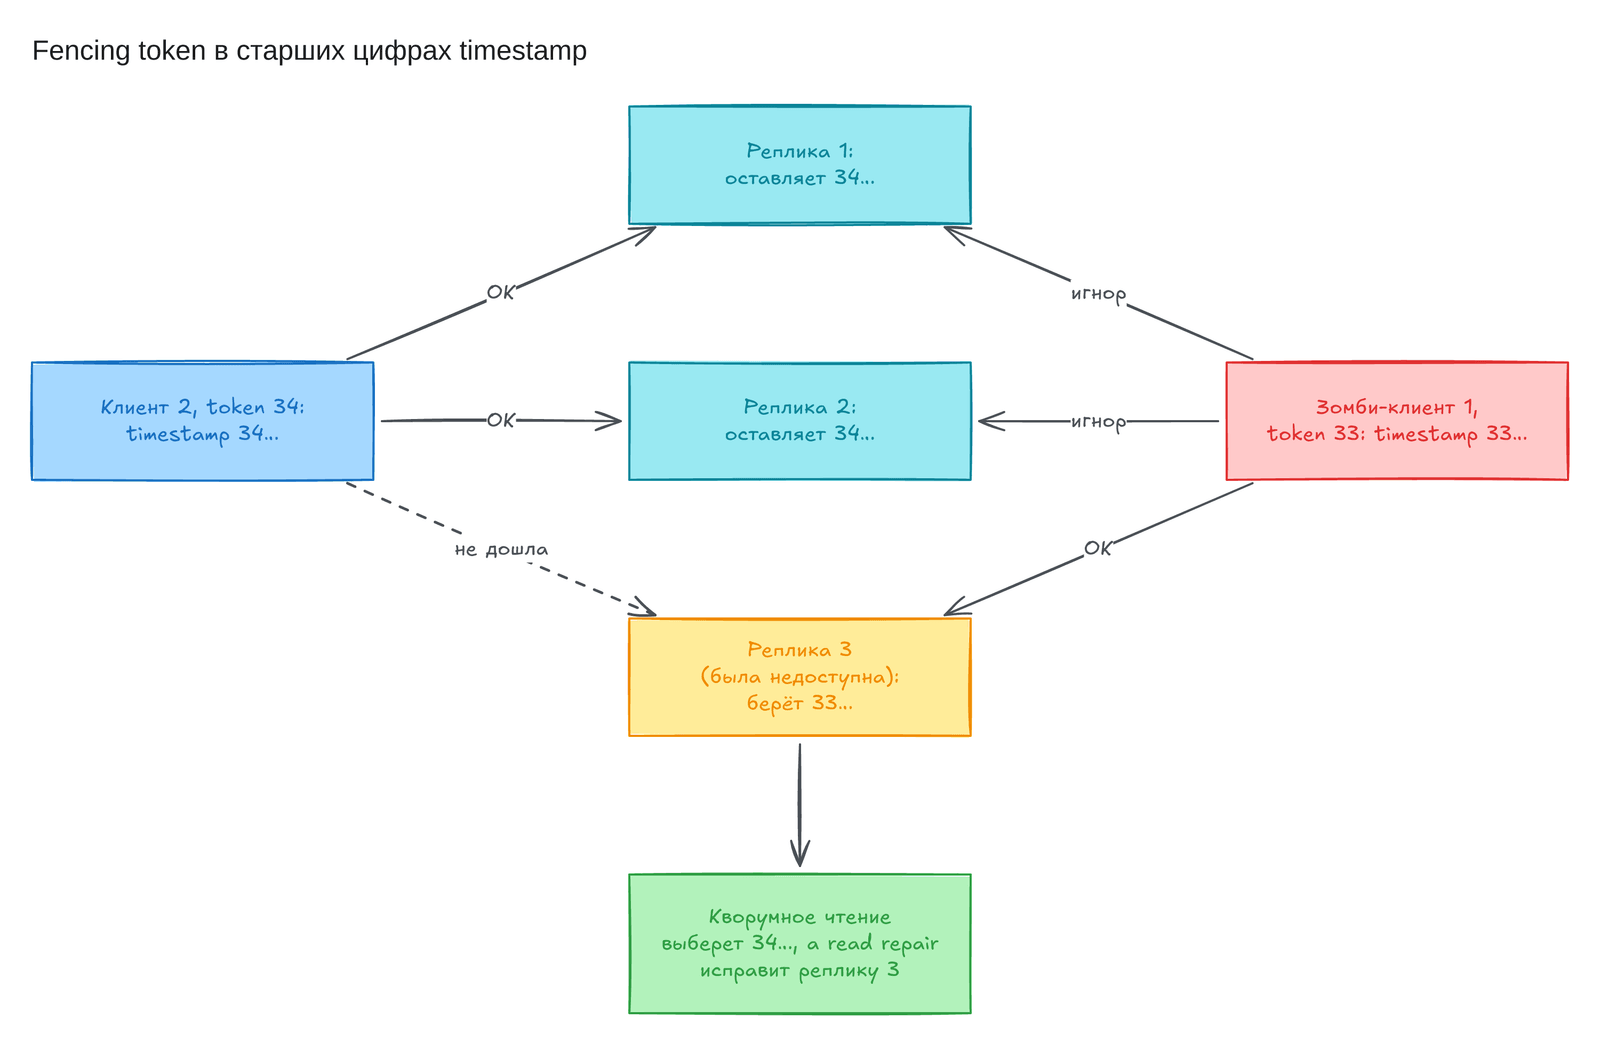
Клиент 2 с token 34 пишет в кворум реплик, но реплика 3 ему недоступна. Поэтому запись зомби-клиента 1 с timestamp 33… может пройти на реплике 3, хотя реплики 1 и 2 её игнорируют. Это не страшно: кворумное чтение выберет запись с большим timestamp, а read repair или anti-entropy со временем исправят реплику 3.
Вывод: нельзя считать, что lease держит только один узел. Но с fencing token зомби и задержанные запросы не навредят.
Византийские отказы
Заголовок раздела «Византийские отказы»Fencing token ловит узел, который ошибается нечаянно. Но узел, который хочет обмануть систему, легко подделает token. В этой книге узлы считают ненадёжными, но честными: они могут молчать или отставать, но если отвечают, то по правилам протокола.
Если узел может «лгать», например голосовать дважды и по-разному, задача намного труднее. Такое поведение называют Byzantine fault, а задачу консенсуса среди тех, кому нельзя доверять, — задачей византийских генералов. Она обобщает задачу двух генералов, которые договариваются о плане боя через гонцов, а гонцов теряют, как пакеты в сети. В византийской версии генералов n, среди них есть неизвестные предатели, и они шлют ложные сообщения. Название выбрал Лесли Лэмпорт: «византийский» давно значит «слишком запутанный и хитрый», а вариант «албанские генералы» ему отсоветовали.
Где нужна защита от византийских отказов
Заголовок раздела «Где нужна защита от византийских отказов»Система устойчива к византийским отказам, если работает верно, даже когда часть узлов нарушает протокол или злоумышленник вмешивается в сеть. Это нужно в особых случаях. В авиации и космосе радиация портит память, а цена отказа огромна. В системах из нескольких сторон участник может жульничать: консенсус в Bitcoin и других блокчейнах позволяет договориться без центральной власти.
В дата-центре такие отказы обычно можно не учитывать. Все узлы принадлежат вашей организации, радиация низкая, а арендаторов разделяют firewall, виртуализация и права доступа. Византийские протоколы дороги и для серверных систем данных непрактичны. Веб-приложение, конечно, должно ждать злого поведения от браузеров, поэтому проверяет ввод и экранирует вывод против SQL injection и cross-site scripting. Но здесь византийский протокол не нужен: сервер главный и сам решает, что клиенту можно. Такие протоколы нужнее в peer-to-peer сетях без центра.
От ошибок в коде такие алгоритмы не спасут. Им нужно, чтобы исправно работали больше двух третей узлов (из четырёх сломан может быть только один), а одна и та же программа на всех узлах ломается везде сразу. Против атак они тоже не помогут: взломав один узел, злоумышленник, скорее всего, взломает все. Главной защитой остаются аутентификация, права доступа, шифрование и firewall.
Слабые формы лжи
Заголовок раздела «Слабые формы лжи»Полезно защищаться от слабой «лжи»: неверных сообщений из-за сбоев железа, ошибок и неверных настроек. Пакеты иногда портятся так, что контрольные суммы TCP и UDP этого не ловят, поэтому помогают контрольные суммы в протоколе приложения или TLS. Публичное приложение должно проверять ввод: экранировать символы, проверять диапазон значений и ограничивать длину строк. Клиенту NTP задают несколько серверов. Он сверяет их и отбрасывает сервер, который расходится с большинством.
Модель системы и реальность
Заголовок раздела «Модель системы и реальность»Алгоритмы должны переживать сбои из этой главы и при этом не зависеть от конкретного железа. Поэтому ожидаемые сбои формализуют в модели системы — абстракции, которая описывает допущения алгоритма. По времени обычно используют три модели:
| Модель | Что допускает | Насколько реалистична |
|---|---|---|
| Синхронная | Задержка сети, паузы и ошибка часов ограничены известным пределом | Нереалистична: неограниченные задержки бывают |
| Частично синхронная | Обычно пределы соблюдаются, но иногда задержки, паузы и ошибка часов становятся сколь угодно большими | Реалистична для многих систем |
| Асинхронная | Никаких допущений о времени, нет даже часов и timeout | Алгоритмы для неё есть, но модель очень строгая |
По отказам узлов модели такие:
crash-stop: узел может только упасть и больше не вернуться;crash-recovery: узел падает и, возможно, возвращается через неизвестное время. Данные на диске сохраняются, данные в памяти теряются;- медленный узел: он отвечает на health check, но для работы слишком медленный. Сетевая карта из-за ошибки драйвера падает с гигабита до 1 Кбит/с, процесс почти всё время собирает мусор, изношенный SSD работает рывками. Это называют
limping nodeилиgray failure, и с ним труднее, чем с упавшим узлом; - византийские отказы: узел может делать что угодно, в том числе обманывать.
Для реальных систем обычно полезнее всего частично синхронная модель с crash-recovery.
Что значит «алгоритм корректен»
Заголовок раздела «Что значит «алгоритм корректен»»Корректность описывают через свойства. Для генератора fencing token это могут быть:
- уникальность: два запроса никогда не получают одинаковый token;
- монотонность: если запрос x закончился до начала запроса y, то token x меньше token y;
- доступность: узел, который запросил token и не упал, в итоге получит ответ.
Алгоритм корректен в модели, если выполняет свойства во всех ситуациях, которые модель допускает. Но если упадут все узлы, ни один алгоритм ничего не сделает. Как тогда давать гарантии?
Safety и liveness
Заголовок раздела «Safety и liveness»Здесь помогает разделение свойств. Уникальность и монотонность — свойства safety, а доступность — свойство liveness. В определении liveness часто есть слово «в итоге» (eventually), и eventual consistency — тоже свойство liveness.
Неформально safety значит «ничего плохого не случится», а liveness — «хорошее в итоге случится». Точнее так. Нарушение safety можно привязать к моменту, например к операции, которая вернула повторный token, и отменить его уже нельзя. Liveness в какой-то момент может не выполняться, но всегда есть надежда, что выполнится позже.
Обычно требуют, чтобы safety выполнялось всегда: даже если упали все узлы, алгоритм не вернёт неверный результат. Для liveness допустимы оговорки, например «ответ придёт, если большинство узлов живо и сеть в итоге восстановится».
Модели системы и реальный мир
Заголовок раздела «Модели системы и реальный мир»Модель — упрощение реальности. Алгоритмы crash-recovery считают, что диск переживает падение. Но диск может быть стёрт, а прошивка сервера может после перезагрузки не увидеть диски. Кворумные алгоритмы ломаются, если узел «забыл» данные, которые подтвердил.
Поэтому реализация должна обрабатывать и «невозможное», пусть даже кодом printf("Sucks to be you") и exit(666), то есть передачей проблемы человеку. При этом модели очень полезны: они сводят сложность реальной системы к набору сбоев, о которых можно рассуждать.
Формальные методы и случайное тестирование
Заголовок раздела «Формальные методы и случайное тестирование»Из-за конкурентности, частичных отказов и задержек возможных состояний огромное число. Можно доказать корректность алгоритма математически. Это не гарантирует, что верна реализация, но находит ошибки, которые иначе прячутся годами. Теорию разумно сочетать с тестами на случайных сценариях: property-based testing, fuzzing и deterministic simulation testing. Так работают Amazon Web Services, FoundationDB и TigerBeetle.
Model checking и языки спецификаций
Заголовок раздела «Model checking и языки спецификаций»Model checking — это автоматическая проверка спецификации алгоритма. Её пишут на языке вроде TLA+, Gallina или FizzBee, а model checker перебирает возможные события и проверяет инварианты. Все состояния он перебрать не может, их обычно бесконечно много. Поэтому модель упрощают или ограничивают, например числом сообщений, и ошибки длинных сценариев могут остаться.
И всё же model checker прост в работе и при этом находит неочевидные ошибки. Спецификации применяют CockroachDB, TiDB и Kafka. С помощью TLA+ показали возможную потерю данных в viewstamped replication из-за неоднозначного описания алгоритма. Минус в том, что проверяется модель, а не ваш код, и спецификация с кодом могут разойтись.
Fault injection
Заголовок раздела «Fault injection»Fault injection — это нарочное внесение сбоев в работающую систему: разрыв сети, падение машины, порча диска, пауза процесса. Тесты обычно идут в среде, близкой к production, а иногда прямо в production. Так делал Netflix с инструментом Chaos Monkey, и этот подход называют chaos engineering (см. главу 2).
Координатор решает, какие сбои и когда вызвать, а скрипты вносят их: kill для процесса, umount для диска, правила firewall для сети. Писать такие тесты трудно, поэтому часто берут готовую среду Jepsen. Она нашла критические ошибки во многих популярных системах.
Deterministic simulation testing
Заголовок раздела «Deterministic simulation testing»Deterministic simulation testing (DST) проверяет настоящий код, а не модель. Сеть, ввод-вывод и часы заменены заглушками (mock), и симулятор сам задаёт порядок событий, тайминги и сбои. Он прогоняет огромное число случайных сценариев. Упавший тест можно повторить точно, чего fault injection не умеет.
Симулятор должен контролировать весь недетерминизм. Код делают детерминированным на одном из трёх уровней:
| Уровень | Примеры |
|---|---|
| Приложение | FoundationDB построен на библиотеке Flow, куда подставляют симуляцию сети. TigerBeetle держит всё состояние как конечный автомат в одном цикле событий |
| Среда выполнения | FrostDB меняет среду Go, чтобы goroutine шли по очереди. Rust-библиотека MadSim подменяет Tokio, клиенты S3 и Kafka |
| Машина | Antithesis строит свой гипервизор, который делает детерминированными часы, сеть и хранилище для всей системы в контейнерах |
Кроме повторяемости, DST ускоряет тесты: время подменено, поэтому timeout не надо ждать по-настоящему. Antithesis ещё и делит тест на несколько веток, когда находит редкое поведение, и так проверяет больше путей в коде.
Сила детерминизма
Заголовок раздела «Сила детерминизма»Недетерминизм лежит в основе всех проблем главы. Если сделать систему детерминированной, всё сильно упрощается, и эта идея встречается в книге не раз:
- event sourcing проигрывает журнал событий и восстанавливает materialized view (см. главу 3);
- движки workflow требуют детерминированных workflow ради durable execution (см. главу 5);
- state machine replication выполняет одну и ту же последовательность детерминированных транзакций на каждой реплике (подробнее в главе 10).
Полный детерминизм требует аккуратности. Даже после замены сети, часов и случайных чисел остаются ловушки, например порядок обхода хеш-таблицы или нехватка памяти.
Итоги главы
Заголовок раздела «Итоги главы»- Пакет в сети может потеряться или задержаться на сколь угодно долгое время, ответ тоже. Если ответа нет, неизвестно, дошло ли сообщение.
- Частичные отказы — главная черта распределённых систем: любая операция с другими узлами может иногда сорваться, замедлиться или повиснуть до
timeout. - Сбой трудно даже обнаружить. Обычно для этого есть только
timeout, а он не отличает сбой сети от сбоя узла и иногда ложно хоронит живой узел. Медленные «хромые» узлы обнаружить ещё труднее. - Переменные задержки — плата за дешёвую общую сеть с коммутацией пакетов. Гарантии возможны, но они дороги, поэтому
timeoutподбирают по измерениям. - Часы узла могут сильно расходиться с другими, прыгать вперёд и назад, а их ошибку обычно никто не сообщает. Для длительности нужен
monotonic clock, для порядка событий —logical clock, а неLWWпо времени суток. - Процесс может замереть в любой точке (GC, VM, swap, ввод-вывод), его объявят мёртвым, а он вернётся, не зная о паузе.
- Узел не может доверять своему мнению о себе. Важные решения, включая решение о смерти узла, принимает кворум, а данные защищает
fencing token, который хранилище проверяет само. - Модель системы фиксирует допущения алгоритма. Чаще всего полезна частично синхронная модель с
crash-recovery.Safetyдолжно выполняться всегда, аlivenessможно обещать с оговорками. - Проверять алгоритмы помогают
model checking,fault injectionиdeterministic simulation testing. Детерминизм — сильный приём против всех описанных проблем. - Если задача помещается на одну машину, часто лучше так и сделать, например со встроенным движком хранения. Но отказоустойчивость и низкая задержка для пользователей по всему миру требуют многих узлов. Распределённая система может работать без остановки, потому что сбои и обслуживание обрабатывают на уровне узлов. Однако плохое изменение настроек, развёрнутое сразу на все узлы, всё равно остановит всю систему.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
Частичный отказ (partial failure) | Часть системы сломана, остальная работает |
timeout | Время ожидания ответа, после которого узел считают мёртвым |
| Перегрузка сети | Пакеты ждут в очереди коммутатора |
time-of-day clock | Часы с датой и временем, могут прыгать назад |
monotonic clock | Часы для длительности, идут только вперёд |
last write wins (LWW) | Побеждает запись с наибольшим timestamp. При расхождении часов теряет данные |
logical clock | Счётчик для порядка событий |
| Интервал уверенности | Время как диапазон [earliest, latest] |
lease | Блокировка с ограниченным сроком |
| Кворум | Решение большинства узлов |
fencing token | Растущий номер lease. Хранилище отклоняет записи с меньшим номером |
Byzantine fault | Узел лжёт или ведёт себя произвольно |
| Модель системы | Допущения алгоритма о времени и отказах |
gray failure | Узел жив, но слишком медленный |
safety / liveness | «Плохое не случится» / «хорошее в итоге случится» |
DST | Тест настоящего кода в детерминированной симуляции |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Любой вызов по сети может не вернуть ответ. Тогда неизвестно, выполнился ли он. Делайте операции
idempotentи повторяйте безопасно. Это важно для загрузки данных, API и записи в хранилища. - Не используйте время суток для порядка событий и разрешения конфликтов. Для дедупликации и версий берите sequence number,
offset, версию строки, а неupdated_atс разных серверов. - Для
timeoutи длительности беритеmonotonic clock. Следите за дрейфом NTP на узлах кластера. - Если процесс в
pipelineдержит lock илиlease(например, единственный writer), добавьтеfencing tokenили проверку версии на стороне хранилища. Пауза GC или остановка контейнера может превратить процесс в «зомби». - Для файлов в S3, GCS или Azure Blob используйте условную запись (conditional writes, preconditions): так хранилище само отклонит запись устаревшего writer.
- Задавайте
timeoutпо измеренным задержкам, а не по ощущениям. Слишком короткийtimeoutу клиента БД или оркестратора вызывает ложныеfailoverи перезапуски. - Тестируйте сбои: отключение узла, медленная сеть, пауза процесса. Это дешевле, чем разбор потери данных.
- Если задача помещается на один сервер, не усложняйте её распределением.
Пример на Python: lease, пауза и fencing token
Заголовок раздела «Пример на Python: lease, пауза и fencing token»В книге код цикла с lease написан на Java-подобном псевдокоде. Наша версия моделирует тот же сценарий на Python с модельным временем, поэтому вывод всегда одинаковый. Клиент 1 получает lease на 30 секунд, проверяет её в t=5 и замирает на 40 секунд. Тем временем lease получает клиент 2. Полный скрипт: scripts/ddia-code/ch09_lease_pause.py, запуск python3 -I scripts/ddia-code/ch09_lease_pause.py.
Вся защита — одна проверка в хранилище:
class Storage:    """Хранилище файла. С fencing=True помнит самый большой token и отклоняет меньшие."""
    def __init__(self, fencing):        self.fencing, self.max_token, self.log = fencing, 0, []
    def write(self, client, token, data):        if self.fencing and token < self.max_token:            return f"отклонено (token {token} < {self.max_token})"        self.max_token = max(self.max_token, token)        self.log.append(f"{client}:{data}")        return "принято"
Реальный вывод скрипта:
--- хранилище без проверки fencing token ---t=0 client1 получил lease, token 33, lease до t=30t=5 client1 проверил lease: в запасе 25 с, можно писатьt=31 lease client1 истёк, client2 получил lease, token 34t=32 client2 пишет: принятоt=45 client1 проснулся и пишет: принято в хранилище: ['client2:B', 'client1:A']--- хранилище с проверкой fencing token ---t=0 client1 получил lease, token 33, lease до t=30t=5 client1 проверил lease: в запасе 25 с, можно писатьt=31 lease client1 истёк, client2 получил lease, token 34t=32 client2 пишет: принятоt=45 client1 проснулся и пишет: отклонено (token 33 < 34) в хранилище: ['client2:B']Без проверки хранилище принимает обе записи, и запись зомби ложится поверх записи нового владельца. С проверкой запись с token 33 отклонена.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему клиент не может отличить потерянный запрос от потерянного ответа? Что из этого следует для повторов?
- Почему нет «правильного»
timeout? Что произойдёт, если он слишком короткий, а что — если слишком длинный? - Чем
monotonic clockотличается отtime-of-day clock? Когда использовать каждый? - Как
LWWможет молча потерять запись, даже если часы расходятся меньше чем на 3 мс? - Как
fencing tokenзащищает от клиента, который проспал свой lease? Почему проверку делает хранилище, а не клиент? - Чем
safetyотличается отliveness? Почемуsafetyтребуют всегда, а дляlivenessдопускают оговорки?
Предыдущая: Транзакции. Следующая: Согласованность и консенсус.