

Designing Data-Intensive Applications, глава 11: Пакетная обработка
Главная мысль: batch job читает неизменяемый вход и каждый раз заново строит выход, поэтому ошибку в коде исправляют перезапуском. Современная пакетная обработка похожа на распределённую операционную систему: хранилище (DFS или S3), оркестратор и движок вроде Spark, на котором пишут SQL или DataFrame.
О чём глава
Заголовок раздела «О чём глава»До сих пор книга говорила о запросах и быстрых ответах. Глава 11 разбирает большие вычисления, которые идут минуты и часы. В главе 10 узлы договаривались друг с другом, а здесь они вместе обрабатывают огромный набор данных. Темы главы:
- анализ лога Unix-командами и почему сортировка масштабируется;
- распределённые файловые системы, объектные хранилища и оркестраторы;
- MapReduce,
dataflow engine,shuffleи joins; - SQL,
DataFrameи сближение с облачными хранилищами данных; - применения: ETL, аналитика, машинное обучение, выдача производных данных.
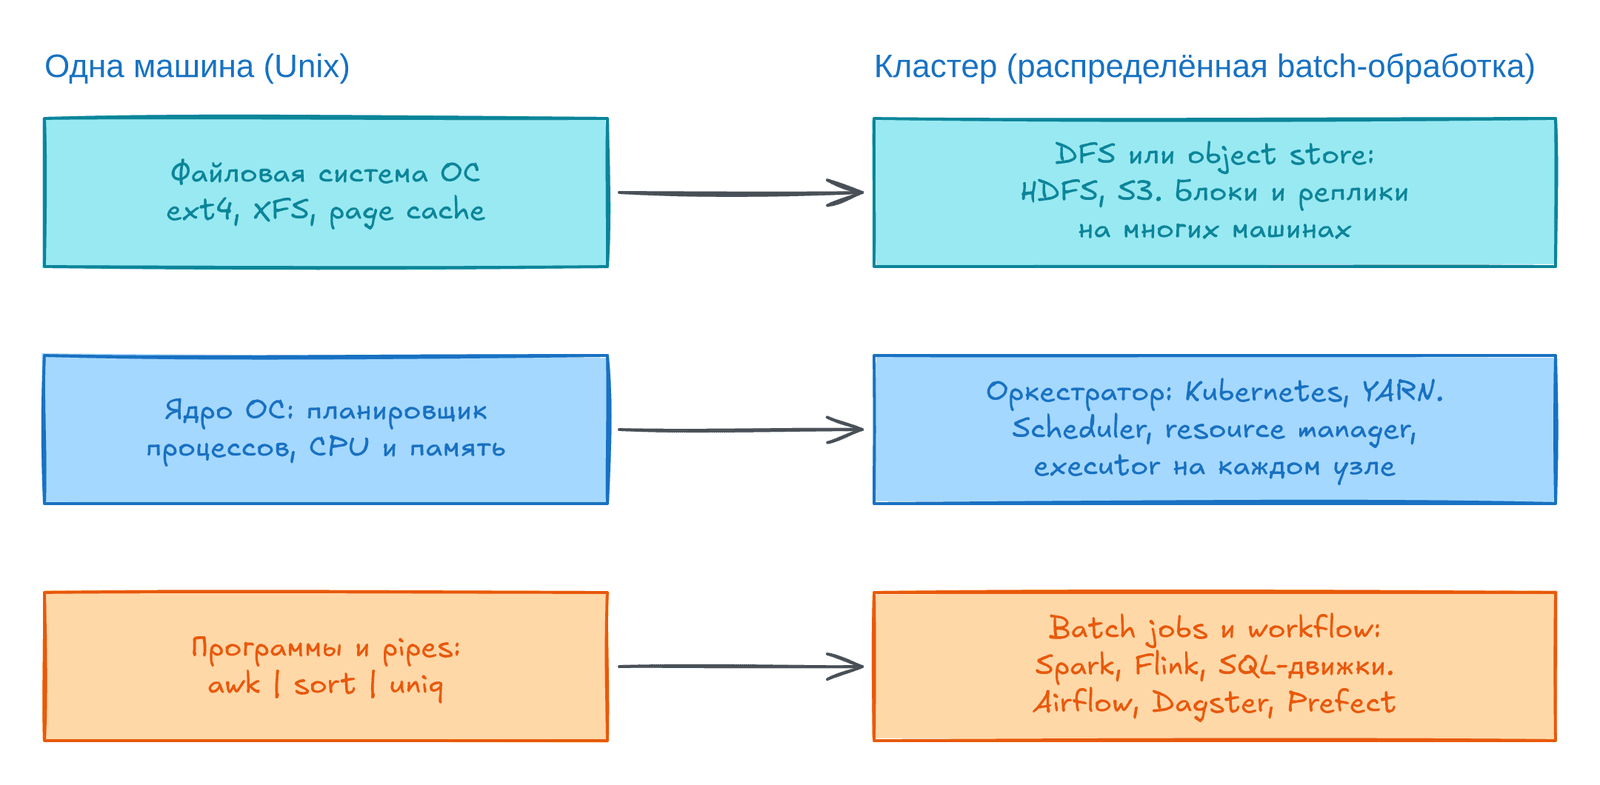
Схема показывает главную аналогию главы: слева части Unix-машины, справа их аналоги в кластере.
Онлайн-системы и пакетная обработка
Заголовок раздела «Онлайн-системы и пакетная обработка»Браузер, API, база данных и кэш работают по одной схеме: пришёл запрос, нужен быстрый ответ. Авторы называют их онлайн-системами. Их главная мера — время ответа.
Но иногда нужно обучить AI-модель, перегнать много данных в другой формат или посчитать аналитику по огромному набору. Такие задачи называют batch job, а системы для них — офлайн-системами. Batch job — это задача, которая читает вход, не меняя его, и каждый раз строит выход с нуля. Выход — это производные данные (см. главу 1). Если результат плохой, его удаляют, правят логику и запускают job снова.
Неизменяемый вход и отсутствие побочных эффектов дают несколько плюсов:
- Откат ошибок. Если код испортил выход, верните старый код и перезапустите job. Или держите старый выход в другом каталоге и переключитесь на него: объектные хранилища и открытые табличные форматы умеют это под названием
time travel. В базе с транзакциями откат кода не исправит уже записанные плохие данные. Эту способность пережить ошибку в коде называютhuman fault tolerance. - Быстрая разработка. Ошибку легко отменить, поэтому новые функции разрабатывают быстрее.
- Общий вход. Одни и те же файлы читают и рабочие jobs, и jobs мониторинга, которые сравнивают новый выход с прошлым.
- Экономия ресурсов. Через OLTP-базу большие объёмы обрабатывать намного дороже.
Минусы тоже есть. Обычно выход можно читать только после конца всего job. А любое изменение входа, даже в один байт, требует обработать весь набор заново.
Batch job идёт минуты, часы или дни, часто по расписанию, например раз в сутки. Его главная мера — throughput: сколько данных он обрабатывает за единицу времени. Граница с онлайн-системами размыта: долгий запрос к базе тоже похож на batch job. Пакетная обработка хорошо подходит для интеграции данных, когда несколько систем вместе делают то, что одна не может; классический пример — ETL. Альтернатива — потоковая обработка: job не заканчивается, а обрабатывает изменения вскоре после того, как они случились. Ей посвящена глава 12.
От MapReduce к Spark и облаку
Заголовок раздела «От MapReduce к Spark и облаку»На пакетную обработку сильно повлиял MapReduce. Google опубликовала этот алгоритм в 2004 году, потом его повторили Hadoop, CouchDB и MongoDB. MapReduce — довольно низкоуровневая модель программирования, она устроена примитивнее параллельных движков запросов в хранилищах данных. Когда-то она позволила обрабатывать огромные объёмы на обычном железе, но сейчас почти устарела, и в Google её больше не используют.
Сегодня batch jobs пишут на Spark и Flink или запускают в хранилищах данных. Они тоже опираются на sharding (см. главу 7) и параллельность, но кэшируют и планируют работу умнее. Проблемы эксплуатации в целом решены, и внимание сместилось к удобству: DataFrame, языки запросов, оркестраторы Airflow, Dagster и Prefect вместо Oozie и Azkaban. Хранение переезжает из HDFS в объектные хранилища вроде S3, а BigQuery и Snowflake стирают границу между хранилищем данных и пакетной обработкой.
Пакетная обработка Unix-инструментами
Заголовок раздела «Пакетная обработка Unix-инструментами»Пусть веб-сервер на каждый запрос дописывает строку в лог. В формате NGINX строка содержит IP клиента, время, путь запроса, код ответа, размер ответа, страницу-источник и браузер. Разбор логов кажется надуманным примером, но на нём держатся многие компании, от рекламы до платежей. Именно анализ логов во многом ускорил распространение MapReduce и движения «big data».
Простой анализ лога
Заголовок раздела «Простой анализ лога»Пять самых популярных страниц сайта находит цепочка Unix-команд:
cat /var/log/nginx/access.log | # читаем лог awk '{print $7}' | # берём 7-е поле: URL запроса sort | # одинаковые URL встают рядом uniq -c | # схлопываем повторы и считаем их sort -r -n | # сортируем по числу, большие сверху head -n 5 # оставляем первые пять строкПервый sort ставит одинаковые URL подряд, а uniq -c сравнивает соседние строки и считает повторы. Такая цепочка обрабатывает гигабайты логов за секунды, и её легко менять: например, {print $1} вместо {print $7} считает IP-адреса. Авторы советуют выучить awk, sed, grep, sort, uniq и xargs: с ними многие анализы занимают минуты.
Цепочка команд или своя программа
Заголовок раздела «Цепочка команд или своя программа»То же можно написать на Python со словарём счётчиков:
counts = defaultdict(int) # URL -> сколько раз встретилсяwith path.open() as f: for line in f: url = line.split()[6] # 7-е поле, индекс 6 counts[url] += 1top5 = sorted(((c, u) for u, c in counts.items()), reverse=True)[:5]Мы сгенерировали лог из 20 000 строк и прогнали обе версии скриптом scripts/ddia-code/ch11_top_urls.py. Результаты совпадают:
Unix pipeline:5866 /favicon.ico4089 /blog/kafka.html3264 /blog/duckdb.html2751 /1735 /css/typography.cssPython:5866 /favicon.ico4089 /blog/kafka.html3264 /blog/duckdb.html2751 /1735 /css/typography.cssСовпадает: TrueКакая версия приятнее — дело вкуса. Важнее, что они выполняются по-разному, и на большом файле это заметно.
Сортировка или агрегация в памяти
Заголовок раздела «Сортировка или агрегация в памяти»Python держит хеш-таблицу URL в памяти, а Unix-цепочка сортирует список, где один URL повторяется много раз. Что лучше, зависит от числа разных URL. Рабочий набор (working set) — это объём памяти, к которому job обращается в произвольном порядке. Здесь он зависит только от числа разных URL: миллион запросов к одной странице занимают одну запись. Если рабочий набор мал (у среднего сайта влезет, скажем, в 1 ГБ), хеш-таблица отлично работает даже на ноутбуке.
Если рабочий набор больше памяти, выигрывает сортировка. Как в log-structured хранилищах из главы 4, куски сортируют в памяти, пишут на диск сегментами и сливают. Mergesort читает и пишет последовательно, а это быстро для дисков. GNU sort сам сбрасывает данные на диск и распараллеливает сортировку по ядрам, поэтому узким местом, скорее всего, станет скорость чтения файла с диска. Но Unix-инструменты работают на одной машине. Если данные не влезают на её диск, нужны распределённые фреймворки.
Пакетная обработка в распределённых системах
Заголовок раздела «Пакетная обработка в распределённых системах»Машина из примера использует три части: накопители за файловой системой ОС, планировщик процессов и программы, у которых stdin и stdout соединены pipes. Те же части есть в распределённых фреймворках (см. схему в начале). Их можно считать распределёнными операционными системами.
Распределённые файловые системы
Заголовок раздела «Распределённые файловые системы»Файловая система ОС состоит из слоёв. Внизу драйверы читают и пишут сырые блоки диска. Над ними page cache держит недавние блоки в памяти. Файловая система (ext4, XFS) режет файлы на блоки и ведёт метаданные. Наверху виртуальная файловая система (VFS) даёт приложениям общий API.
Распределённая файловая система (DFS) устроена так же, только блоки лежат на многих машинах. Блоки гораздо крупнее: 128 МБ в HDFS, 4 МБ в JuiceFS и многих объектных хранилищах против 4096 байт в ext4. Крупные блоки дают меньше метаданных, что важно на петабайтах, и делают поиск блока дешевле его чтения. Диск не умеет писать неполные блоки, поэтому ОС занимает целый блок, даже если данных меньше. DFS работает поверх файловой системы ОС, и у неё такого требования нет: файл в 900 МБ займёт семь блоков по 128 МБ и один в 4 МБ.
Блоки читают по сети. На каждой машине работает демон, который хранит блоки как локальные файлы: DataNode в HDFS, glusterfsd в GlusterFS, в книге — data node. Его ОС кэширует частые блоки в памяти, а JuiceFS добавляет кэш на клиенте. Метаданные (где блоки, права доступа) хранит отдельный сервис: NameNode в Hadoop, а 3FS от DeepSeek пишет их в key-value-хранилище вроде FoundationDB.
Аналог VFS — протокол DFS. Подойдёт любое хранилище, которое его реализует. Например, API S3 повторили MinIO, Cloudflare R2, Backblaze B2 и другие, поэтому фреймворк с поддержкой S3 работает с любым из них. Некоторые DFS совместимы с POSIX и подключаются к VFS через FUSE или NFS. Amazon EFS и Archil дают NFS-совместимые системы, которые масштабируются гораздо лучше классического NFS: клиент видит одну точку входа, а внутри работают распределённые сервисы.
DFS и сетевые хранилища
Заголовок раздела «DFS и сетевые хранилища»DFS построены по принципу shared-nothing, а NAS и SAN — по принципу shared-disk: центральное устройство со специальным железом и сетью вроде Fibre Channel. DFS хватает обычных компьютеров в обычной сети. Недорогое железо ломается чаще, поэтому блоки реплицируют на несколько машин (см. главу 6). Заодно планировщик может запустить задачу на любом узле с копией её входа. Вместо полных копий можно использовать erasure coding, например коды Рида–Соломона: они восстанавливают потерянные данные и занимают меньше места. Идея похожа на RAID, только по сети и без особого железа.
Объектные хранилища
Заголовок раздела «Объектные хранилища»Объектные хранилища (object store) — S3, Google Cloud Storage, Azure Blob Storage — стали популярной заменой DFS. Граница размыта: через FUSE S3 выглядит как файловая система, а JuiceFS и Ceph дают оба API. Но скорость и гарантии согласованности у них разные, и авторы советуют проверять поведение, а не только наличие API.
Адрес объекта выглядит так: s3://my-photo-bucket/2025/04/01/birthday.png. Здесь my-photo-bucket — это bucket с глобально уникальным именем, а остальное — ключ, уникальный внутри bucket. Объект читают через get и пишут через put. После записи он не меняется: чтобы обновить, его перезаписывают целиком. Дописывать в конец умеют лишь Azure Blob Storage и S3 Express One Zone, а fopen и fseek они не поддерживают.
Каталогов в объектном хранилище нет, слеши — просто часть ключа. Список по префиксу отличается от просмотра каталога: он рекурсивный, как ls -R, и пустых «каталогов» не бывает. Если удалить все объекты под префиксом, он исчезнет из списка, поэтому иногда создают пустой объект-заглушку. Нет и ссылок, блокировок и атомарного переименования: объект копируют под новым ключом и удаляют старый. Чтобы переименовать «каталог», переименовывают каждый объект в нём.
Key-value-хранилища из главы 4 рассчитаны на мелкие значения и частые быстрые операции. DFS и объектные хранилища — на большие объекты (мегабайты и гигабайты) и редкие крупные чтения. Впрочем, S3 Express One Zone уже отвечает за миллисекунды и стоит почти как key-value-хранилище. Ещё одно отличие: HDFS умеет запускать задачу там, где лежит её файл, и не гонять его по сети. Объектные хранилища отделяют хранение от вычислений. Трафика больше, но сети в дата-центрах быстрые, а CPU и память можно масштабировать отдельно от хранилища.
Распределённая оркестрация jobs
Заголовок раздела «Распределённая оркестрация jobs»На одной машине ядро ОС запускает процессы, передаёт между ними данные, выделяет память и делит CPU. В кластере это делает оркестратор. Фреймворк просит его запустить job и передаёт метаданные. Среди них число задач (task), память, CPU и диск для каждой, вход и выход, нужное железо (например, GPU), учётные данные и адрес кода. Оркестраторы вроде Kubernetes и YARN выполняют job с помощью трёх частей:
| Часть | Что делает | Примеры |
|---|---|---|
executor | Демон на узле: скачивает код, запускает task, следит за ней, шлёт heartbeat. Через cgroups изолирует задачи друг от друга | NodeManager в YARN, kubelet в Kubernetes |
resource manager | Знает ресурсы и состояние всех узлов. Из-за централизации может стать узким местом | Состояние хранят в ZooKeeper (YARN) или etcd (Kubernetes) |
Планировщик (scheduler) | Принимает запросы на запуск и остановку jobs и решает, какая task пойдёт на какой узел | «10 tasks из этого Docker-образа на узлах с нужной GPU» |
Иногда нужны ещё планировщики под конкретное приложение: ApplicationMaster в YARN, операторы в Kubernetes.
Распределение ресурсов
Заголовок раздела «Распределение ресурсов»Планировщик делит ограниченные ресурсы и ищет баланс между справедливостью и эффективностью. Пример из книги: в кластере 160 ядер, а два jobs просят по 100. Можно дать каждому по 80 и запускать остальное по мере освобождения ядер. Можно применить gang scheduling: запустить все задачи одного job вместе, а второй — когда освободятся 100 ядер. А если второй запрос придёт позже, неясно, держать ли ядра про запас для job, который может и не прийти.
У каждого варианта своя цена. При gang scheduling узлы простаивают, пока копятся 100 ядер, а если ядра копят несколько jobs, возможен deadlock. Если просто ждать, ядра могут перехватить другие, и job будет голодать (starvation). Можно вытеснить (preemption) часть задач первого job, но их потом придётся перезапускать. Для миллионов запросов задача NP-трудная, поэтому планировщики используют эвристики: FIFO, dominant resource fairness (DRF), очереди с приоритетами, квоты и bin packing.
Планирование workflow
Заголовок раздела «Планирование workflow»Как Unix-команды соединены pipes, так и выход одного job часто становится входом других. Такой граф называют workflow, или DAG jobs.
Пояснение: в главе 5 «workflow» означал
durable execution: надёжные шаги с вызовами RPC. В пакетной обработкеworkflow— это цепочка batch jobs, которые читают и пишут данные и обычно не вызывают внешние сервисы.
Workflow нужен в трёх случаях. Выход одного job читают jobs разных команд. Данные переходят из инструмента в инструмент: Spark пишет в HDFS, затем Trino обрабатывает файлы и пишет в S3. Или стадиям нужен sharding по разным ключам.
Unix-pipe держит маленький буфер в памяти. Если буфер полон, отправитель ждёт получателя — это backpressure. Spark и Flink тоже умеют передавать выход задачи прямо в другую задачу. Но чаще job пишет выход в DFS или S3, а следующий читает его оттуда. Так jobs не зависят друг от друга и могут идти в разное время, а job с несколькими входами ждёт, пока успешно закончатся все jobs, которые их производят. Планировщики оркестраторов (ResourceManager в YARN, планировщик Spark) управляют отдельными jobs. Зависимости между jobs ведут Airflow, Dagster и Prefect. Без них сложно управлять такими графами: workflow из 50–100 jobs — обычное дело.
Обработка сбоев
Заголовок раздела «Обработка сбоев»Долгий job с множеством параллельных задач скорее всего столкнётся со сбоем хотя бы одной из них: из-за железа, сети (см. главу 9) или вытеснения. Дешёвые машины с низким приоритетом облако может забрать в любой момент: spot instance в EC2, spot VM в Azure, preemptible instances в Google Cloud. Пакетной обработке обычно не к спеху, поэтому такие машины ей подходят и повышают загрузку кластера. Минус в том, что вытеснение случается чаще, чем сбои железа, поэтому такие задачи убивают чаще.
Batch job строит выход с нуля, поэтому сбой обработать просто: удалить частичный выход и запустить задачу на другой машине. Перезапускать весь job расточительно, поэтому MapReduce и его наследники повторяют работу по одной задаче.
Сложнее, когда выход одной задачи — вход другой. MapReduce пишет промежуточные данные в DFS и даёт их читать только после успешного конца задачи. Это надёжно, но записей в DFS много. Spark держит промежуточные данные в памяти (или на локальном диске) и помнит, как их получил, чтобы при потере вычислить заново. Flink периодически делает checkpoint — снимок состояния задач.
Модели пакетной обработки
Заголовок раздела «Модели пакетной обработки»Две главные модели — MapReduce и dataflow engine. Второй почти вытеснил первый, но MapReduce полезно понимать: он повлиял на многие фреймворки. Обе модели сейчас поддерживают низкоуровневые API, SQL и DataFrame, поэтому с данными работают и инженеры, и аналитики, и нетехнические сотрудники.
MapReduce
Заголовок раздела «MapReduce»MapReduce обрабатывает данные почти как наша цепочка команд:
- Прочитать входные файлы и разбить на записи. Вход лежит в HDFS или S3 в форматах вроде Parquet (колоночный, глава 4) или Avro (строковый, глава 5).
- Вызвать
mapper, который достаёт из записи ключ и значение. В примере этоawk '{print $7}'. - Отсортировать пары по ключу, как первый
sort. - Вызвать
reducer, который проходит по отсортированным парам. Одинаковые ключи стоят рядом, поэтому их легко объединить без большого состояния. В примере этоuniq -c.
Разработчик пишет только шаги 2 и 4. Шаг 1 делает парсер формата, а сортировку MapReduce выполняет сам.
Mapperвызывается для каждой записи и выдаёт сколько угодно пар ключ-значение, в том числе ни одной. Состояния между записями он не хранит, поэтому многоmapperработают параллельно.Reducerполучает от фреймворка все значения одного ключа и выдаёт выходные записи, например число запросов к URL. Разные ключи тоже обрабатываются параллельно.
Второй sort из Unix-примера требует второго MapReduce job, который читает выход первого. В такой цепочке видно разделение ролей: mapper готовит данные к сортировке, а reducer обрабатывает уже отсортированные данные.
MapReduce и функциональное программирование
Заголовок раздела «MapReduce и функциональное программирование»map и reduce (fold) пришли из Lisp как функции высшего порядка. Главный принцип — отказ от изменяемого состояния: каждый вызов зависит только от данных, которые передал фреймворк. Поэтому фреймворк может запускать вызовы параллельно на разных узлах, а при сбое — повторить вызов на другом.
Но писать сложную обработку на «голом» MapReduce трудно: даже join приходится писать с нуля. К тому же он медленный: передача данных через файлы не даёт следующему job начать работу до конца предыдущего.
Dataflow engines
Заголовок раздела «Dataflow engines»Эти проблемы решают Spark и Flink. Общее у них одно: весь workflow для них — один job. Они явно моделируют поток данных через стадии, поэтому их называют dataflow engine. Кроме функции на каждую запись, у них есть операторы join, group by, filter и агрегации, а внутри эти операторы работают через shuffle. Операторы не обязаны чередоваться как map и reduce.
Подход вырос из исследовательских систем Dryad и Nephele. Его преимущества перед MapReduce:
- сортировка идёт только там, где нужна, а не между каждыми map и reduce;
- операторы подряд, которые не меняют
sharding(map, filter), склеиваются в одну задачу; - зависимости объявлены явно, поэтому планировщик может поставить задачу-потребителя рядом с задачей-производителем и передать данные через память, а не по сети;
- промежуточные данные лежат в памяти или на локальном диске, а не в DFS с репликами;
- оператор стартует, как только готов его вход;
- процессы переиспользуются, а MapReduce запускает новую JVM на каждую задачу.
Поэтому те же вычисления dataflow engine обычно выполняет заметно быстрее.
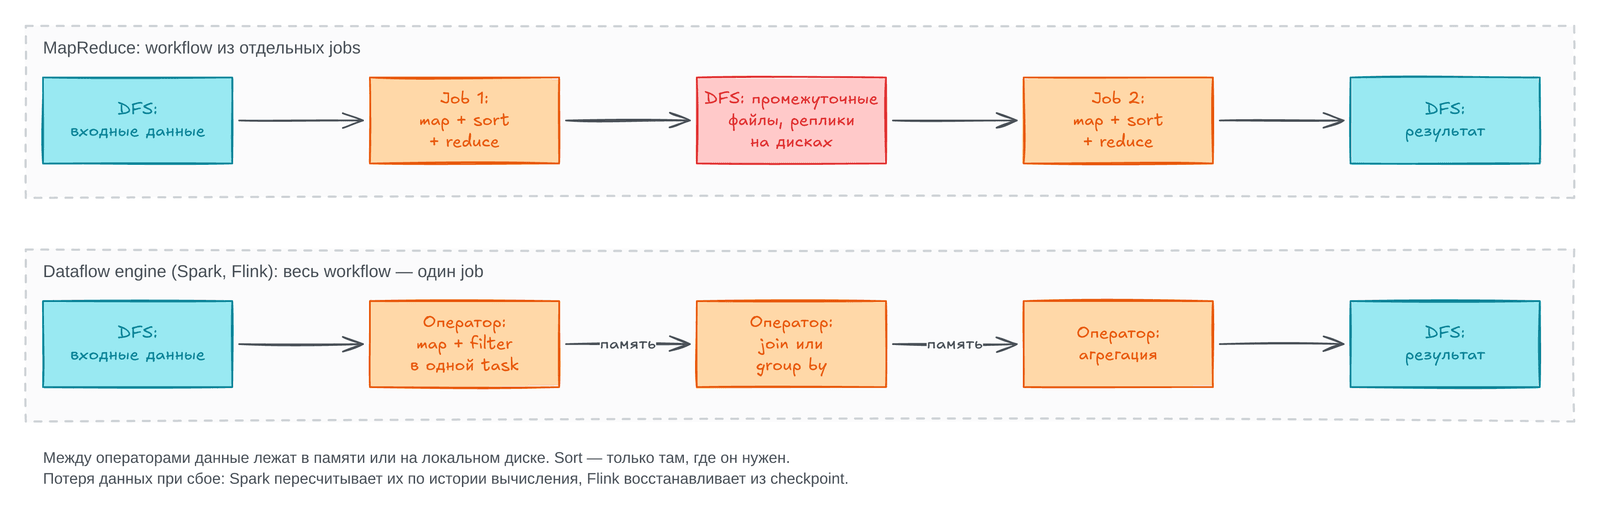
Верхний ряд — workflow на MapReduce: каждый job пишет промежуточный результат в DFS. Нижний ряд — тот же расчёт в dataflow engine: в DFS попадают только вход и итог.
Shuffle: распределённая сортировка
Заголовок раздела «Shuffle: распределённая сортировка»Сортировать нужно петабайты, которые не влезают на одну машину. Распределённый алгоритм сортировки, у которого и вход, и выход разделены на shard, называют shuffle.
Пояснение: перетасованная (shuffled) колода лежит в случайном порядке, а
shuffleв пакетной обработке даёт отсортированный порядок без всякой случайности.
На shuffle держатся joins и агрегации, его реализуют MapReduce, Spark, Flink, Daft, Dataflow и BigQuery. Авторы разбирают его на Hadoop MapReduce. Пусть вход разделён на shard m1, m2 и m3: это отдельные файлы HDFS или объекты под одним префиксом.
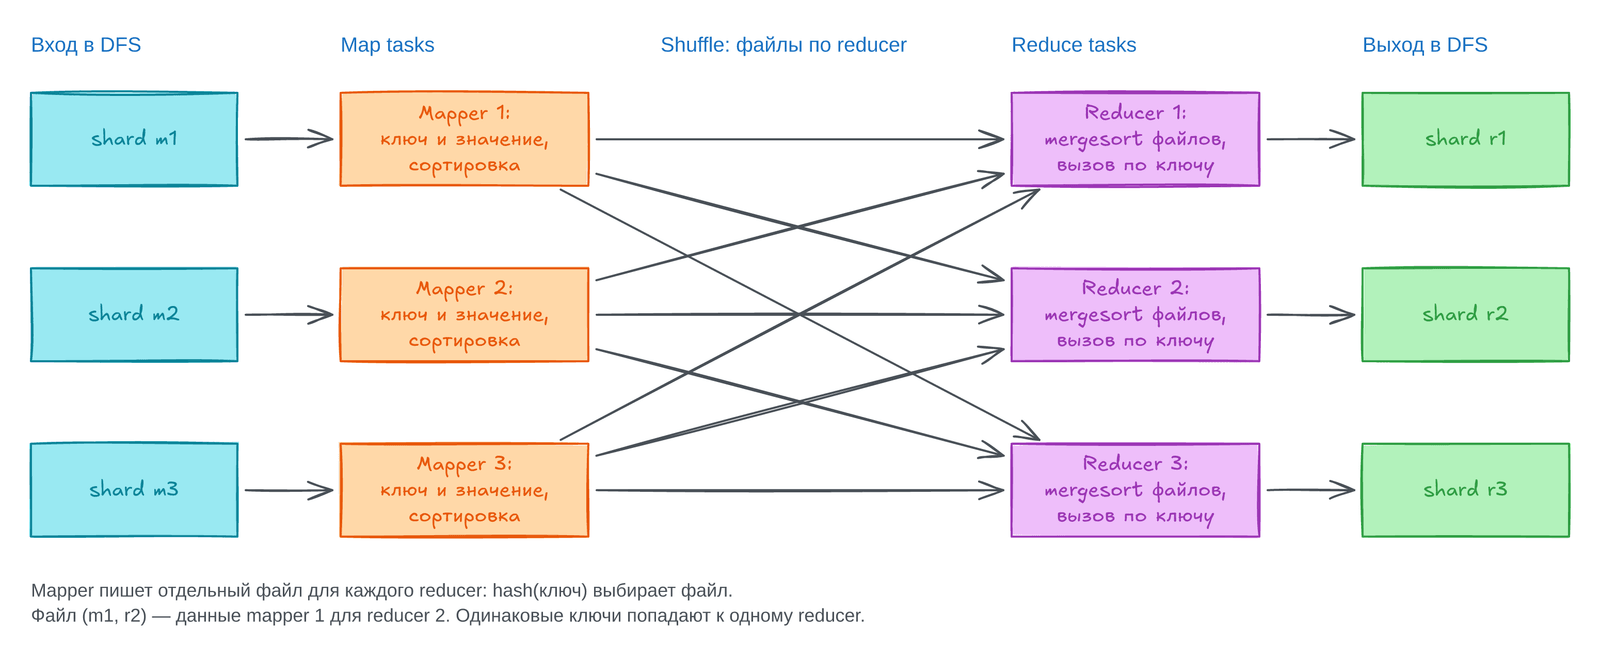
Схема читается слева направо. На каждый входной shard запускается map-задача. Число reduce-задач задаёт автор job, и оно может отличаться от числа map-задач. Пары с одним ключом должны попасть к одному reducer, поэтому mapper пишет на локальный диск отдельный файл для каждого reducer. Файл (m1, r2) — это данные mapper 1 для reducer 2. Нужный файл определяет хеш ключа, как при sharding по хешу в главе 7. Внутри файла mapper сортирует пары, как log-structured хранилище: копит в памяти, пишет сегменты и сливает их.
Когда mapper закончил, каждый reducer копирует у него свой файл. Собрав файлы от всех mapper, reducer сливает их с сохранением порядка. Теперь пары одного ключа стоят подряд, и функция reducer вызывается по разу на ключ. Её выход пишется в один файл на задачу, и файлы r1, r2, r3 становятся shard результата в DFS.
Современные движки делают shuffle умнее. Например, BigQuery держит его данные в памяти и пишет во внешние сервисы сортировки, которые ускоряют shuffle и реплицируют данные ради надёжности.
Joins и группировка
Заголовок раздела «Joins и группировка»Пример из книги: лог действий пользователей на сайте (clickstream) и база пользователей. Это часть star schema (см. главу 3): лог — таблица фактов (fact table), база пользователей — измерение. Мы хотим узнать, какие страницы популярнее у молодых, а какие — у пожилых. Дата рождения лежит в профиле, значит, нужен join, а обе таблицы так велики, что разделены на shard.
Shuffle собирает все пары с одним ключом у одного reducer, поэтому ключом делают user_id. Один mapper выдаёт URL просмотра с ключом user_id, другой — дату рождения с тем же ключом.
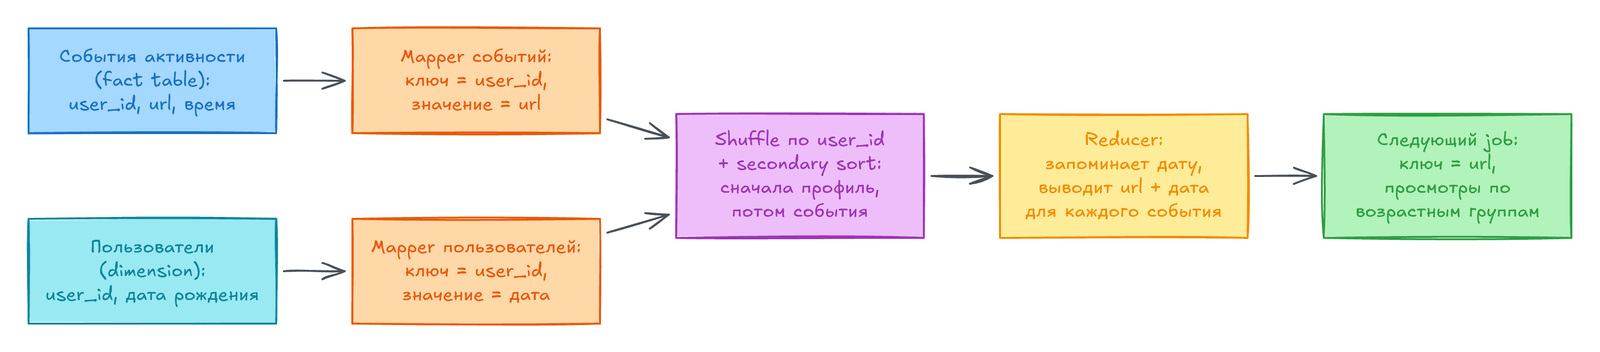
Job может упорядочить записи так, что reducer видит сначала профиль, а потом события по времени. Это secondary sort. Reducer запоминает дату рождения и выдаёт каждый URL вместе с ней. В памяти лежит одна запись пользователя, и сетевых запросов нет. Такой алгоритм называют sort-merge join: выход mapper отсортирован, а reducer сливает отсортированные списки обеих сторон.
Следующий job делает shuffle по URL и для каждой страницы считает просмотры по возрастным группам. Так реализуются group by и агрегация.
Языки запросов
Заголовок раздела «Языки запросов»Движки уже надёжно обрабатывают петабайты на кластерах из более чем 10 000 машин, поэтому внимание перешло к модели программирования. MapReduce, dataflow engine и облачные хранилища данных приняли SQL как общий язык. Его знают все, его поддерживают инструменты аналитики и ETL, а код выходит короче рукописного MapReduce. SQL позволяет и работать интерактивно: аналитики, продакт-менеджеры и финансисты исследуют данные запросами.
SQL помогает не только людям: с ним и машины выполняют jobs эффективнее. Движок переводит запрос в синтаксическое дерево, затем в физические операторы, и по пути оптимизирует его. Оптимизаторы по стоимости в Hive, Trino, Spark и Flink сами выбирают алгоритм join и даже меняют порядок joins, чтобы промежуточных данных было меньше.
Есть и нишевые языки. Apache Pig описывал pipeline шаг за шагом, а не одним большим SQL-запросом, похожим путём идут DataFrame и язык Morel. Для JSON есть jq, JMESPath и JSONPath, для графов (см. главу 3) — Gremlin из Apache TinkerPop.
Сближение пакетной обработки и облачных хранилищ данных
Заголовок раздела «Сближение пакетной обработки и облачных хранилищ данных»Раньше хранилища данных работали на специальных комплексах и выполняли SQL. MapReduce давал масштаб и гибкость: код на любом языке и любые форматы. Со временем хранилища и фреймворки сблизились. Фреймворки выучили SQL и быстро выполняют его благодаря Parquet и оптимизированным движкам (см. главу 4). Хранилища данных переехали в облако и переняли планирование, отказоустойчивость и shuffle. Фреймворки взяли SQL, а хранилища в ответ взяли другие модели обработки: у BigQuery есть DataFrame, Snowpark в Snowflake работает с Pandas, а Airflow, Prefect и Dagster интегрированы с хранилищами.
Не всё легко выразить на SQL: итеративные графовые алгоритмы вроде PageRank, сложное ML, изображения, видео и звук для AI. Облачные хранилища данных медленнее на построчных вычислениях по колоночным данным и обычно дороже, поэтому большие jobs бывает выгоднее запускать в Spark или Flink. Выбор зависит от стоимости, удобства и доступности. У крупных компаний много систем, а небольшие часто обходятся одной.
DataFrames
Заголовок раздела «DataFrames»Data scientists привыкли к DataFrame из R и Pandas. DataFrame похож на таблицу: набор строк, где значения одного столбца одного типа. Вместо большого SQL-запроса пользователь вызывает функции: фильтр, join, сортировку, агрегацию.
Сначала DataFrame жили в памяти одной машины. Чтобы работать с большими данными через привычный API, Spark, Flink и Daft добавили свои DataFrame. Но локальные DataFrame обычно индексированы и упорядочены, а распределённые — нет, поэтому при переходе на распределённый фреймворк скорость может неприятно удивить. Pandas выполняет операцию сразу, а Spark сначала строит план запроса, оптимизирует его и только потом выполняет. Daft считает мелкие операции на клиенте, а большие — на сервере, и общий колоночный формат Apache Arrow связывает обе стороны.
Где применяют пакетную обработку
Заголовок раздела «Где применяют пакетную обработку»Batch jobs хороши для больших объёмов, но не для малой задержки. Их используют там, где данных много, а свежесть не критична: сверка бухгалтерии и складов, прогноз спроса, обучение рекомендательных моделей, финансовые системы. Например, банковская сеть США почти целиком работает на batch jobs.
ETL и ELT (см. главу 1) извлекают данные из рабочей базы, преобразуют и загружают в другую систему, часто в хранилище данных. Фильтры, выбор полей и многие другие преобразования распараллеливаются тривиально («embarrassingly parallel»), поэтому batch jobs здесь удобны. Планировщики workflow повторяют упавший job, а job, который падает снова и снова, помечают, и инженер сразу видит, где сломался pipeline. В Airflow есть готовые операторы для MySQL, PostgreSQL, Snowflake, Spark и десятков других систем.
Batch jobs легко отлаживать: файлы упавшего job можно открыть, а job исправить и перезапустить. Например, если во входе нет нужного поля, инженер данных быстро это заметит и поправит логику.
Раньше pipeline вела одна команда инженеров данных. Теперь инструменты стали проще, и команды по всей компании ведут свои pipeline сами, а практики data mesh, data contract и data fabric помогают им безопасно публиковать данные. ETL и аналитика всё чаще идут в одном движке, например в SparkSQL, Trino или DuckDB. Из-за этого стирается граница между разработкой, инженерией данных, analytics engineering и бизнес-анализом.
Аналитика
Заголовок раздела «Аналитика»Аналитические запросы (OLAP) сканируют много записей и агрегируют их, и их можно запускать в системе пакетной обработки. Аналитики пишут SQL, движок читает файлы из DFS или S3, а метаданные таблиц ведут табличные форматы вроде Apache Iceberg и каталоги вроде Unity. Такую архитектуру называют lakehouse. Запросы бывают двух видов:
| Вид | Как работает |
|---|---|
| Предварительная агрегация | Данные по расписанию сворачивают в OLAP-кубы или витрины (см. главу 4) и читают в хранилище или в Apache Druid и Pinot |
| Запросы ad hoc | Ответы на бизнес-вопросы и отладка. Аналитик задаёт запросы один за другим, поэтому важна скорость ответа |
Через SQL фреймворки подключаются к инструментам визуализации: Tableau, Power BI, Looker и Apache Superset. Например, Superset работает с Trino, Hive и Spark SQL, а те для ответа на запрос запускают batch jobs.
Машинное обучение
Заголовок раздела «Машинное обучение»ML-инженеры используют пакетную обработку в трёх задачах:
feature engineering— превращение сырых данных в признаки, например текста в числа;- обучение — данные служат входом job, а веса модели — выходом;
batch inference— предсказания сразу для большого набора, в том числе оценка модели на тестовых данных.
Для этого есть MLlib в Spark и FlinkML во Flink. Рекомендательные системы и ранжирование много работают с графами: алгоритм идёт по одному ребру за шаг и повторяет шаги, пока метрика не сойдётся. Для этого популярна модель bulk synchronous parallel (BSP), или Pregel: её реализуют Apache Giraph, GraphX в Spark и Gelly во Flink.
Пакетная обработка нужна и для больших языковых моделей. Сырой текст сайтов лежит в DFS или S3. Перед обучением его готовят: извлекают текст из HTML, удаляют некачественные документы и дубликаты, разбивают на токены и превращают в embedding — числовые представления слов. Для этого созданы Kubeflow, Flyte и Ray; OpenAI, например, использует Ray при обучении ChatGPT. Эти фреймворки интегрированы с PyTorch и TensorFlow и поддерживают обучение, batch inference и fine-tuning. Наконец, data scientists работают в ноутбуках вроде Jupyter и Hex, которые запускают batch jobs через DataFrame или SQL.
Выдача производных данных
Заголовок раздела «Выдача производных данных»Batch jobs строят производные данные: рекомендации, отчёты, признаки для ML. Пользователи получают их из рабочей базы, key-value-хранилища или поискового движка, поэтому данные нужно туда перенести.
Писать из job прямо в базу запись за записью — плохая идея по трём причинам:
- сетевой запрос на каждую запись снижает скорость на порядки по сравнению с обычным
throughputbatch-задачи; - много параллельных задач легко перегрузят базу, а это ударит по запросам пользователей и другим системам;
- batch job гарантирует «всё или ничего»: при успехе выход такой, будто каждая задача выполнилась ровно раз, при сбое выхода нет. Запись во внешнюю систему — видимый побочный эффект: другие увидят результат недоделанного job, а перезапущенная задача может записать данные повторно.
Лучше отправлять готовые данные в поток, например в topic Kafka (см. главу 12). Elasticsearch, Pinot, Druid, Venice и ClickHouse умеют сами читать Kafka. Поток хорошо переносит массовую последовательную запись и служит буфером: получатели сами выбирают скорость чтения. Выход одного job могут читать несколько систем, а поток в демилитаризованной зоне (DMZ) отделяет batch-окружение от рабочей сети. Но «всё или ничего» поток сам не даёт. Для этого job в конце сообщает, что данные готовы, а получатели до этого прячут их от запросов, как незафиксированную транзакцию при read committed (см. главу 8).
При первичном заполнении базы чаще делают иначе: job строит готовые файлы базы, а их массово загружают (bulk load). Так умеют Lightning в TiDB, импорт в Apache Pinot, загрузка SST-файлов в RocksDB. Это очень быстро и позволяет атомарно переключиться на новую версию данных, но инкрементальные обновления так делать трудно. Поэтому, когда нужны и первичная загрузка, и инкрементальные обновления, часто берут гибрид: Venice поддерживает и построчные обновления, и полную замену набора.
Итоги главы
Заголовок раздела «Итоги главы»Batch jobчитает неизменяемый вход и строит выход с нуля, поэтому ошибки исправляют перезапуском.- Сортировка масштабируется на данные больше памяти, а хеш-таблица хороша при малом рабочем наборе.
- Распределённый фреймворк похож на ОС: хранилище (DFS или S3), оркестратор и слой вычислений.
- Объектные хранилища вытесняют DFS, но у них нет каталогов, атомарного переименования и изменения объекта на месте.
- Оптимальное распределение ресурсов — NP-трудная задача, поэтому планировщики используют эвристики.
Dataflow engineвроде Spark и Flink почти вытеснил MapReduce: весьworkflowу него — один job с промежуточными данными в памяти.Shuffle— распределённая сортировка, на которой построены joins (sort-merge join) и агрегации.- SQL и
DataFrameсделали пакетную обработку доступнее и дали движку оптимизировать запросы. - Основные применения: ETL, аналитика, ML и выдача производных данных через поток или
bulk load.
Ключевые термины
Заголовок раздела «Ключевые термины»| Термин | Значение |
|---|---|
batch job | Задача, которая читает неизменяемый вход и строит выход с нуля |
DFS | Распределённая файловая система: блоки файлов на многих машинах |
| Объектное хранилище | S3 и аналоги: неизменяемые объекты по ключу в bucket |
| Оркестратор | Kubernetes, YARN: запускает task на узлах |
gang scheduling | Все задачи job стартуют только вместе |
Вытеснение (preemption) | Планировщик убивает задачу ради другой |
workflow | DAG jobs, где выход одного — вход другого |
mapper / reducer | Извлекает ключ и значение / обрабатывает все значения одного ключа |
dataflow engine | Движок, который выполняет весь workflow как один job |
shuffle | Распределённая сортировка: один ключ — один reducer |
sort-merge join | Обе стороны сортируют по ключу, reducer сливает их |
lakehouse | SQL-движок над файлами в объектном хранилище с табличным форматом |
Что это значит на практике
Заголовок раздела «Что это значит на практике»- Делайте jobs идемпотентными: вход не меняется, результат пишется целиком и заменяет прежний. Тогда перезапуск безопасен.
- Не пишите из задач в рабочую БД запись за записью. Готовьте файл или снимок и загружайте целиком с атомарным переключением или отправляйте данные через Kafka с сигналом о конце job.
- Выбирайте join по данным: маленькую таблицу измерений можно раздать всем задачам (broadcast), а для двух больших нужен общий ключ
sharding. Следите за перекосом (skew): смотрите на самую медленнуюtask. - Spark и Flink обычно быстрее MapReduce. Они пересчитывают потерянные данные, поэтому убирайте недетерминизм: время, random без seed, порядок hash table.
- Храните сырые данные неизменяемыми (
data lake). Моделирование делайте отдельным шагом. Тогда ошибку в трансформации можно исправить пересчётом. - Для зависимостей между jobs нужен планировщик
workflow(Airflow, Dagster, Prefect). Метаданные оshardingи сортировке ведите в каталоге. - Запускайте несрочные jobs на
spot instance, но так, чтобы задачи спокойно перезапускались. - Не считайте переименование «каталога» в S3 атомарным: для атомарной публикации данных используйте табличный формат вроде Iceberg.
Практика в DuckDB
Заголовок раздела «Практика в DuckDB»Запустите duckdb в терминале или откройте shell.duckdb.org. Блоки идут по порядку. DuckDB сам распараллеливает GROUP BY и JOIN, а мы посмотрим на них глазами MapReduce.
Шаг 1. Создаём пользователей и просмотры
Заголовок раздела «Шаг 1. Создаём пользователей и просмотры»CREATE TABLE users ASSELECT * FROM (VALUES (1, DATE '1999-03-14'), (2, DATE '1985-07-02'), (3, DATE '2003-11-20'), (4, DATE '1972-01-09'), (5, DATE '1995-05-30'), (6, DATE '1988-09-17')) AS t(user_id, birth_date);
CREATE TABLE page_views ASSELECT i AS event_id, (i * 7 + i // 4) % 6 + 1 AS user_id, ['/', '/blog/kafka.html', '/blog/spark.html'][(i * 5 + i // 3) % 3 + 1] AS url, TIMESTAMP '2025-06-27 17:00:00' + INTERVAL (i) MINUTE AS tsFROM generate_series(1, 40) AS g(i);Шаг 2. Проверяем
Заголовок раздела «Шаг 2. Проверяем»У каждого просмотра должен быть пользователь, иначе join потеряет строки.
SELECT (SELECT count(*) FROM users) AS users, (SELECT count(*) FROM page_views) AS views, (SELECT count(*) FROM page_views v WHERE NOT EXISTS (SELECT 1 FROM users u WHERE u.user_id = v.user_id)) AS orphan_views;┌───────┬───────┬──────────────┐│ users │ views │ orphan_views ││ int64 │ int64 │ int64 │├───────┼───────┼──────────────┤│ 6 │ 40 │ 0 │└───────┴───────┴──────────────┘Задания
Заголовок раздела «Задания»1. Самые популярные страницы. Повторите цепочку sort | uniq -c | sort -r -n | head одним запросом.
Решение
SELECT url, count(*) AS viewsFROM page_viewsGROUP BY urlORDER BY views DESC, urlLIMIT 3;┌──────────────────┬───────┐│ url │ views ││ varchar │ int64 │├──────────────────┼───────┤│ /blog/kafka.html │ 14 ││ / │ 13 ││ /blog/spark.html │ 13 │└──────────────────┴───────┘GROUP BY url — это map (ключ = URL), shuffle и reduce (count). ORDER BY ... LIMIT — второй MapReduce job, который ранжирует результат.
2. Возраст аудитории по страницам. Соедините просмотры с профилями и посчитайте просмотры каждой страницы по группам «младше 30» и «30 и старше» на 27 июня 2025 года.
Решение
SELECT url, CASE WHEN birth_date > DATE '1995-06-27' THEN 'младше 30' ELSE '30 и старше' END AS age_group, count(*) AS viewsFROM page_views vJOIN users u USING (user_id)GROUP BY ALLORDER BY url, age_group;┌──────────────────┬─────────────┬───────┐│ url │ age_group │ views ││ varchar │ varchar │ int64 │├──────────────────┼─────────────┼───────┤│ / │ 30 и старше │ 10 ││ / │ младше 30 │ 3 ││ /blog/kafka.html │ 30 и старше │ 7 ││ /blog/kafka.html │ младше 30 │ 7 ││ /blog/spark.html │ 30 и старше │ 9 ││ /blog/spark.html │ младше 30 │ 4 │└──────────────────┴─────────────┴───────┘Это два job из книги в одном запросе: join по user_id и группировка по URL. Главную страницу смотрят в основном пользователи 30 лет и старше.
3. Раздача ключей по reducer. Раздайте записи трём reducer по правилу user_id % 3 (настоящий shuffle берёт хеш ключа). Проверьте, что все записи одного пользователя попадают к одному reducer.
Решение
SELECT user_id % 3 AS reducer, count(*) AS records, count(DISTINCT user_id) AS keys, list_sort(list(DISTINCT user_id)) AS user_idsFROM page_viewsGROUP BY reducerORDER BY reducer;┌─────────┬─────────┬───────┬──────────┐│ reducer │ records │ keys │ user_ids ││ int64 │ int64 │ int64 │ int64[] │├─────────┼─────────┼───────┼──────────┤│ 0 │ 14 │ 2 │ [3, 6] ││ 1 │ 13 │ 2 │ [1, 4] ││ 2 │ 13 │ 2 │ [2, 5] │└─────────┴─────────┴───────┴──────────┘Каждый пользователь стоит ровно в одной строке, значит, все его записи достались одному reducer. Нагрузка ровная: 14, 13 и 13 записей.
Вопросы для самопроверки
Заголовок раздела «Вопросы для самопроверки»- Почему неизменяемый вход делает batch job устойчивым к ошибкам в коде, а база с транзакциями так не умеет?
- Когда хеш-таблица в памяти лучше сортировки, а когда выигрывает сортировка?
- Чем объектное хранилище отличается от DFS? Почему переименование «каталога» в S3 опасно?
- Почему
gang schedulingи вытеснение снижают загрузку кластера? Зачем batch jobs запускают наspot instance? - Как
shuffleгарантирует, чтоreducerувидит все записи одного ключа, и как на этом строитсяsort-merge join? - Почему не стоит писать выход batch job прямо в рабочую базу и что делать вместо этого?
Предыдущая: Согласованность и консенсус. Следующая: Потоковая обработка.